
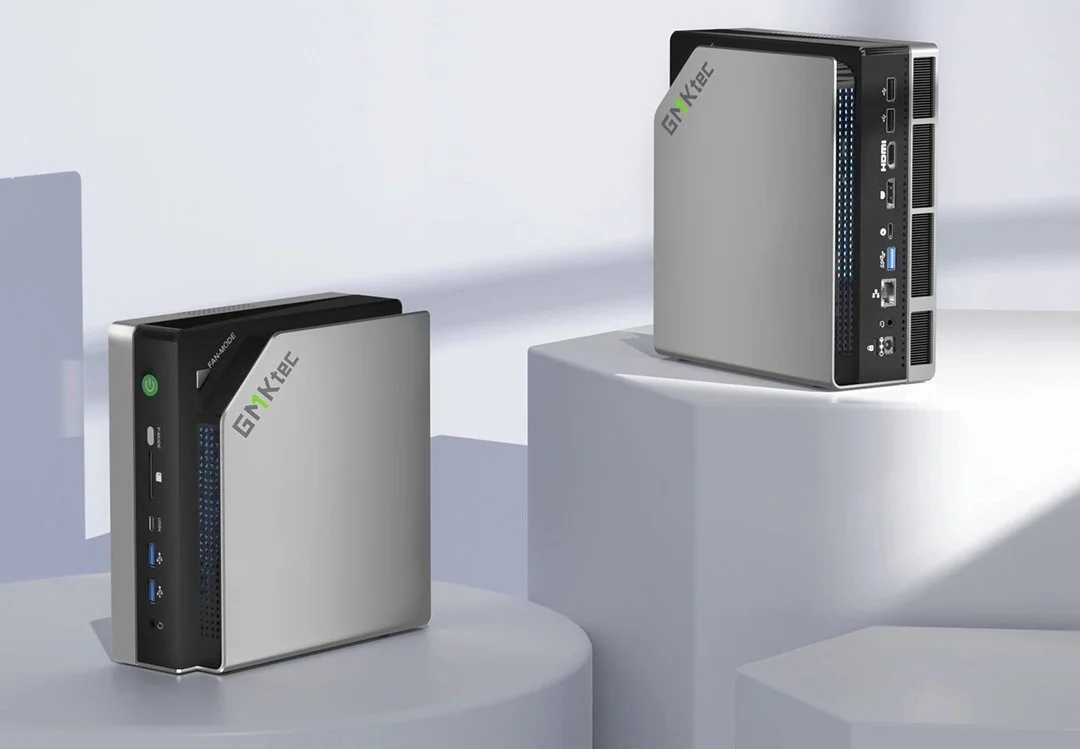
这个故事有一个版本值得毫无保留地讲出来,因为这一次营销口号恰好与硬件的实际表现相符:一台精装书大小的迷你主机,如今已能把一个 700 亿参数的语言模型完整装入内存,并实时回答你的问题。这台机器就是 GMKtec 的 EVO-X2,它基于 AMD 的 Ryzen AI Max+ 395,也就是业界所称的 Strix Halo 芯片。它并不是运行 70B 模型最快的方式,但在这种外形尺寸下,它是运行 70B 模型最便宜的方式,而且领先幅度足够显著。正是这一点,重新设定了整个品类中其他产品的预期。
GMKtec EVO-X2 的内部配置
Ryzen AI Max+ 395 将 16 核 Zen 5 CPU 与基于 40 个 RDNA 3.5 计算单元的 Radeon 8060S 集成显卡相结合,另有一颗 50 TOPS 的 XDNA 2 NPU。最关键的是,它支持最高 128 GB LPDDR5X-8000 统一内存,三个计算引擎都可以将其作为同一个内存池来访问。NotebookCheck 在 EVO-X2 完整评测中称其为“2025 年最佳迷你主机之一”,并指出机身在持续负载下仍相对凉爽安静。Tom’s Hardware 也得出了类似的结论,将 EVO-X2 定位为“小巧的 Strix Halo 性能猛兽”,认为它的吸引力与其说在于峰值速度,不如说在于它所处的体积级别。
统一内存这一点,正在悄然重新定义可能性的边界。直到不久之前,在本地运行 70B 级模型只有两条路:一台配备 24 GB 显存的 RTX 4090 台式机(这会迫使你降到 Q3 量化,并大量卸载到 CPU),或者一台配备 192 GB 统一内存、起售价约 $5,599 的 Apple Mac Studio M2 Ultra。Strix Halo 平台在这两者之下插入了第三种选择。
70B 的真实数据
多个独立基准测试帖(Level1Techs 持续更新的 Strix Halo LLM 测试汇总、Framework Desktop 社区的 GPU LLM 测试,以及 Hardware Corner 一篇严谨的优化文章)得出了形态一致的结果。在 Q4–Q6 量化的稠密 Llama 3.3 70B 上,当模型完全驻留在集成显卡上时,Strix Halo 大约处于 3–5 tokens/s 区间;个别基准测试帖报告,通过 GPU 卸载运行 Llama 3.3 70B Q6_K 约为 3.7–3.8 t/s。
这并不快。不过,它稳稳落在 3–5 t/s 区间之内,而本地 LLM 社区通常把这个区间视为可用交互式聊天的下限。而且这个平台的上限并非随意设定:Hardware Corner 通过逐步推算表明,一个 42 GB 的稠密模型在该芯片实测约 215 GB/s 的内存带宽下,理论上限为 5.1 t/s,而实际运行达到了 4.8 t/s,约为 带宽上限的 94%。不会有哪个软件更新能让稠密 70B 的这些数字翻倍。带宽就是那堵墙。
Strix Halo 真正施展拳脚的地方,是较新的 混合专家(Mixture-of-Experts) 架构,这类模型每个 token 只激活一小部分权重。Hardware Corner 的测试和 Level1Techs 的帖子都报告 Qwen3-30B-A3B 约为 52 t/s,同一硬件还能轻松承载 100 GB 以上、消费级独立显卡根本装不下的 MoE 模型。比起稠密 70B 的数据,这才是 Strix Halo 真正为之打造的工作负载。
横向对比
坦白地比较一下:根据已公开的 GPU-Benchmarks-on-LLM-Inference 测试结果,Mac Studio M2 Ultra 192 GB 运行 Llama 2 70B Q4_K_M 约为 12 t/s,这得益于 800 GB/s 的内存带宽,约为 Strix Halo 的 3.7×。RTX 4090 台式机的 24 GB 显存带宽超过 1 TB/s,但无法在不卸载的情况下装下完整的 Q4 70B 模型,而一旦卸载,带宽优势便荡然无存。每个档位都代表着真实的工程取舍。
EVO-X2 改变讨论格局的地方在于价格。NotebookCheck 和 GMKtec 自己的产品页显示,64 GB 基础款售价 $1,499,96 GB 配置为 $1,799,128 GB 版本(唯一适合 70B 工作的版本)为 $1,999。Mac Studio M2 Ultra 192 GB 起售价为 $5,599。一台配备相当系统内存的 RTX 4090 台式机,在配齐其余部件后价格也落在相近区间,却依然无法把模型装进 GPU。对于真正目标是“在桌面上运行 70B 模型、无需租用云端 GPU”的买家来说,在这种外形尺寸下,EVO-X2 的性价比可谓前所未有。
相关阅读:我们的 GMKtec EVO-X2 评测、Framework Desktop 评测,以及我们对 Mac Mini M4 Pro 运行本地 LLM 的分析。
需要注意的地方
有三点保留意见值得与标题结论一并提出。
第一,内存带宽就是上限,而且是固定的。纸面值 256 GB/s,实际约 215 GB/s。无论软件栈如何成熟,稠密 70B 模型在这个平台上都不会快过个位数中段的 t/s 区间。期待 Mac Studio 级吞吐量的买家会失望;而与“完全无法在本地运行 70B”相比的买家则不会。
第二,在当前的 LLM 软件中,NPU 基本只是陪跑。这颗 50 TOPS 的 XDNA 2 单元是实打实的硬件,但 llama.cpp、Ollama 和 LM Studio 目前通过集成显卡而非 NPU 进行推理。这种情况是否会改变,是软件问题,而非硬件问题。Phoronix 的记录显示,该平台的 Linux 软件栈仍在积极完善中,直到 Ubuntu 26.04 仍有可量化的性能提升。
第三,如果你是冲着本地 LLM 而来,就应该买 128 GB 版本。64 GB 基础款是一台出色的迷你主机,但不是能跑 70B 的迷你主机。下单前请确认所选配置与你的工作负载相匹配。
结论
EVO-X2 并不是运行 70B 推理最快的桌面设备,任何诚实的人都不会这么说。但它是迷你主机品类中第一款真正认真的选择:一台售价 $1,999、体积 1 升的机器,能将真正的 70B 级模型装入统一内存,并在可用的时间内给出回答。在这个价位和这个尺寸上,这是前所未有的。本地 AI 的讨论一直在等待一款足够便宜的硬件,让它不再只是炫技,而开始成为工具;而装在这个机箱里的 Strix Halo,是市场迄今交付的最接近这一目标的产品。