
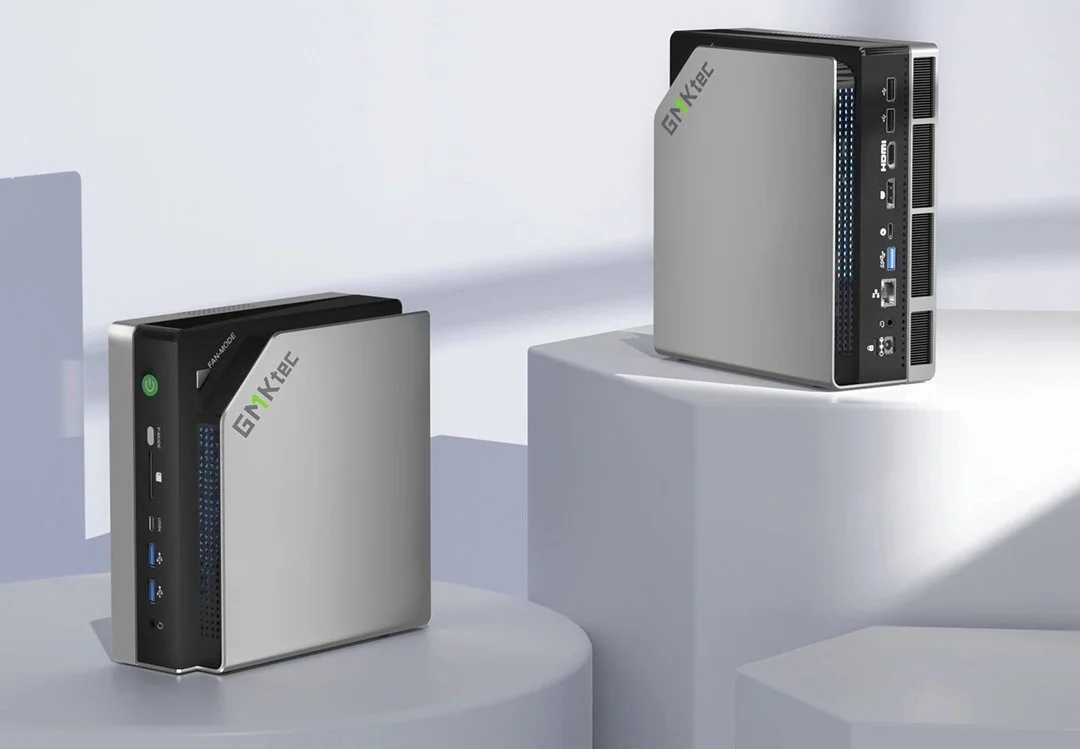
Il existe une version de cette histoire qui mérite vraiment d’être racontée sans précautions oratoires, car pour une fois le discours marketing correspond à ce que fait réellement le matériel : un mini PC de la taille d’un livre relié peut désormais loger un modèle de langage de 70 milliards de paramètres entièrement en mémoire et vous répondre en temps réel. La machine en question est l’EVO-X2 de GMKtec, construit autour du Ryzen AI Max+ 395 d’AMD, la puce que l’industrie appelle Strix Halo. Ce n’est pas la façon la plus rapide de faire tourner un modèle 70B. C’est, avec une marge qui compte, la façon la moins chère d’en faire tourner un dans ce format, et c’est cette partie de l’histoire qui redéfinit les attentes pour tout le reste de la catégorie.
Ce que renferme le GMKtec EVO-X2
Le Ryzen AI Max+ 395 associe un CPU Zen 5 à 16 cœurs à un GPU intégré Radeon 8060S doté de 40 unités de calcul RDNA 3.5, plus un NPU XDNA 2 de 50 TOPS et, point crucial, jusqu’à 128 Go de mémoire unifiée LPDDR5X-8000 que les trois moteurs peuvent adresser comme un seul et même pool. Le test complet de l’EVO-X2 par NotebookCheck qualifie le résultat de « l’un des meilleurs mini PC de 2025 », en notant que le châssis reste relativement frais et silencieux sous charge prolongée. Tom’s Hardware arrive à un verdict similaire, présentant l’EVO-X2 comme un « concentré de puissance Strix Halo compact » dont l’attrait tient moins à la vitesse de pointe brute qu’à la catégorie de taille qu’il occupe.
La mémoire unifiée est l’élément qui redéfinit discrètement le champ des possibles. Jusqu’à très récemment, faire tourner un modèle de classe 70B en local signifiait l’une de deux choses : une tour équipée d’une RTX 4090 avec 24 Go de VRAM (qui vous obligeait à descendre en quantification Q3 avec un lourd déchargement sur le CPU), ou un Apple Mac Studio M2 Ultra avec 192 Go de mémoire unifiée, à partir d’environ $5,599. La plateforme Strix Halo insère une troisième option en dessous des deux.
Les vrais chiffres en 70B
Les fils de benchmarks indépendants (le décompte continu des résultats LLM sur Strix Halo chez Level1Techs, les tests LLM sur GPU de la communauté Framework Desktop et un compte rendu d’optimisation minutieux chez Hardware Corner) convergent vers le même profil de résultats. Sur un Llama 3.3 70B dense en quantification Q4 à Q6, Strix Halo se situe à peu près dans la plage des 3 à 5 tokens par seconde lorsque le modèle réside entièrement sur l’iGPU, des publications de benchmarks individuelles faisant état d’environ 3,7 à 3,8 t/s pour Llama 3.3 70B Q6_K avec déchargement sur le GPU.
Ce n’est pas rapide. C’est toutefois confortablement à l’intérieur de la fourchette de 3 à 5 t/s que la communauté des LLM locaux considère généralement comme le plancher d’un chat interactif utilisable. Et le plafond de la plateforme n’a rien d’arbitraire : comme l’a montré Hardware Corner en déroulant le calcul, un modèle dense de 42 Go, avec la bande passante mémoire mesurée de la puce d’environ 215 Go/s, plafonne à 5,1 t/s en théorie, et les essais réels atteignent 4,8 t/s, soit environ 94 % du plafond de bande passante. Aucun correctif logiciel ne viendra doubler ces chiffres sur un 70B dense. La bande passante est le mur.
Là où Strix Halo s’épanouit, c’est sur les architectures Mixture-of-Experts plus récentes, dans lesquelles seule une fraction des poids s’active à chaque token. Les essais de Hardware Corner et le fil de Level1Techs font tous deux état d’environ 52 t/s sur Qwen3-30B-A3B, et le même matériel héberge sans peine des checkpoints MoE de plus de 100 Go qui ne tiennent tout simplement pas sur les dGPU grand public. C’est cette charge de travail, plus que le chiffre en 70B dense, pour laquelle Strix Halo a réellement été conçu.
Face à la concurrence
Pour une comparaison honnête : le Mac Studio M2 Ultra 192 Go fait tourner Llama 2 70B Q4_K_M à environ 12 t/s dans les résultats publiés de GPU-Benchmarks-on-LLM-Inference, porté par 800 Go/s de bande passante mémoire, soit environ 3,7× le chiffre de Strix Halo. Une tour équipée d’une RTX 4090 dépasse 1 To/s sur ses 24 Go de VRAM, mais ne peut pas loger un 70B complet en Q4 sans déchargement, et le déchargement anéantit l’avantage de bande passante. Chaque palier représente un vrai compromis d’ingénierie.
Là où l’EVO-X2 change la donne, c’est sur le prix. NotebookCheck et la fiche produit de GMKtec placent le modèle de base en 64 Go à $1,499, la configuration 96 Go à $1,799 et la version 128 Go (la seule qui compte pour le travail en 70B) à $1,999. Le Mac Studio M2 Ultra 192 Go démarre à $5,599. Une tour équipée d’une RTX 4090 avec une quantité de RAM système comparable atterrit dans des eaux similaires une fois le reste de la machine assemblé, et ne peut toujours pas loger le modèle sur le GPU. Pour un acheteur dont l’objectif réel est de « faire tourner un modèle 70B sur mon bureau sans louer de GPU dans le cloud », le rapport prix-capacités de l’EVO-X2 est, dans ce format, tout simplement sans précédent.
À lire aussi : notre test du GMKtec EVO-X2, le test du Framework Desktop et notre analyse du Mac Mini M4 Pro pour les LLM locaux.
Là où se cachent les astérisques
Trois réserves méritent d’accompagner le titre.
Premièrement, la bande passante mémoire est le plafond, et elle est fixe. 256 Go/s sur le papier, environ 215 Go/s en pratique. Les modèles 70B denses ne dépasseront pas quelques tokens par seconde sur cette plateforme, quelle que soit la maturité de la pile logicielle. Les acheteurs qui attendent un débit digne d’un Mac Studio seront déçus ; ceux qui comparent à « pas de 70B en local du tout » ne le seront pas.
Deuxièmement, le NPU fait surtout de la figuration avec les logiciels LLM actuels. L’unité XDNA 2 de 50 TOPS est un vrai morceau de silicium, mais llama.cpp, Ollama et LM Studio font aujourd’hui passer l’inférence par l’iGPU, et non par le NPU. Que cela change ou non relève du logiciel, pas du matériel. Phoronix a documenté que la pile Linux continue de mûrir activement pour cette plateforme, avec des gains mesurables arrivés aussi récemment qu’avec Ubuntu 26.04.
Troisièmement, la référence 128 Go est celle à acheter si les LLM locaux sont la raison de votre présence ici. Le modèle de base en 64 Go est un excellent mini PC ; ce n’est pas un mini PC pour le 70B. Assurez-vous que l’annonce correspond à l’usage avant de cliquer sur « Acheter ».
Ce qu’il faut retenir
L’EVO-X2 n’est pas le poste de travail le plus rapide pour l’inférence en 70B, et personne d’honnête ne prétend le contraire. Ce qu’il est, pour la première fois dans la catégorie des mini PC, c’est un candidat sérieux : un châssis d’un litre à $1,999 qui loge un véritable modèle de classe 70B en mémoire unifiée et répond dans un délai utilisable. Ce n’avait jamais été le cas à ce prix ni dans cette taille. Le débat sur l’IA locale attendait un matériel qui la rende suffisamment abordable pour cesser d’être un signe extérieur de richesse et devenir un outil, et Strix Halo, dans ce boîtier, est ce que le marché a livré de plus proche à ce jour.