
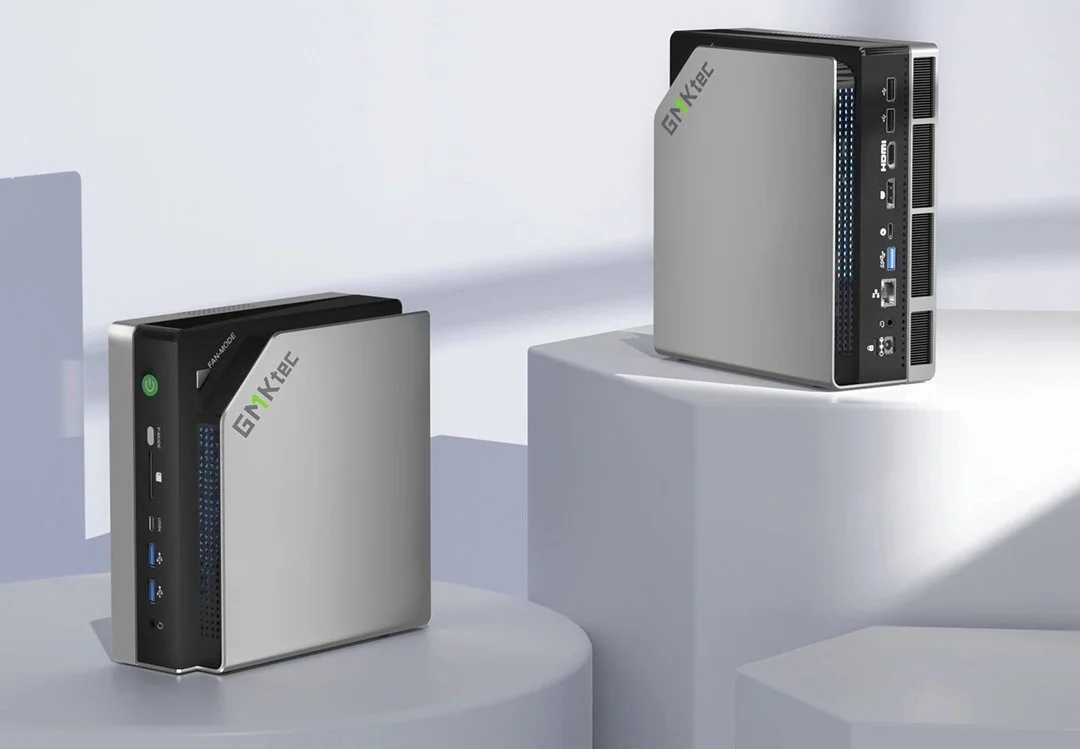
이번 이야기는 단서를 달지 않고 전해도 될 만한 버전이 있습니다. 모처럼 마케팅 문구가 하드웨어의 실제 성능과 일치하기 때문입니다. 양장본 책 크기의 미니 PC가 이제 700억 파라미터 언어 모델 전체를 메모리에 올리고 실시간으로 답할 수 있습니다. 주인공은 업계에서 Strix Halo라고 부르는 AMD Ryzen AI Max+ 395를 중심으로 만든 GMKtec의 EVO-X2입니다. 70B 모델을 실행하는 가장 빠른 방법은 아닙니다. 하지만 이 폼 팩터에서 70B 모델을 실행하는 가장 저렴한 방법이며, 그 차이는 무시할 수 없을 만큼 큽니다. 그리고 바로 이 점이 이 카테고리의 다른 모든 제품에 대한 기대치를 다시 설정합니다.
GMKtec EVO-X2의 내부 구성
Ryzen AI Max+ 395는 16코어 Zen 5 CPU에 40개의 RDNA 3.5 컴퓨트 유닛으로 구성된 Radeon 8060S 내장 GPU, 50 TOPS XDNA 2 NPU를 결합했습니다. 그리고 결정적으로, 세 엔진 모두가 하나의 풀로 접근할 수 있는 최대 128 GB의 LPDDR5X-8000 통합 메모리를 갖췄습니다. NotebookCheck는 EVO-X2 전체 리뷰에서 이 제품을 “2025년 최고의 미니 PC 중 하나”라고 평가하며, 지속 부하에서도 섀시가 비교적 시원하고 조용하게 유지된다고 언급했습니다. Tom’s Hardware도 비슷한 결론을 내렸습니다. EVO-X2를 “컴팩트한 Strix Halo 강자”로 규정하면서, 그 매력은 순수한 최고 속도보다 이 제품이 차지하는 크기 등급에 있다고 보았습니다.
통합 메모리야말로 가능성의 범위를 조용히 새로 정의하는 부분입니다. 아주 최근까지 70B급 모델을 로컬에서 실행하려면 둘 중 하나를 택해야 했습니다. 24 GB VRAM의 RTX 4090 데스크톱(이 경우 Q3 양자화로 낮추고 CPU 오프로드에 크게 의존해야 했습니다), 아니면 192 GB 통합 메모리를 갖추고 시작가가 약 $5,599인 Apple Mac Studio M2 Ultra였습니다. Strix Halo 플랫폼은 이 둘보다 아래에 세 번째 선택지를 끼워 넣습니다.
70B 실측 수치
독립 벤치마크 스레드(Level1Techs의 Strix Halo LLM 결과 집계, Framework Desktop 커뮤니티의 GPU LLM 테스트, 그리고 꼼꼼한 Hardware Corner의 최적화 글)는 같은 형태의 결과로 수렴합니다. Q4Q6 양자화의 덴스 Llama 3.3 70B에서, 모델이 iGPU에 완전히 상주할 때 Strix Halo는 대략 **초당 35토큰** 범위에 들어옵니다. 개별 벤치마크 게시물에서는 GPU 오프로드 방식의 Llama 3.3 70B Q6_K에서 약 3.7~3.8 t/s를 보고합니다.
빠르지는 않습니다. 하지만 로컬 LLM 커뮤니티가 일반적으로 실용적인 대화형 채팅의 하한선으로 보는 3~5 t/s 구간에는 넉넉히 들어옵니다. 그리고 이 플랫폼의 상한선은 임의로 정해진 것이 아닙니다. Hardware Corner가 계산 과정을 짚어 보여 줬듯이, 42 GB 덴스 모델은 이 칩의 실측 메모리 대역폭 약 215 GB/s에서 이론상 5.1 t/s가 한계이며, 실제 실행은 4.8 t/s로 **대역폭 상한의 약 94%**에 도달합니다. 덴스 70B에서 이 수치를 두 배로 끌어올릴 소프트웨어 해법은 나오지 않을 것입니다. 대역폭이 벽입니다.
Strix Halo가 진가를 발휘하는 곳은 토큰당 가중치의 일부만 활성화되는 최신 Mixture-of-Experts 설계입니다. Hardware Corner의 실행 결과와 Level1Techs 스레드 모두 Qwen3-30B-A3B에서 약 52 t/s를 보고하며, 같은 하드웨어는 소비자용 dGPU에는 아예 들어가지 않는 100 GB 이상의 MoE 체크포인트도 여유 있게 올립니다. 덴스 70B 수치보다도, 바로 이것이 Strix Halo가 실제로 겨냥해 만들어진 워크로드입니다.
경쟁 제품과의 비교
공정하게 비교하자면, 공개된 GPU-Benchmarks-on-LLM-Inference 결과에서 Mac Studio M2 Ultra 192 GB는 Llama 2 70B Q4_K_M을 약 12 t/s로 실행합니다. 800 GB/s의 메모리 대역폭 덕분으로, Strix Halo 수치의 약 3.7배입니다. RTX 4090 데스크톱은 24 GB VRAM에서 1 TB/s 이상을 내지만, 오프로드 없이는 Q4의 70B 전체를 담을 수 없고, 오프로드를 하면 대역폭 이점이 무너집니다. 각 등급은 실제 엔지니어링상의 트레이드오프를 대표합니다.
EVO-X2가 논의의 흐름을 바꾸는 지점은 가격입니다. NotebookCheck와 GMKtec 자체 제품 페이지에 따르면 64 GB 기본 모델은 $1,499, 96 GB 구성은 $1,799, 128 GB 버전(70B 작업에서 의미 있는 유일한 버전)은 $1,999입니다. Mac Studio M2 Ultra 192 GB는 $5,599부터 시작합니다. 비슷한 시스템 RAM을 갖춘 RTX 4090 데스크톱은 나머지 부품까지 갖추고 나면 비슷한 가격대에 이르지만, 여전히 모델을 GPU에 올릴 수 없습니다. “클라우드 GPU를 빌리지 않고 내 책상에서 70B 모델을 돌리는 것”이 실제 목표인 구매자에게, 이 폼 팩터에서 EVO-X2의 가격 대비 성능비는 그야말로 전례가 없습니다.
관련 글: GMKtec EVO-X2 리뷰, Framework Desktop 리뷰, 로컬 LLM용 Mac Mini M4 Pro 분석.
단서가 붙는 부분
헤드라인과 함께 알아 둬야 할 주의 사항이 세 가지 있습니다.
첫째, 메모리 대역폭이 상한선이며, 이는 고정되어 있습니다. 사양상 256 GB/s, 실사용 약 215 GB/s입니다. 소프트웨어 스택이 아무리 성숙해도 이 플랫폼에서 덴스 70B 모델은 한 자릿수 중반대 t/s보다 빨라지지 않습니다. Mac Studio급 처리량을 기대하는 구매자는 실망하겠지만, “로컬 70B가 아예 불가능한 상황”과 비교하는 구매자는 실망하지 않을 것입니다.
둘째, 현재 LLM 소프트웨어에서 NPU는 대부분 자리만 차지하고 있습니다. 50 TOPS XDNA 2 유닛은 실제로 존재하는 실리콘이지만, llama.cpp, Ollama, LM Studio는 현재 NPU가 아니라 iGPU를 통해 추론을 처리합니다. 이것이 바뀔지는 하드웨어가 아니라 소프트웨어의 문제입니다. Phoronix가 기록했듯이 이 플랫폼용 Linux 스택은 여전히 활발히 성숙해 가고 있으며, 최근 Ubuntu 26.04에서도 측정 가능한 성능 향상이 있었습니다.
셋째, 로컬 LLM이 구매 이유라면 사야 할 것은 128 GB SKU입니다. 64 GB 기본 모델은 훌륭한 미니 PC이지만 70B용 미니 PC는 아닙니다. 구매 버튼을 누르기 전에 판매 페이지의 구성이 워크로드에 맞는지 확인하십시오.
결론
EVO-X2는 70B 추론을 위한 가장 빠른 데스크톱 기기가 아니며, 정직한 사람이라면 누구도 그렇다고 주장하지 않습니다. 대신 미니 PC 카테고리에서 처음으로 등장한 진지한 선택지입니다. $1,999의 1리터 섀시가 실제 70B급 모델을 통합 메모리에 올리고 쓸 만한 속도로 답합니다. 이 가격과 이 크기에서 지금까지 없던 일입니다. 로컬 AI 논의는 과시용이 아니라 도구로 쓸 수 있을 만큼 저렴한 하드웨어를 기다려 왔고, 이 섀시에 담긴 Strix Halo는 지금까지 시장에 나온 것 중 그 목표에 가장 가까운 제품입니다.