
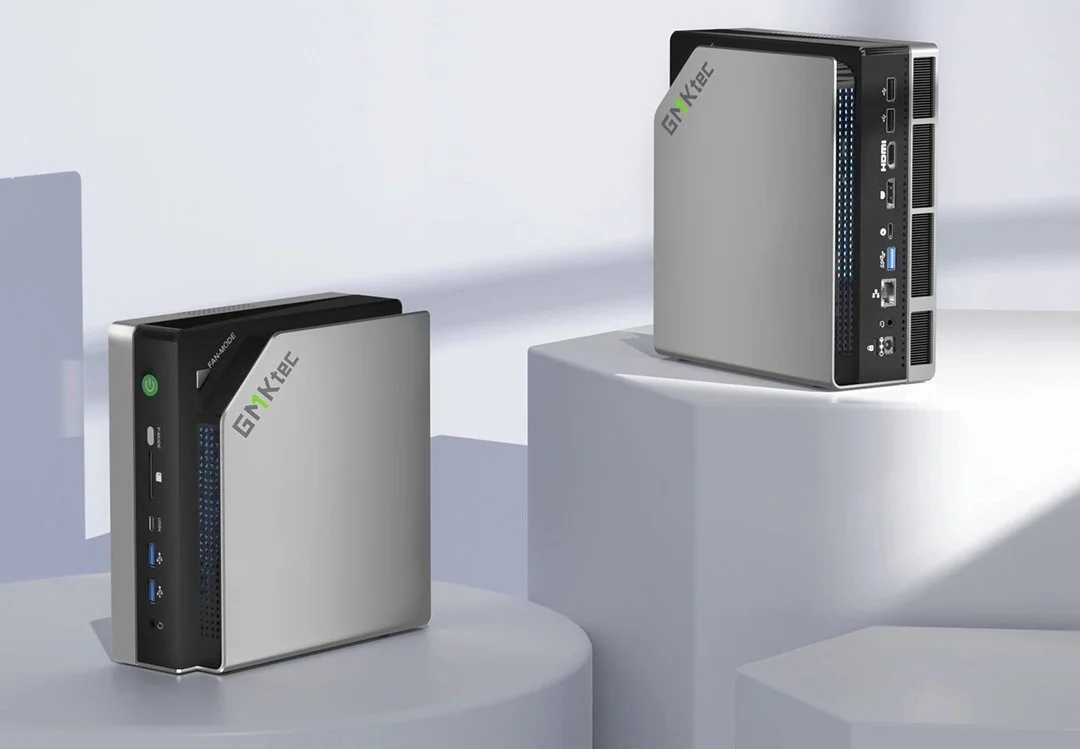
Hay una versión de esta historia que de verdad vale la pena contar sin rodeos, porque por una vez el discurso de marketing coincide con lo que el hardware realmente hace: un mini PC del tamaño de un libro de tapa dura ya puede alojar un modelo de lenguaje de 70 mil millones de parámetros por completo en memoria y responderte en tiempo real. La máquina en cuestión es el EVO-X2 de GMKtec, construido en torno al Ryzen AI Max+ 395 de AMD, el chip que la industria ha llamado Strix Halo. No es la forma más rápida de ejecutar un modelo de 70B. Es, por un margen que importa, la forma más barata de ejecutar uno en este formato, y esa es la parte de la historia que reajusta las expectativas para todos los demás en la categoría.
Qué hay dentro del GMKtec EVO-X2
El Ryzen AI Max+ 395 combina una CPU Zen 5 de 16 núcleos con una GPU integrada Radeon 8060S basada en 40 unidades de cómputo RDNA 3.5, además de una NPU XDNA 2 de 50 TOPS y, de forma crucial, hasta 128 GB de memoria unificada LPDDR5X-8000 que los tres motores pueden direccionar como un único bloque. La reseña completa del EVO-X2 de NotebookCheck calificó el resultado como “uno de los mejores mini PC de 2025” y señaló que el chasis se mantiene relativamente fresco y silencioso bajo carga sostenida. Tom’s Hardware llegó a un veredicto similar y presentó el EVO-X2 como un “compacto potente con Strix Halo” cuyo atractivo no es tanto la velocidad máxima bruta como la categoría de tamaño que ocupa.
La memoria unificada es la parte que, sin hacer ruido, redefine lo que es posible. Hasta hace muy poco, ejecutar en local un modelo de clase 70B significaba una de dos cosas: un escritorio con RTX 4090 y 24 GB de VRAM (que te obligaba a bajar a cuantización Q3 con mucha descarga a la CPU), o un Apple Mac Studio M2 Ultra con 192 GB de memoria unificada y un precio de entrada de unos $5,599. La plataforma Strix Halo introduce una tercera opción por debajo de ambas.
Las cifras reales con 70B
Los hilos de benchmarks independientes (el recuento continuo de resultados de LLM en Strix Halo de Level1Techs, las pruebas de LLM en GPU de la comunidad de Framework Desktop y un cuidadoso análisis de optimización en Hardware Corner) convergen en el mismo tipo de resultado. Con un Llama 3.3 70B denso en cuantización Q4-Q6, Strix Halo se ubica aproximadamente en el rango de 3-5 tokens por segundo cuando el modelo reside por completo en la iGPU, y publicaciones individuales de benchmarks reportan alrededor de 3.7-3.8 t/s para Llama 3.3 70B Q6_K mediante descarga a GPU.
Eso no es rápido. Sin embargo, queda cómodamente dentro de la franja de 3-5 t/s que la comunidad de LLM locales suele considerar el mínimo para un chat interactivo utilizable. Y el techo de la plataforma no es arbitrario: como demostró Hardware Corner al desarrollar los cálculos, un modelo denso de 42 GB con el ancho de banda de memoria medido del chip, de ~215 GB/s, tiene un tope teórico de 5.1 t/s, y las ejecuciones reales alcanzan 4.8 t/s, cerca del 94% del techo de ancho de banda. No viene ninguna solución de software que duplique esas cifras en un 70B denso. El ancho de banda es el muro.
Donde Strix Halo se luce es en los diseños Mixture-of-Experts más recientes, en los que solo se activa una fracción de los pesos por token. Las pruebas de Hardware Corner y el hilo de Level1Techs reportan unos 52 t/s en Qwen3-30B-A3B, y el mismo hardware aloja con holgura checkpoints MoE de más de 100 GB que simplemente no caben en las dGPU de consumo. Esa, más que la cifra del 70B denso, es la carga de trabajo para la que Strix Halo fue construido en realidad.
Cómo se compara
Para una comparación honesta: el Mac Studio M2 Ultra de 192 GB ejecuta Llama 2 70B Q4_K_M a unos 12 t/s según los resultados publicados de GPU-Benchmarks-on-LLM-Inference, impulsado por 800 GB/s de ancho de banda de memoria, unas 3.7× la cifra de Strix Halo. Un escritorio con RTX 4090 supera 1 TB/s en sus 24 GB de VRAM, pero no puede alojar un 70B completo en Q4 sin descarga, y la descarga anula la ventaja de ancho de banda. Cada nivel representa una concesión de ingeniería real.
Donde el EVO-X2 cambia la conversación es en el precio. NotebookCheck y la propia ficha de producto de GMKtec sitúan el modelo base de 64 GB en $1,499, la configuración de 96 GB en $1,799 y la versión de 128 GB (la única que importa para trabajar con 70B) en $1,999. El Mac Studio M2 Ultra de 192 GB parte de $5,599. Un escritorio con RTX 4090 y una RAM de sistema comparable termina en un terreno similar una vez que armas el resto del equipo, y aun así no puede meter el modelo en la GPU. Para un comprador cuyo objetivo real es “ejecutar un modelo de 70B en mi escritorio sin alquilar GPU en la nube”, la relación precio-capacidad del EVO-X2 es, en este formato, sencillamente inédita.
Relacionado: nuestra reseña del GMKtec EVO-X2, la reseña del Framework Desktop y nuestro análisis del Mac Mini M4 Pro para LLM locales.
Dónde están los asteriscos
Tres salvedades merecen acompañar al titular.
Primero, el ancho de banda de memoria es el techo, y es fijo. 256 GB/s en el papel, ~215 GB/s en la práctica. Los modelos densos de 70B no superarán el rango medio de un solo dígito de t/s en esta plataforma, por mucho que madure el stack de software. Quienes esperen un rendimiento de clase Mac Studio se decepcionarán; quienes lo comparen con “ningún 70B local en absoluto”, no.
Segundo, la NPU va mayormente de acompañante con el software de LLM actual. La unidad XDNA 2 de 50 TOPS es un componente de silicio real, pero llama.cpp, Ollama y LM Studio hoy envían la inferencia a través de la iGPU, no de la NPU. Que eso cambie es una cuestión de software, no de hardware. Phoronix ha documentado que el stack de Linux sigue madurando activamente para esta plataforma, con mejoras medibles que llegaron tan recientemente como en Ubuntu 26.04.
Tercero, el SKU de 128 GB es el que hay que comprar si los LLM locales son la razón por la que estás aquí. El modelo base de 64 GB es un gran mini PC; no es un mini PC para 70B. Asegúrate de que la ficha corresponda a la carga de trabajo antes de hacer clic en comprar.
La conclusión
El EVO-X2 no es el equipo de escritorio más rápido para inferencia de 70B, y nadie honesto afirma lo contrario. Lo que sí es, por primera vez en la categoría de mini PC, es uno serio: un chasis de 1 litro a $1,999 que aloja un modelo real de clase 70B en memoria unificada y responde en un tiempo utilizable. Eso no había sido cierto antes a este precio ni con este tamaño. La conversación sobre IA local llevaba tiempo esperando un hardware que la hiciera lo bastante barata como para dejar de ser un lujo para presumir y empezar a ser una herramienta, y Strix Halo, en este chasis, es lo más cercano a eso que el mercado ha lanzado hasta ahora.