
自 2024 年下半年以来发布的每一台迷你主机,规格表上都有一个两年前同一货架上还不存在的数字:TOPS。Intel 称 Lunar Lake “最高 36 TOPS”。AMD 称 Ryzen AI 300 内置的 XDNA 2 NPU “最高 50 TOPS”。Qualcomm 称 Snapdragon X Elite 的 Hexagon 为“45 TOPS”。Apple 称 M4 的 Neural Engine 为“38 TOPS”。这些都是 INT8 峰值数据,技术上都可以相互比较,也都带有浓厚的营销色彩,因为“AI 迷你主机”的买家真正该问的不是 NPU 宣称有多少 TOPS,而是这些 TOPS 如今实际加速了什么。截至 2026 年 4 月,答案比包装盒上暗示的要窄得多。
营销层面:TOPS 与 Copilot+ 门槛
迷你主机规格表上的 TOPS 数字几乎无一例外只计算 NPU。Microsoft 的 Copilot+ PC 计划将门槛设为 NPU 40 TOPS,这决定了一台机器能否搭载 Recall、Cocreator、带翻译的实时字幕和 Windows Studio Effects 等本地功能出货。AMD Ryzen AI 300 系列凭借 XDNA 2 以 50 TOPS 达标;Qualcomm Snapdragon X Elite 以 45 TOPS 达标;Intel Lunar Lake 达到 48 TOPS(AnandTech 架构深度解析)。更早的 Core Ultra 100 / 200(“Meteor Lake”和“Arrow Lake”)没有达标,被排除在 Copilot+ 品牌之外,尽管许多搭载这些芯片的机器仍在以“AI 迷你主机”的名义销售。
最尴尬的是 Apple。M4 的 Neural Engine 额定为 38 TOPS,低于 Microsoft 的门槛,但在实际负载中,M4 经常追平甚至超过标称更快的 x86 NPU(NotebookCheck Mac mini M4 Pro 评测)。这道“门槛”奖励的是数字,而不是结果。
NPU 如今实际加速什么
2026 年 4 月,在 Windows 或 Mac 迷你主机上真正运行在 NPU 上的负载只有很短的一份清单:
- Windows Studio Effects:摄像头背景虚化、眼神接触校正、语音清晰度增强、自动取景。
- Windows 11 24H2 及更高版本中的实时字幕 / 本地翻译。
- 特定应用的 AI 功能,例如 Adobe Sensei 套件中的本地部分和少数 Microsoft 365 功能,前提是厂商明确提供了 NPU 代码路径(DirectML、ONNX Runtime QNN、OpenVINO 或 Core ML)。
- 部分 Whisper / 小型 ASR 实现,前提是模型足够小,能轻松放进 NPU 的片上内存,并且运行时已经准备好量化计算图。
对普通用户来说,在一台出厂状态的 2026 年迷你主机上,能确认真正用到 NPU 的大致就是这些。
NPU(大多)不加速什么
2026 年,流行的本地 LLM 工具栈(llama.cpp、Ollama、LM Studio、KoboldCpp、text-generation-webui)运行在 CPU 和 iGPU 路径上,而不是 NPU 上。这方面确实有进展:llama.cpp 在 2024 年底合并了面向 Snapdragon Hexagon NPU 的 QNN 后端,DirectML 现在也在 Windows 上提供了 NPU 执行提供程序。但具体到 Intel 和 AMD 芯片,主流 LLM 工具仍默认使用 Vulkan/iGPU,或 CPU 上的 AVX2/AVX-512,因为 NPU 软件栈(Intel 的 OpenVINO GenAI,AMD 的 Ryzen AI Software / XDNA)要么支持的模型范围很窄,要么只支持特定的量化格式。
图像生成也是同样的情况。在 2026 年的迷你主机上,Stable Diffusion XL 和 Flux 运行在 iGPU(Intel Arc、Radeon 880M / 890M / 8060S)上,或者越来越常见地运行在独立 eGPU 上。NPU 加速的 SDXL 存在于厂商演示和经过 Olive 优化的 ONNX 构建中,但这并不是用户安装 Automatic1111、ComfyUI 或 InvokeAI 后实际运行的东西。
各平台的实际情况
Apple Silicon(Mac mini M4 / M4 Pro)。 Neural Engine、Metal GPU 和 AMX 矩阵单元通过 MLX 和 Core ML 协同工作。对于想以最少折腾立即运行 7B-13B LLM 的买家,在我们看来,配备 48-64 GB 统一内存的 Mac mini M4 Pro 是市面上最好的主流方案:内存带宽高,工具链成熟,运行时统一。
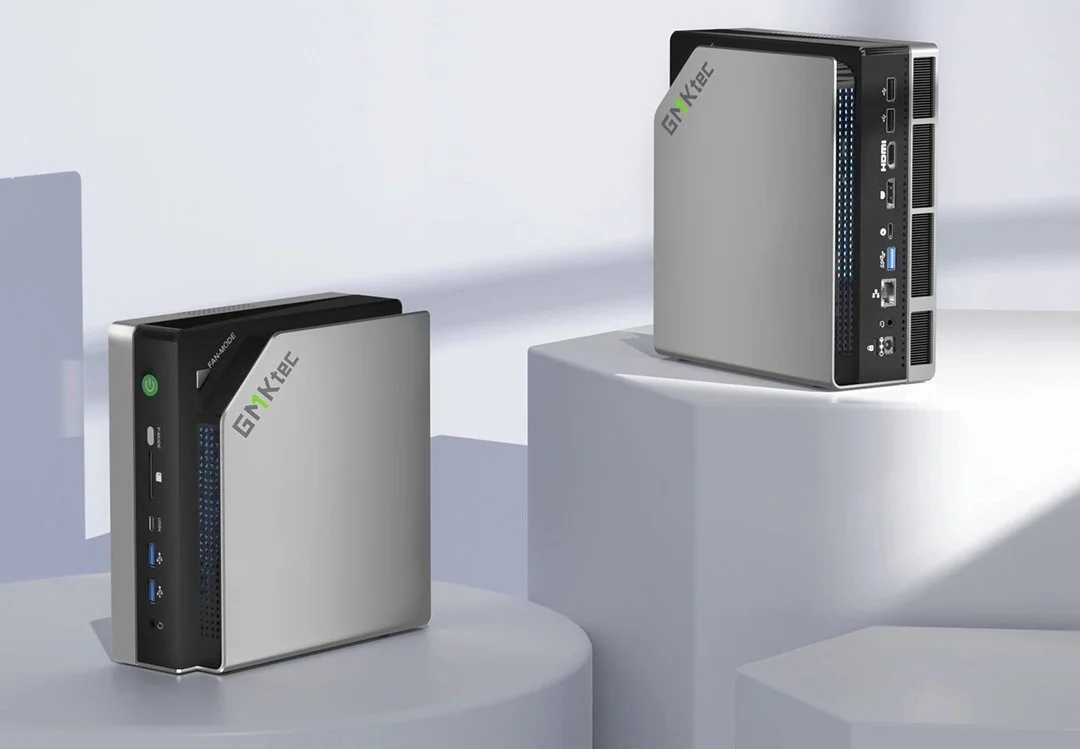
AMD Ryzen AI / Ryzen AI Max+(“Strix Halo”)。 在这些芯片上跑 LLM 的主力是 ROCm 或 Vulkan 下的 Radeon iGPU(780M、8060S),而不是 XDNA 2 NPU。NPU 纸面参数亮眼,会在 Studio Effects 和少量厂商演示中派上用场,但在 2026 年 4 月的通用 LLM 推理中,它大多处于闲置状态。Strix Halo 的优势在于统一内存:Phoronix 和 ServeTheHome 都已证明,一台 128 GB 的 Strix Halo 主机(例如 GMKtec EVO-X2)能运行那些以 NPU 为卖点的中端迷你主机根本无法加载的模型。
Intel Core Ultra(Lunar Lake / Arrow Lake-H)。 OpenVINO 确实支持 LLM,但 Ollama、LM Studio 和 llama.cpp 都优先通过 SYCL/Vulkan 使用 Arc iGPU,或者使用 CPU。在 ASUS ROG NUC 14 Performance 上,NPU 负责 Studio Effects 和少数 UWP 功能;你实际加载的 LLM 运行在 Arc 图形单元上。
Snapdragon X Elite(Hexagon NPU)。 这是唯一一个有可靠且已合并的路径、能从主流 LLM 运行时通往 NPU 的平台:llama.cpp QNN 后端。问题在于市场份额:Snapdragon X 迷你主机只占 2026 年产品阵容中很小的一部分,而且 Windows on ARM 仍有 Intel 和 AMD 机器所没有的应用兼容性问题。
2026 年迷你主机买家真正该关注什么
如果用途是本地 LLM,2026 年 4 月实事求是的优先顺序是:内存容量,其次是内存带宽,再次是 iGPU 档次,最后才是 NPU TOPS。几个具体例子:
- 配备 64 GB 的 Apple Mac mini M4 Pro 在实际 LLM 每秒 token 数上超过大多数“50 TOPS Copilot+”迷你主机,尽管它的 NPU 额定值更低。
- 配备 128 GB 统一内存的 GMKtec EVO-X2 能加载并运行以 NPU 为卖点的中端迷你主机装不下的模型,无论 TOPS 宣传如何。
- 配备 64 GB DDR5 和约 16 TOPS NPU 的 Beelink SER8 或 Geekom A8 Max,完全足以以可用的速度运行 7B 级 LLM:干活的是 iGPU 和内存。
这种情况会改变。AMD 的 XDNA 2 软件每个版本都在进步,Microsoft 正在把 DirectML NPU 路径推向更多框架,而 Hexagon llama.cpp 后端现在已是真正的代码,而不是幻灯片。到 2027 年,NPU 加速 LLM 的局面会明显改善。
但那是 2027 年。2026 年 4 月,包装盒正面的 TOPS 数字并不是决定你的本地 LLM 快不快的那个数字。 模型要么能装进你的内存,要么装不进。iGPU 要么有可用的 Vulkan 或 ROCm 路径,要么没有。NPU 大多只负责视频通话和字幕。按这个顺序(内存、带宽、iGPU,然后才是 NPU)阅读规格表的买家,最终买到的本地 AI 迷你主机会比追逐货架上最大 TOPS 数字的买家更快。