
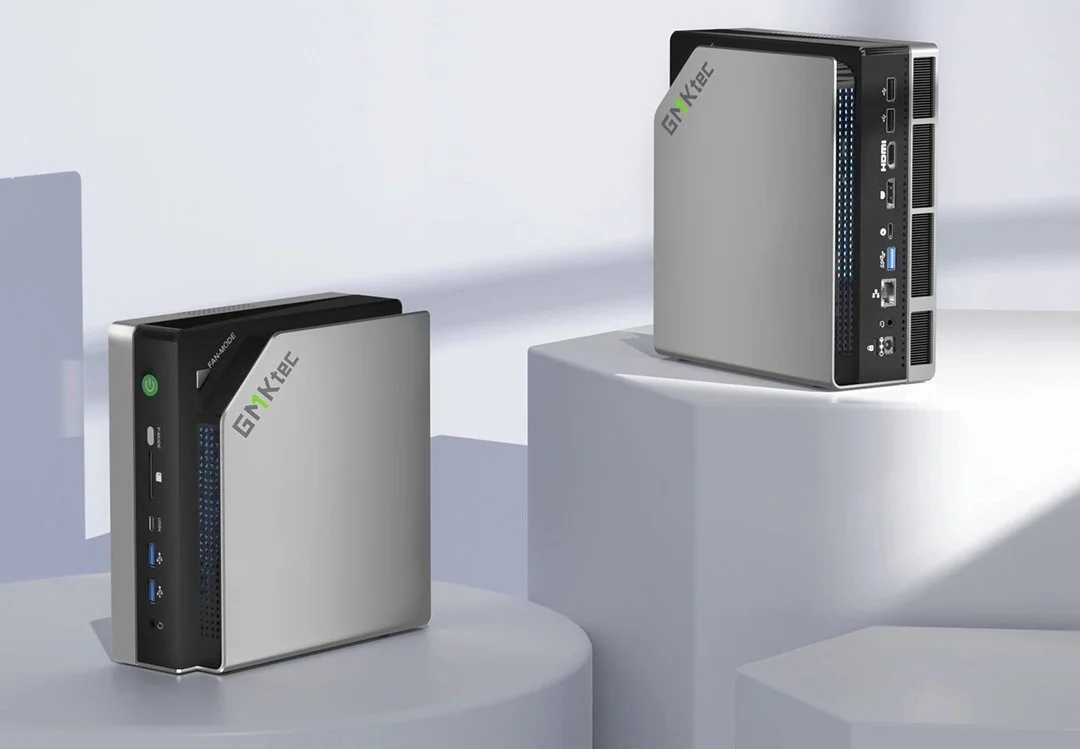
Es gibt eine Version dieser Geschichte, die sich tatsächlich ohne Relativierungen erzählen lässt, denn ausnahmsweise deckt sich die Marketingaussage mit dem, was die Hardware wirklich leistet: Ein Mini-PC in der Größe eines gebundenen Buchs kann heute ein Sprachmodell mit 70 Milliarden Parametern vollständig im Speicher halten und in Echtzeit antworten. Die Rede ist von GMKtecs EVO-X2, aufgebaut um AMDs Ryzen AI Max+ 395, den Chip, den die Branche Strix Halo nennt. Es ist nicht der schnellste Weg, ein 70B-Modell zu betreiben. Es ist aber, mit einem Abstand, der zählt, der günstigste Weg, eines in diesem Formfaktor zu betreiben, und genau dieser Teil der Geschichte setzt die Erwartungen für alle anderen in der Kategorie neu.
Was im GMKtec EVO-X2 steckt
Der Ryzen AI Max+ 395 kombiniert eine 16-Kern-CPU auf Zen-5-Basis mit der integrierten GPU Radeon 8060S, die auf 40 RDNA-3.5-Compute-Units aufbaut, dazu eine XDNA-2-NPU mit 50 TOPS und, entscheidend, bis zu 128 GB LPDDR5X-8000 Unified Memory, den alle drei Einheiten als gemeinsamen Pool ansprechen können. NotebookCheck nannte das Ergebnis in seinem ausführlichen Test des EVO-X2 „einen der besten Mini-PCs des Jahres 2025“ und hob hervor, dass das Gehäuse unter anhaltender Last vergleichsweise kühl und leise bleibt. Tom’s Hardware kam zu einem ähnlichen Urteil und beschrieb das EVO-X2 als „kompaktes Strix-Halo-Kraftpaket“, dessen Reiz weniger in der reinen Spitzenleistung liegt als in der Größenklasse, die es besetzt.
Der Unified-Memory-Aspekt ist der Teil, der still und leise neu definiert, was möglich ist. Bis vor Kurzem bedeutete der lokale Betrieb eines Modells der 70B-Klasse eines von zwei Dingen: einen Desktop mit RTX 4090 und 24 GB VRAM (der eine Q3-Quantisierung mit starkem CPU-Offload erzwang) oder ein Apple Mac Studio M2 Ultra mit 192 GB Unified Memory zum Einstiegspreis von rund $5,599. Die Strix-Halo-Plattform schiebt eine dritte Option unter beide.
Die echten Zahlen bei 70B
Unabhängige Benchmark-Threads (die laufende Sammlung von Strix-Halo-LLM-Ergebnissen bei Level1Techs, die GPU-LLM-Tests der Framework-Desktop-Community und eine sorgfältige Optimierungsanalyse bei Hardware Corner) kommen zum gleichen Ergebnisbild. Bei einem dichten Llama 3.3 70B mit Q4- bis Q6-Quantisierung landet Strix Halo bei rund 3 bis 5 Tokens pro Sekunde, wenn das Modell vollständig auf der iGPU liegt; einzelne Benchmark-Beiträge melden etwa 3,7 bis 3,8 t/s für Llama 3.3 70B Q6_K per GPU-Offload.
Schnell ist das nicht. Es liegt aber bequem innerhalb des Bereichs von 3 bis 5 t/s, den die Local-LLM-Community allgemein als Untergrenze für brauchbaren interaktiven Chat betrachtet. Und die Obergrenze der Plattform ist nicht willkürlich: Wie Hardware Corner anhand der Rechnung zeigte, kommt ein dichtes 42-GB-Modell bei der gemessenen Speicherbandbreite des Chips von ~215 GB/s auf theoretisch maximal 5,1 t/s, und reale Durchläufe erreichen 4,8 t/s, also rund 94 % der Bandbreitengrenze. Es ist kein Software-Fix in Sicht, der diese Werte bei einem dichten 70B verdoppeln wird. Die Bandbreite ist die Wand.
Seine Stärken spielt Strix Halo bei den neueren Mixture-of-Experts-Designs aus, bei denen pro Token nur ein Bruchteil der Gewichte aktiv wird. Die Messungen von Hardware Corner und der Level1Techs-Thread melden beide rund 52 t/s mit Qwen3-30B-A3B, und dieselbe Hardware nimmt problemlos MoE-Checkpoints mit über 100 GB auf, die auf Consumer-dGPUs schlicht nicht passen. Das, mehr als der Wert beim dichten 70B, ist die Arbeitslast, für die Strix Halo eigentlich gebaut wurde.
Wie es sich im Vergleich schlägt
Zum ehrlichen Vergleich: Das Mac Studio M2 Ultra mit 192 GB schafft Llama 2 70B Q4_K_M laut veröffentlichten GPU-Benchmarks-on-LLM-Inference-Ergebnissen mit rund 12 t/s, getragen von 800 GB/s Speicherbandbreite, etwa dem 3,7-Fachen des Strix-Halo-Werts. Ein Desktop mit RTX 4090 kommt auf seinen 24 GB VRAM auf über 1 TB/s, kann ein vollständiges 70B bei Q4 aber nicht ohne Offloading halten, und Offloading lässt den Bandbreitenvorteil in sich zusammenfallen. Jede Stufe steht für einen echten technischen Kompromiss.
Wo das EVO-X2 die Diskussion verschiebt, ist der Preis. NotebookCheck und GMKtecs eigene Produktseite nennen für das Basismodell mit 64 GB $1,499, für die 96-GB-Konfiguration $1,799 und für die 128-GB-Version (die einzige, die für 70B-Arbeit zählt) $1,999. Das Mac Studio M2 Ultra mit 192 GB beginnt bei $5,599. Ein Desktop mit RTX 4090 und vergleichbarem Arbeitsspeicher landet in ähnlichen Regionen, sobald man den Rest des Systems aufbaut, und kann das Modell trotzdem nicht auf der GPU unterbringen. Für Käufer, deren eigentliches Ziel lautet, „ein 70B-Modell auf dem eigenen Schreibtisch auszuführen, ohne Cloud-GPUs zu mieten“, ist das Verhältnis von Preis zu Leistungsfähigkeit beim EVO-X2 in diesem Formfaktor schlicht beispiellos.
Siehe auch: unser Test des GMKtec EVO-X2, der Test des Framework Desktop und unser Blick auf den Mac Mini M4 Pro für lokale LLMs.
Wo die Einschränkungen liegen
Drei Vorbehalte gehören zur Schlagzeile dazu.
Erstens: Die Speicherbandbreite ist die Obergrenze, und sie ist fix. 256 GB/s auf dem Papier, ~215 GB/s in der Praxis. Dichte 70B-Modelle werden auf dieser Plattform nicht über den mittleren einstelligen t/s-Bereich hinauskommen, egal wie weit der Software-Stack reift. Wer Durchsatz auf Mac-Studio-Niveau erwartet, wird enttäuscht sein; wer mit „gar kein lokales 70B“ vergleicht, nicht.
Zweitens ist die NPU bei heutiger LLM-Software größtenteils nur Passagier. Die XDNA-2-Einheit mit 50 TOPS ist echtes Silizium, aber llama.cpp, Ollama und LM Studio leiten die Inferenz derzeit über die iGPU, nicht über die NPU. Ob sich das ändert, ist eine Frage der Software, nicht der Hardware. Phoronix hat dokumentiert, dass der Linux-Stack für diese Plattform noch aktiv reift, mit messbaren Zugewinnen, die zuletzt mit Ubuntu 26.04 kamen.
Drittens: Die 128-GB-SKU ist die richtige Wahl, wenn lokale LLMs der Grund sind, aus dem Sie hier sind. Das 64-GB-Basismodell ist ein großartiger Mini-PC; ein 70B-Mini-PC ist es nicht. Prüfen Sie vor dem Kauf, ob das Angebot zur Arbeitslast passt.
Das Fazit
Das EVO-X2 ist nicht der schnellste Arbeitsplatz für 70B-Inferenz, und niemand, der ehrlich ist, behauptet etwas anderes. Was es dagegen ist, erstmals in der Mini-PC-Kategorie: ein ernstzunehmender Kandidat, ein 1-Liter-Gehäuse für $1,999, das ein echtes Modell der 70B-Klasse im Unified Memory hält und in brauchbarer Zeit antwortet. Das gab es zu diesem Preis und in dieser Größe bisher nicht. Die Local-AI-Debatte hat auf Hardware gewartet, die sie günstig genug macht, um kein Prestigeobjekt mehr zu sein, sondern ein Werkzeug, und Strix Halo in diesem Gehäuse ist das, was der Markt diesem Ziel bisher am nächsten gebracht hat.