
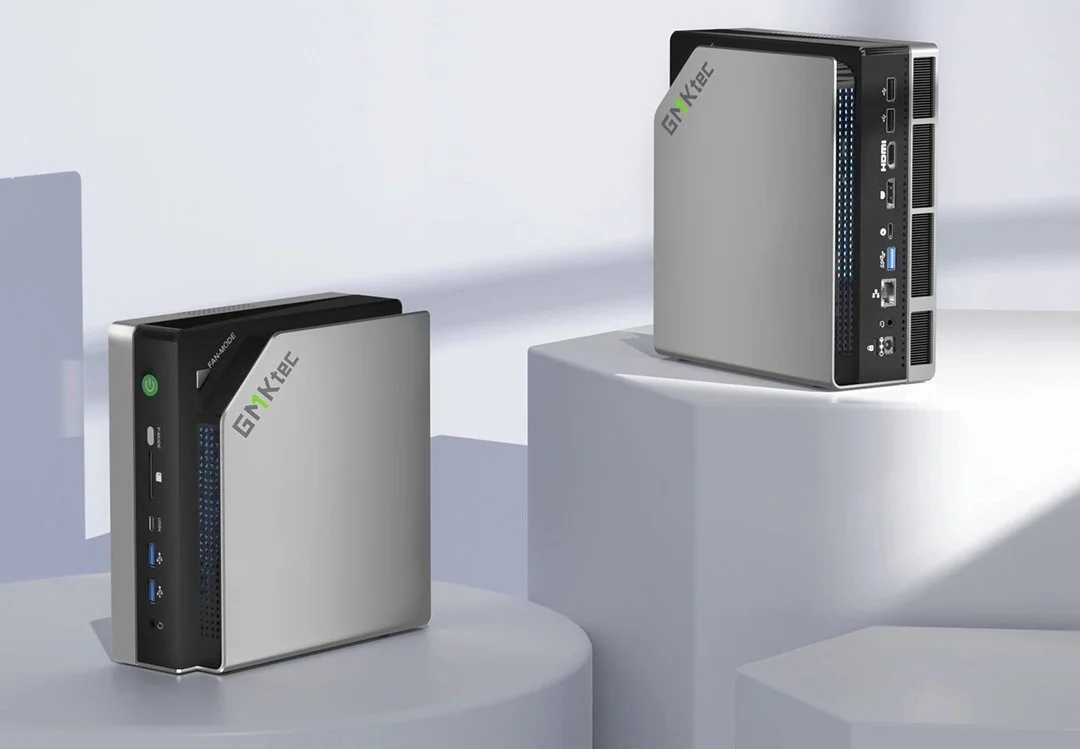
この話には、留保なしで語る価値が本当にあるバージョンがあります。今回ばかりは、マーケティングの謳い文句がハードウェアの実際の動作と一致しているからです。ハードカバーの本ほどの大きさのミニPCが、700億パラメーターの言語モデルを丸ごとメモリに載せ、リアルタイムで応答できるようになりました。そのマシンがGMKtecのEVO-X2で、業界がStrix Haloと呼んできたAMDのRyzen AI Max+ 395を中心に組まれています。70Bモデルを動かす最速の方法ではありません。しかし、このフォームファクターで70Bモデルを動かす方法としては、無視できない差をつけて最も安価です。そしてこの点こそが、このカテゴリーの他のすべての製品に対する期待値を塗り替えるのです。
GMKtec EVO-X2の中身
Ryzen AI Max+ 395は、16コアのZen 5 CPUと、40基のRDNA 3.5コンピュートユニットで構成されるRadeon 8060S内蔵GPU、さらに50 TOPSのXDNA 2 NPUを組み合わせています。そして決定的に重要なのが、この3つのエンジンすべてが単一のプールとして扱える、最大128 GBのLPDDR5X-8000ユニファイドメモリです。NotebookCheckはEVO-X2のフルレビューでこれを「2025年最高のミニPCの一つ」と評し、持続的な負荷がかかっても筐体が比較的低温かつ静かに保たれる点を挙げました。Tom’s Hardwareも同様の評価を下しており、EVO-X2を「コンパクトなStrix Haloの実力機」と位置づけ、その魅力はピーク性能そのものよりも、それを実現しているサイズクラスにあるとしています。
ユニファイドメモリという点こそが、可能なことの範囲を静かに塗り替えています。ごく最近まで、70Bクラスのモデルをローカルで動かすには2つの選択肢しかありませんでした。24 GBのVRAMを持つRTX 4090搭載デスクトップ(Q3量子化まで落とし、CPUへの大量のオフロードを強いられます)か、192 GBのユニファイドメモリを持ち約$5,599からのApple Mac Studio M2 Ultraです。Strix Haloプラットフォームは、その両方の下に3つ目の選択肢を差し込みます。
70Bでの実際の数値
独立系のベンチマークスレッド(Level1TechsによるStrix Halo LLM結果の継続的な集計、Framework DesktopコミュニティのGPU LLMテスト、そしてHardware Cornerの丁寧な最適化レポート)は、同じ傾向の結果に収束しています。Q4〜Q6量子化の高密度Llama 3.3 70Bでは、モデルがiGPU上に完全に常駐している場合、Strix Haloはおおむね毎秒3〜5トークンの範囲に収まります。個別のベンチマーク投稿では、GPUオフロードを使ったLlama 3.3 70B Q6_Kで約3.7〜3.8 t/sが報告されています。
速くはありません。しかし、ローカルLLMコミュニティが一般に対話型チャットとして使える下限とみなす3〜5 t/sの帯域には、余裕をもって収まっています。そしてこのプラットフォームの上限は恣意的なものではありません。Hardware Cornerが計算を追って示したように、42 GBの高密度モデルは、このチップの実測メモリ帯域幅約215 GB/sでは理論上5.1 t/sが上限となり、実際の実行では4.8 t/s、つまり**帯域幅の上限の約94%**に達しています。高密度の70Bでこの数値を2倍にするようなソフトウェアの修正は、今後も出てきません。帯域幅が壁なのです。
Strix Haloが本領を発揮するのは、トークンごとに重みの一部しか活性化しない、新しいMixture-of-Experts設計のモデルです。Hardware Cornerの実行結果とLevel1Techsのスレッドはどちらも、Qwen3-30B-A3Bで約52 t/sを報告しています。また同じハードウェアは、一般向けのdGPUにはそもそも収まらない100 GB超のMoEチェックポイントも余裕をもって扱えます。高密度70Bの数値以上に、これこそがStrix Haloが本来想定しているワークロードです。
他との比較
公正に比較しておきましょう。公開されているGPU-Benchmarks-on-LLM-Inferenceの結果では、Mac Studio M2 Ultra 192 GBはLlama 2 70B Q4_K_Mを約12 t/sで動かしています。これを支えるのは800 GB/sのメモリ帯域幅で、Strix Haloの数値の約3.7倍です。RTX 4090搭載デスクトップは24 GBのVRAMで1 TB/sを超える帯域幅を出しますが、オフロードなしではQ4の70Bを丸ごと保持できず、オフロードすると帯域幅の優位性は崩れてしまいます。それぞれの階層が、現実的な設計上のトレードオフを表しています。
EVO-X2が議論の流れを変えるのは価格です。NotebookCheckとGMKtec自身の製品ページによると、64 GBのベースモデルは**$1,499**、96 GB構成は**$1,799**、128 GB版(70B用途で意味を持つのはこれだけです)は**$1,999です。Mac Studio M2 Ultra 192 GBは$5,599**からです。同等のシステムRAMを備えたRTX 4090搭載デスクトップは、残りの構成を組み上げると同程度の価格帯になり、それでもモデルをGPUに収めることはできません。「クラウドGPUを借りずに、自分の机で70Bモデルを動かしたい」という目的を持つ購入者にとって、EVO-X2の価格対性能比は、このフォームファクターでは前例のないものです。
関連記事:GMKtec EVO-X2レビュー、Framework Desktopレビュー、ローカルLLM向けMac Mini M4 Proの検証。
注意書きが潜んでいるところ
見出しの数字には、3つの注意点を添えておくべきです。
第一に、メモリ帯域幅が上限であり、それは固定されています。カタログ上は256 GB/s、実効では約215 GB/sです。ソフトウェアスタックがどれだけ成熟しても、このプラットフォームでは高密度の70Bモデルが1桁台半ばのt/sより速くなることはありません。Mac Studioクラスのスループットを期待する購入者は失望するでしょう。「ローカルで70Bをまったく動かせない」状態と比べる購入者は失望しないはずです。
第二に、現在のLLMソフトウェアではNPUはほとんどお飾りです。50 TOPSのXDNA 2ユニットは本物のシリコンですが、llama.cpp、Ollama、LM Studioは現時点でNPUではなくiGPUで推論を処理しています。これが変わるかどうかはソフトウェアの問題であり、ハードウェアの問題ではありません。Phoronixが記録しているように、このプラットフォーム向けのLinuxスタックはまだ活発に成熟している途中で、つい最近のUbuntu 26.04でも測定可能な改善が加わっています。
第三に、ローカルLLMが目的なら、買うべきは128 GBのSKUです。64 GBのベースモデルは優れたミニPCですが、70B向けのミニPCではありません。購入ボタンを押す前に、商品ページの構成が用途に合っているか確認してください。
まとめ
EVO-X2は70B推論のための最速のデスク環境ではありませんし、誠実な人でそう主張する人はいません。それでも、ミニPCのカテゴリーで初めて、本格的な選択肢になっています。$1,999の1リットル筐体で、本物の70Bクラスのモデルをユニファイドメモリに載せ、実用的な時間で応答します。この価格とこのサイズで、これが実現したことはこれまでありませんでした。ローカルAIをめぐる議論は、見せびらかしではなく道具になるほど安価なハードウェアを待ち続けてきました。この筐体に収まったStrix Haloは、市場がこれまでに出荷した中で、それに最も近い存在です。