
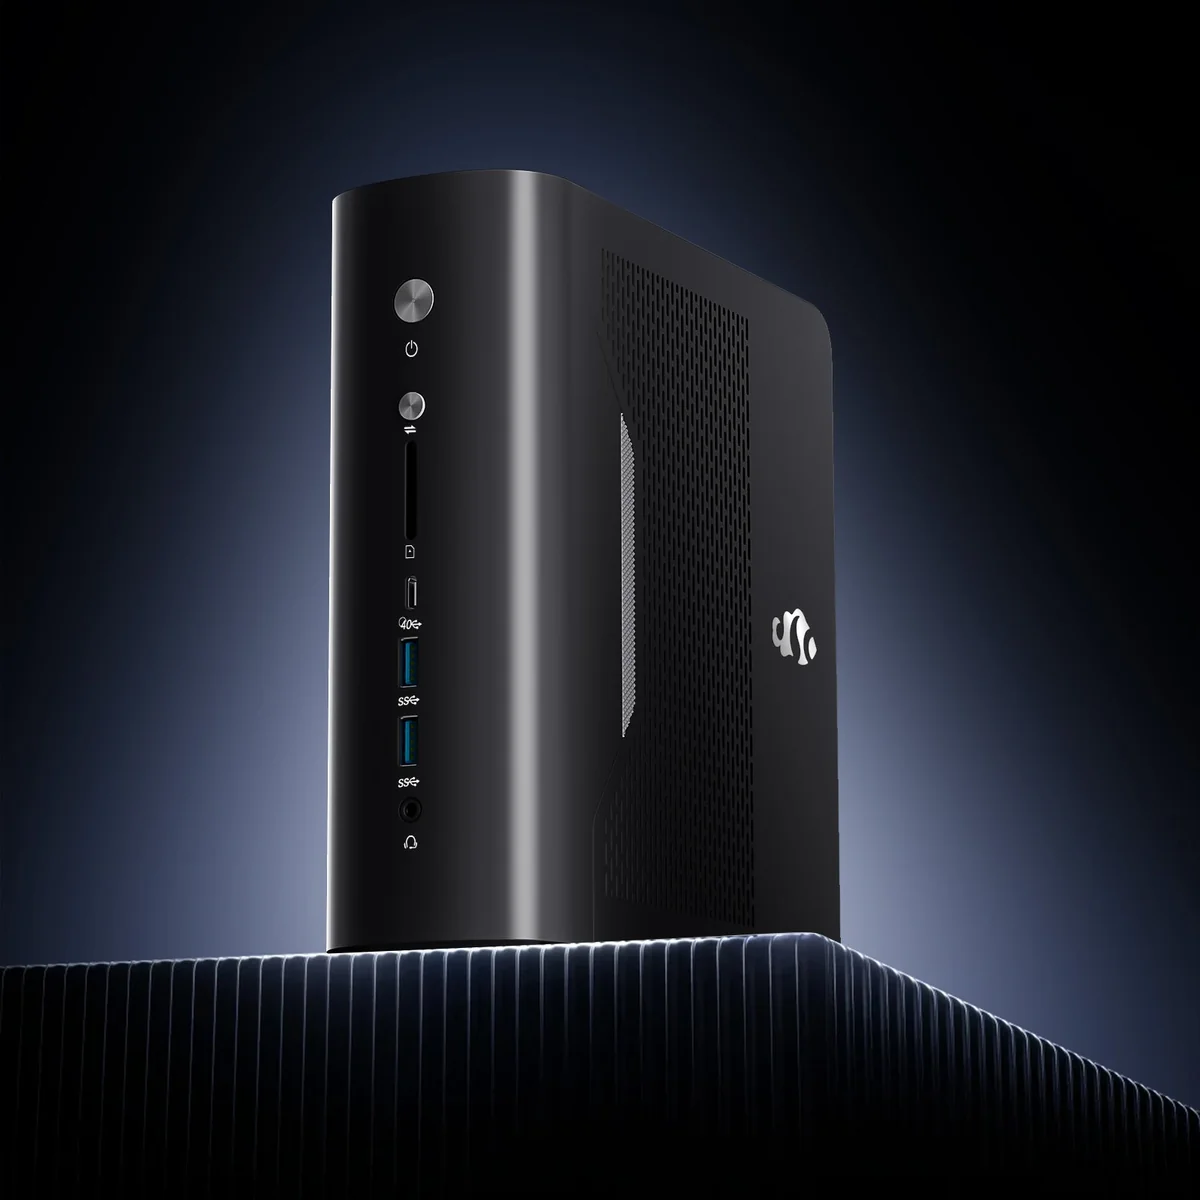
NIMO AI Mini PC 是什么?
NIMO AI Mini PC 是一台 2 升的台式机,核心是 AMD 的 Ryzen AI Max+ 395 “Strix Halo” APU(16 个 Zen 5 核心、32 线程,以及 Radeon 8060S,目前能买到的最快集成显卡),搭配 256-bit 位宽的 128 GB LPDDR5X-8000 统一内存。它在 CES 2026 上发布,是少数几台如今真正能在美国 Amazon 以 $2,999.99 下单的 Strix Halo 主机之一,不必在中国直邮店铺上碰运气。
这个定位很重要。它不是一台碰巧贴了 NPU 标签的通用迷你主机,而是一台本地 AI 工作站,与 NVIDIA DGX Spark 属于同一类讨论对象,区别在于它运行的是普通的 Windows 11,能玩游戏,而且比大多数 GB10 机器便宜。
它适合做什么:在 128GB 统一内存中运行本地 LLM
AMD Ryzen AI Halo 平台的全部意义就在于 GPU 与 CPU 共享一大块内存池。在 NIMO 上,你可以把 128 GB 中最多 96 GB 直接分配给 Radeon 8060S 作为专用显存(在 Linux 上通过共享分配还能更多)。实际表现如下:
- 70B 级稠密模型(Q4 量化的 Llama 3.3 70B、Qwen 2.5 72B)可以完整装入内存(在任何消费级独立显卡上都做不到,除非堆叠多块 RTX 5090)。
- MoE 模型,如 Llama 4 Scout 和 gpt-oss-120B 级别的模型,是它的甜点区:总参数量巨大,但每个 token 的激活参数很少,因此能以真正可交互的速度运行。
- 7B–32B 模型运行飞快,还有余量同时加载多个模型,用于智能体流水线、RAG 嵌入,再顺带跑一个 Stable Diffusion 实例。
XDNA 2 NPU 提供约 50 TOPS 算力(全平台约 126 TOPS),用于 Windows Studio Effects 和 Copilot+ 功能,但要清醒地认识到:这台机器上的 LLM 推理是通过 ROCm、Vulkan 或 LM Studio 在 GPU 上运行的。NPU 只是锦上添花,不是主力引擎(参见我们的本地 LLM 的 NPU、iGPU 与 CPU 对比指南)。
对于创作类工作,40 个 RDNA 3.5 CU 让 8060S 达到移动版 RTX 4060–4070 的水平:DaVinci Resolve 和 Premiere 的 4K 时间线都能流畅处理,1440p 游戏也是实打实的附加优势。作为办公机,它坦白说是大材小用,但 120W 的功耗上限和小巧的体积让它放在任何桌面上都很合适。
内存带宽:token 生成的真正上限
每位 Strix Halo 买家都需要听到这句实话:token 生成速度受内存带宽限制,而不是算力。256-bit 位宽的 LPDDR5X-8000 理论带宽约为 256 GB/s。对集成显卡来说,这已经非常可观,但只相当于 RTX 5090 约 1.8 TB/s 带宽的一小部分。
每生成一个 token 都需要从内存中读取模型的激活权重,因此吞吐量取决于带宽。大致预期是:Q4 量化的稠密 70B 模型为每秒个位数 token,较小模型或 MoE 模型则快得多(通常为 30–70 tok/s)。同一模型若能完全装入显存,独立显卡的生成速度会快好几倍;NIMO 的优势在于 70B 以上的模型根本能装得下。值得一提的是,售价 $3,000–$4,000 的 NVIDIA DGX Spark 也受几乎相同的限制(约 273 GB/s)。这就是 2026 年统一内存 AI 主机的现状。相关阅读:在 Strix Halo 上运行 70B 本地 LLM。
做工与接口
机身是简洁的约 2 升设计(约 19 × 20.5 × 7 cm,1.4 kg),提供三种性能模式,可将 APU 功耗提升至最高 120W 持续功耗,这对于在长时间推理任务中维持 GPU 频率很重要。评测者反馈,散热系统能够应付完整的 120W 模式,风扇噪音可以察觉,但不至于扰人。
13 个接口基本覆盖了所有需求:
- USB4(40 Gbps):支持 eGPU,支持扩展坞(参见我们的迷你主机 eGPU 转接方案指南)
- HDMI 2.1 + DisplayPort 1.4:最高支持 8K@120Hz 输出
- 2.5 GbE 以太网,以及 Wi-Fi 7 和 Bluetooth 5.2
- 充足的 USB-A 和 USB-C 接口,用于连接外设
没有 10 GbE,也没有双网口:对于一台很适合用作家庭实验室 AI 服务的机器来说,这算是一个小遗憾,不过 USB4 转接器可以弥补这一不足。
内存、存储与升级
128 GB LPDDR5X 板载焊死,无法升级,没有商量余地。这是物理限制,而不是厂商吝啬:8000 MT/s 的 256-bit 总线要求 LPDDR5X 贴装在距离芯片封装仅几毫米的位置。第一天就要买够你需要的内存,这也是为什么做 AI 工作时,我们会跳过任何内存更小的 Strix Halo 配置。
存储则完全可以自行维护:双 M.2 PCIe 4.0 插槽,可配置 1 TB 至 8 TB。模型库体积庞大(单个 Q4 量化的 70B 模型就约 40 GB),因此第二个插槽真正有用,而不只是规格表上的点缀。
NIMO AI Mini PC 与 GMKtec EVO-X2:选哪台 Strix Halo 主机?
相同的芯片,相同的 128 GB 内存上限。GMKtec EVO-X2 的功耗上限略高,促销期间的实际售价也更低,而 NIMO 则以可直接在美国 Amazon 购买、支持 Wi-Fi 7 以及更整洁的接口布局作为回应。更新的 GMKtec EVO-X3 进一步提高了平台的功耗上限。如果你不着急,值得关注一下。
价格与购买渠道
128 GB / 1 TB 配置的标价为 $2,999.99,Amazon 翻新机价格约为 $2,299.99。它在 nimopc.com 官网直销(库存时有时无;本文评测时官网显示缺货),也在 Amazon 上销售,市面上还有更大 SSD 容量的版本。与售价 $2,700 以上、只能靠进口购买的竞品相比,对于一台享有美国保修且有现货的机器来说,这个定价是公道的。TechRadar 持续更新的全部 37 款 Ryzen AI Max+ 395 机型汇总,是检验市场行情的有用参考。
需要注意的地方
- 带宽就是上限。 约 256 GB/s 意味着稠密 70B 模型的 token 生成速度只是可用,谈不上快。如果你的负载是以最高速度运行单个中等规模模型,独立显卡台式机更胜一筹。
- 内存板载焊死。 128 GB 就是永久配置。这没问题,但购买前要心里有数。
- ROCm 软件生态存在摩擦。 AMD 的 AI 软件栈已经大幅改进,但与更顺畅的 CUDA 路线相比,在 llama.cpp/LM Studio 中偶尔还是需要四处查找启动参数。
- NIMO 是一个年轻品牌。 硬件是标准的 Strix Halo,Amazon 渠道也能为你提供退货保障,但它目前还没有长期的售后记录。
结论
NIMO AI Mini PC 恰好兑现了 Strix Halo 平台的承诺:一台安静的 2 升 Windows 主机,能在本地运行 70B 级和大型 MoE 模型,能胜任严肃的创作工作,而且不需要凭信任从海外进口硬件。它的局限(内存焊死、token 速率受带宽限制)是平台层面的局限,所有统一内存 AI 主机都有,包括 DGX Spark 在内,并非 NIMO 特有的缺陷。如果你想在 2026 年年中以最便捷的 Amazon 购买渠道进入 128 GB 本地 LLM 领域,这是一台很容易推荐的机器。