
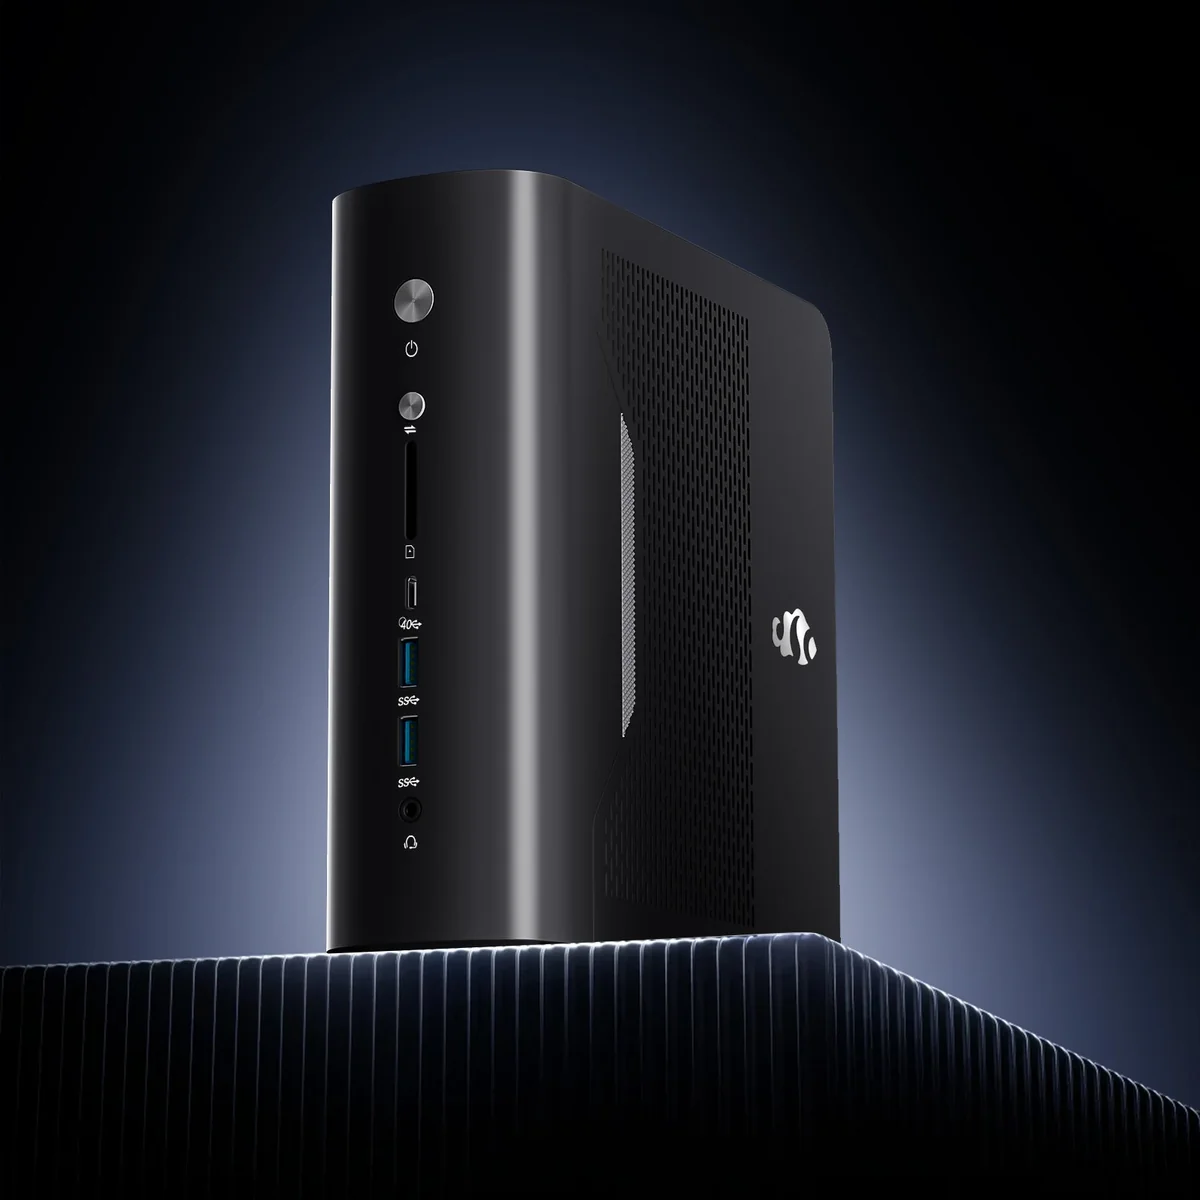
¿Qué es el NIMO AI Mini PC?
El NIMO AI Mini PC es un equipo de escritorio de 2 litros construido en torno a la APU Ryzen AI Max+ 395 “Strix Halo” de AMD (16 núcleos Zen 5, 32 hilos y la Radeon 8060S, hoy la GPU integrada más rápida que puedes comprar), alimentada por 128 GB de memoria unificada LPDDR5X-8000 en un bus de 256 bits. Presentado en el CES 2026, es uno de los pocos equipos Strix Halo que hoy puedes pedir de verdad en Amazon en EE. UU., a $2,999.99, en lugar de arriesgarte con una tienda que envía directo desde China.
Ese contexto importa. No es un mini PC de uso general que casualmente lleva una etiqueta de NPU. Es una estación de trabajo de IA local que compite en la misma liga que el NVIDIA DGX Spark, con la diferencia de que corre Windows 11 normal, sirve para jugar y cuesta menos que la mayoría de las máquinas GB10.
Para qué sirve: LLM locales en 128GB de memoria unificada
La gracia de la plataforma Ryzen AI Halo de AMD es que la GPU comparte un gran bloque de memoria con la CPU. En el NIMO puedes asignar hasta 96 GB de los 128 GB directamente a la Radeon 8060S como memoria gráfica dedicada (y más mediante asignación compartida en Linux). En la práctica:
- Los modelos densos de clase 70B (Llama 3.3 70B, Qwen 2.5 72B en Q4) caben por completo en memoria (algo imposible en cualquier GPU dedicada de consumo, salvo apilando varias RTX 5090).
- Los modelos MoE como Llama 4 Scout y la clase gpt-oss-120B son el punto ideal: una cantidad total de parámetros enorme, pero pocos parámetros activos por token, así que corren a velocidades realmente interactivas.
- Los modelos de 7B-32B vuelan, y queda espacio para mantener varios cargados a la vez para pipelines de agentes, embeddings de RAG y una instancia de Stable Diffusion al costado.
La NPU XDNA 2 aporta ~50 TOPS (unos 126 TOPS en toda la plataforma) para Windows Studio Effects y las funciones Copilot+, pero hay que ser realistas: en esta máquina la inferencia de LLM corre en la GPU mediante ROCm, Vulkan o LM Studio. La NPU es un extra, no el motor (consulta nuestra guía de NPU vs iGPU vs CPU para LLM locales).
Para trabajo creativo, las 40 CU RDNA 3.5 ponen a la 8060S en el terreno de una RTX 4060-4070 para portátiles: las líneas de tiempo 4K en DaVinci Resolve y Premiere van cómodas, y jugar en 1440p es un beneficio adicional legítimo. Como equipo de oficina está, francamente, sobrecalificado, pero el techo de 120W y su tamaño reducido hacen que encaje sin problema en cualquier escritorio.
Ancho de banda de memoria: el verdadero límite de la generación de tokens
Esta es la parte honesta que todo comprador de Strix Halo necesita escuchar: la velocidad de generación de tokens está limitada por el ancho de banda de memoria, no por la capacidad de cómputo. LPDDR5X-8000 en un bus de 256 bits da aproximadamente 256 GB/s teóricos. Es enorme para una iGPU, pero apenas una fracción de los ~1.8 TB/s de los que disfruta una RTX 5090.
Cada token generado requiere leer de memoria los pesos activos del modelo, así que el rendimiento escala con el ancho de banda. Espera cifras aproximadas de un solo dígito de tokens por segundo en un modelo denso de 70B en Q4, y mucho más rápidas (a menudo 30-70 tok/s) en modelos más pequeños o MoE. Una GPU dedicada con el mismo modelo completamente en VRAM genera varias veces más rápido; la ventaja del NIMO es que los modelos de 70B o más siquiera quepan. Cabe destacar que el NVIDIA DGX Spark, de $3,000-$4,000, vive con casi la misma limitación (~273 GB/s). Así son, sin más, los equipos de IA con memoria unificada en 2026. Relacionado: cómo ejecutar LLM locales de 70B en Strix Halo.
Construcción y conectividad
El chasis tiene un diseño limpio de ~2 litros (unos 19 × 20.5 × 7 cm, 1.4 kg) con tres modos de rendimiento que llevan la APU hasta 120W sostenidos, algo importante para mantener las frecuencias de la GPU durante sesiones largas de inferencia. Los reseñadores indican que la refrigeración aguanta el modo completo de 120W con un ruido de ventilador perceptible pero no molesto.
Trece puertos cubren prácticamente todo:
- USB4 (40 Gbps): compatible con eGPU y con docks (consulta nuestra guía de adaptadores eGPU para mini PC)
- HDMI 2.1 + DisplayPort 1.4: salida de hasta 8K@120Hz
- Ethernet 2.5 GbE, además de Wi-Fi 7 y Bluetooth 5.2
- Una buena variedad de USB-A y USB-C para periféricos
No hay 10 GbE ni doble LAN: una pequeña carencia en una máquina en la que la red pesa tanto para servir IA en un home lab, aunque los adaptadores USB4 compensan la diferencia.
Memoria, almacenamiento y ampliaciones
Los 128 GB de LPDDR5X van soldados, no se pueden ampliar y no hay nada que negociar. Es física, no tacañería: el bus de 256 bits a 8000 MT/s exige LPDDR5X montada a milímetros del encapsulado. Compra desde el primer día la memoria que vas a necesitar; por eso nosotros evitaríamos cualquier configuración Strix Halo con menos RAM para trabajo de IA.
El almacenamiento sí se puede ampliar como corresponde: dos ranuras M.2 PCIe 4.0, configurables de 1 TB a 8 TB. Las bibliotecas de modelos son enormes (un solo 70B en Q4 ocupa ~40 GB), así que la segunda ranura es realmente útil y no un adorno de ficha técnica.
NIMO AI Mini PC vs GMKtec EVO-X2: ¿qué equipo Strix Halo elegir?
Mismo silicio, mismo techo de 128 GB. El GMKtec EVO-X2 lleva un límite de potencia algo más alto y sale más barato en las ofertas, mientras que el NIMO responde con disponibilidad directa en Amazon en EE. UU., Wi-Fi 7 y una distribución de puertos más ordenada. El más reciente GMKtec EVO-X3 sube todavía más el techo de potencia de la plataforma. Vale la pena mirarlo si no tienes prisa.
Precio y dónde comprarlo
La configuración de 128 GB / 1 TB tiene un precio de lista de $2,999.99, y en Amazon aparecen unidades reacondicionadas por unos $2,299.99. Se vende directamente en nimopc.com (el stock va rotando; al momento de esta reseña figuraba agotado allí) y en Amazon, donde también circulan variantes con SSD más grande. Frente a rivales de $2,700+ que solo se consiguen importados, el precio es justo para una unidad en stock y con garantía en EE. UU. El recopilatorio de TechRadar con las 37 máquinas Ryzen AI Max+ 395 es una referencia útil para contrastar con el mercado.
Lo que señalaríamos
- El ancho de banda es el techo. ~256 GB/s significa que la generación de tokens en modelos densos de 70B es usable, no rápida. Si tu carga de trabajo es un solo modelo mediano a máxima velocidad, gana un equipo de escritorio con GPU dedicada.
- La RAM va soldada. 128 GB para siempre. Está bien, pero tenlo claro desde el principio.
- Fricción con el software ROCm. El stack de IA de AMD ha mejorado muchísimo, pero espera tener que buscar flags de vez en cuando en llama.cpp/LM Studio, frente al camino más fluido de CUDA.
- NIMO es una marca joven. El hardware es Strix Halo estándar y el canal de Amazon te da protección para devoluciones, pero todavía no hay un historial largo de soporte.
Veredicto
El NIMO AI Mini PC cumple exactamente lo que prometía la plataforma Strix Halo: un equipo Windows silencioso de 2 litros que ejecuta localmente modelos de clase 70B y modelos MoE grandes, maneja trabajo creativo serio y no te obliga a importar hardware a ciegas. Sus límites (RAM soldada, velocidad de tokens limitada por el ancho de banda) son límites de la plataforma que comparten todos los equipos de IA con memoria unificada, hasta el DGX Spark inclusive, no defectos propios de NIMO. Si quieres la vía más fácil de comprar en Amazon para entrar en el terreno de los LLM locales con 128 GB a mediados de 2026, es una máquina fácil de recomendar.