
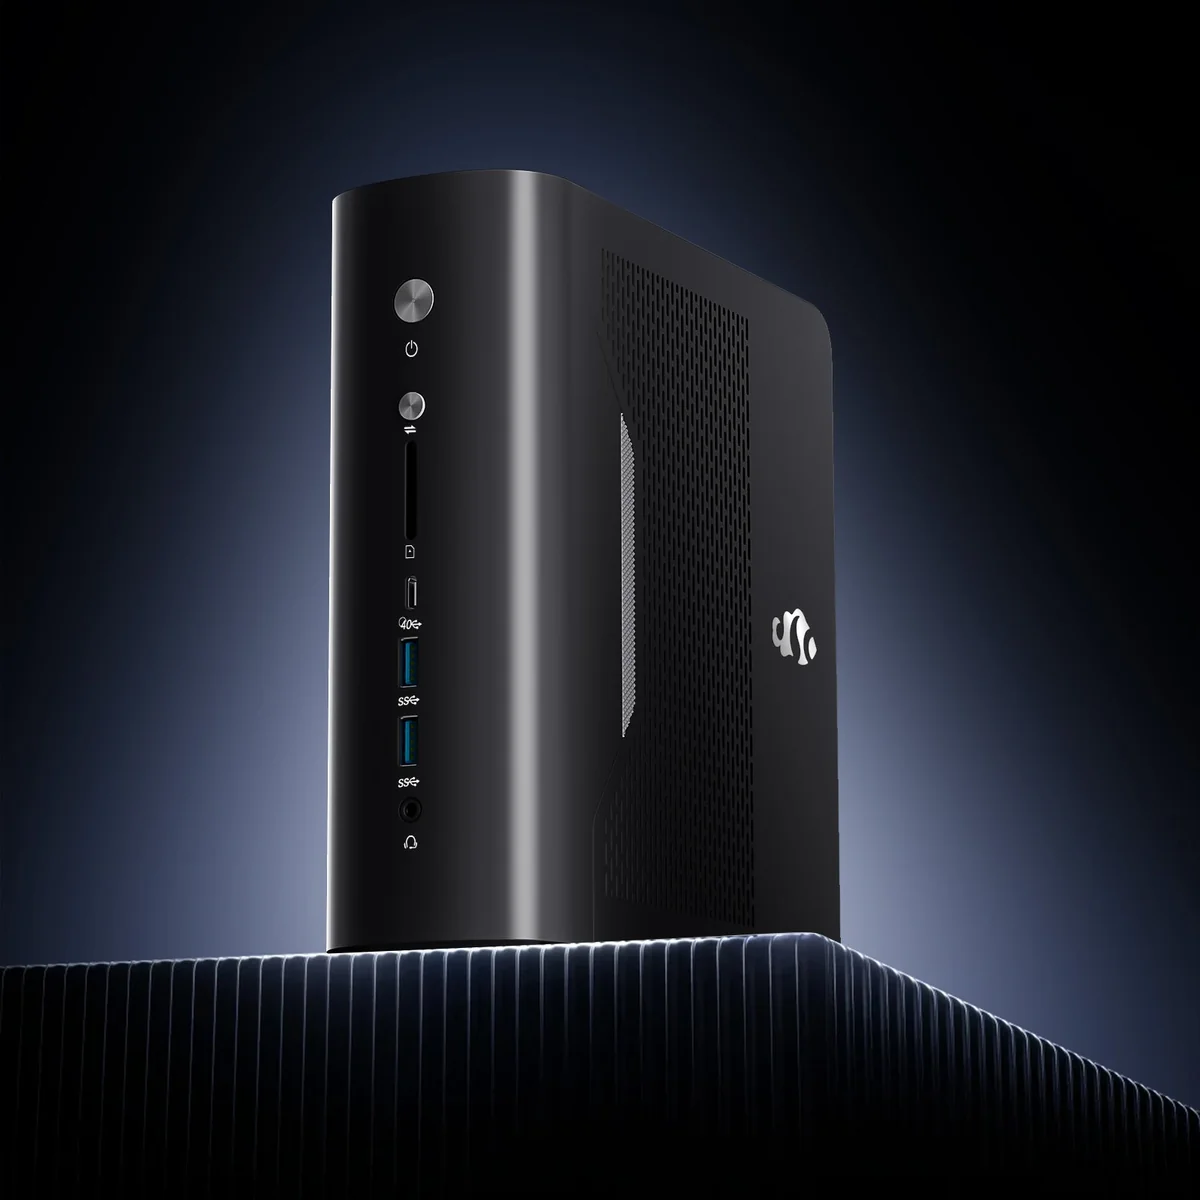
Was ist der NIMO AI Mini PC?
Der NIMO AI Mini PC ist ein 2-Liter-Desktop rund um AMDs Ryzen AI Max+ 395 “Strix Halo”-APU (16 Zen-5-Kerne, 32 Threads und die Radeon 8060S, derzeit die schnellste integrierte GPU, die man kaufen kann), versorgt von 128 GB LPDDR5X-8000 Unified Memory an einem 256-Bit-Bus. Er wurde auf der CES 2026 vorgestellt und ist eine der wenigen Strix-Halo-Boxen, die Sie heute in den USA tatsächlich bei Amazon für $2,999.99 bestellen können, statt auf einen Direktshop aus China zu setzen.
Diese Einordnung ist wichtig. Das hier ist kein Allzweck-Mini-PC, der zufällig einen NPU-Aufkleber trägt. Es ist eine Workstation für lokale KI in derselben Liga wie der NVIDIA DGX Spark, nur dass er ein normales Windows 11 ausführt, Spiele beherrscht und weniger kostet als die meisten GB10-Rechner.
Wofür er gut ist: lokale LLMs in 128 GB Unified Memory
Der ganze Sinn von AMDs Plattform Ryzen AI Halo besteht darin, dass sich die GPU einen großen Speicherpool mit der CPU teilt. Beim NIMO lassen sich bis zu 96 GB der 128 GB direkt der Radeon 8060S als dedizierter Grafikspeicher zuweisen (unter Linux per geteilter Zuweisung noch mehr). In der Praxis bedeutet das:
- Dichte Modelle der 70B-Klasse (Llama 3.3 70B, Qwen 2.5 72B in Q4) passen vollständig in den Speicher (auf keiner diskreten Consumer-GPU möglich, sofern man nicht mehrere RTX 5090 kombiniert).
- MoE-Modelle wie Llama 4 Scout und die gpt-oss-120B-Klasse sind der Sweet Spot: riesige Gesamtparameterzahlen, aber wenige aktive Parameter pro Token, sodass sie in wirklich interaktivem Tempo laufen.
- 7B–32B-Modelle fliegen förmlich, und es bleibt genug Platz, um mehrere gleichzeitig geladen zu halten, etwa für Agenten-Pipelines, RAG-Embeddings und nebenbei eine Stable-Diffusion-Instanz.
Die XDNA 2 NPU steuert ~50 TOPS bei (rund 126 TOPS für die gesamte Plattform), und zwar für Windows Studio Effects und Copilot+-Funktionen. Machen Sie sich aber nichts vor: Die LLM-Inferenz läuft auf diesem Rechner über ROCm, Vulkan oder LM Studio auf der GPU. Die NPU ist eine Zugabe, nicht der Motor (siehe unseren Leitfaden NPU vs. iGPU vs. CPU für lokale LLMs).
Für Kreativarbeit bringen 40 RDNA-3.5-CUs die 8060S in den Bereich einer mobilen RTX 4060–4070: 4K-Timelines in DaVinci Resolve und Premiere laufen komfortabel, und Gaming in 1440p ist ein echter Nebennutzen. Als Bürorechner ist er offen gesagt überqualifiziert, doch die Obergrenze von 120W und die kleine Stellfläche machen ihn zu einer einfachen Lösung für jeden Schreibtisch.
Speicherbandbreite: die eigentliche Grenze der Token-Generierung
Hier kommt der ehrliche Teil, den jeder Strix-Halo-Käufer hören muss: Die Geschwindigkeit der Token-Generierung wird von der Speicherbandbreite begrenzt, nicht von der Rechenleistung. LPDDR5X-8000 an einem 256-Bit-Bus ergibt theoretisch rund 256 GB/s. Für eine iGPU ist das enorm, aber nur ein Bruchteil der ~1,8 TB/s, über die eine RTX 5090 verfügt.
Jedes generierte Token erfordert das Lesen der aktiven Gewichte des Modells aus dem Speicher, daher skaliert der Durchsatz mit der Bandbreite. Rechnen Sie grob mit einstelligen Tokens pro Sekunde bei einem dichten 70B-Modell in Q4 und mit deutlich mehr (oft 30–70 tok/s) bei kleineren oder MoE-Modellen. Eine diskrete GPU mit demselben Modell vollständig im VRAM generiert um ein Mehrfaches schneller; der Vorteil des NIMO ist, dass 70B+-Modelle überhaupt hineinpassen. Bemerkenswert: Der NVIDIA DGX Spark für $3,000–$4,000 lebt mit nahezu derselben Einschränkung (~273 GB/s). So sind KI-Boxen mit Unified Memory im Jahr 2026 nun einmal. Siehe auch: lokale 70B-LLMs auf Strix Halo.
Verarbeitung und Anschlüsse
Das Gehäuse ist ein schlichtes Design mit ~2 Litern (etwa 19 × 20,5 × 7 cm, 1,4 kg) mit drei Leistungsmodi, die die APU auf bis zu 120W Dauerleistung bringen. Das ist wichtig, um die GPU-Takte bei langen Inferenzläufen zu halten. Testberichten zufolge bewältigt die Kühlung den vollen 120-W-Modus mit einem Lüftergeräusch, das wahrnehmbar, aber nicht aufdringlich ist.
Dreizehn Anschlüsse decken praktisch alles ab:
- USB4 (40 Gbps): eGPU-fähig, Dock-fähig (siehe unseren Leitfaden zu eGPU-Adaptern für Mini-PCs)
- HDMI 2.1 + DisplayPort 1.4: Ausgabe bis zu 8K@120Hz
- 2.5 GbE Ethernet, dazu Wi-Fi 7 und Bluetooth 5.2
- Eine ordentliche Auswahl an USB-A und USB-C für Peripheriegeräte
Kein 10 GbE und kein Dual-LAN: ein kleines Manko bei einem Rechner, der für KI-Serving im Homelab so netzwerkrelevant ist, wobei USB4-Adapter die Lücke schließen.
Arbeitsspeicher, Massenspeicher und Aufrüstung
Die 128 GB LPDDR5X sind verlötet, nicht aufrüstbar, nicht verhandelbar. Das ist Physik, kein Geiz: Der 256-Bit-Bus mit 8000 MT/s erfordert LPDDR5X, das nur Millimeter vom Package entfernt sitzt. Kaufen Sie gleich am ersten Tag so viel Speicher, wie Sie brauchen werden. Deshalb würden wir für KI-Arbeit jede Strix-Halo-Konfiguration mit weniger RAM auslassen.
Der Massenspeicher ist ordentlich wartbar: zwei M.2-PCIe-4.0-Steckplätze, konfigurierbar von 1 TB bis 8 TB. Modellbibliotheken sind riesig (ein einzelnes 70B-Modell in Q4 belegt ~40 GB), daher ist der zweite Steckplatz wirklich nützlich und keine bloße Datenblatt-Verzierung.
NIMO AI Mini PC vs. GMKtec EVO-X2: welche Strix-Halo-Box?
Dasselbe Silizium, dieselbe Obergrenze von 128 GB. Der GMKtec EVO-X2 fährt ein etwas höheres Power-Limit und ist bei Aktionen im Straßenpreis günstiger, während der NIMO mit sauberer Amazon-Verfügbarkeit in den USA, Wi-Fi 7 und einer aufgeräumteren Anschlussausstattung kontert. Der neuere GMKtec EVO-X3 hebt die Leistungsobergrenze der Plattform weiter an. Er ist einen Blick wert, wenn Sie es nicht eilig haben.
Preise und Bezugsquellen
Die Konfiguration mit 128 GB / 1 TB ist mit $2,999.99 gelistet, generalüberholte Amazon-Geräte tauchen für rund $2,299.99 auf. Verkauft wird er direkt bei nimopc.com (der Bestand wechselt; zum Testzeitpunkt war er dort als nicht vorrätig gelistet) und bei Amazon, wo auch Varianten mit größerer SSD im Umlauf sind. Verglichen mit reinen Import-Konkurrenten ab $2,700 ist der Preis für ein vorrätiges Gerät mit US-Garantie fair. Die laufend aktualisierte Übersicht von TechRadar über alle 37 Rechner mit Ryzen AI Max+ 395 ist ein nützlicher Marktabgleich.
Was wir anmerken würden
- Die Bandbreite ist die Grenze. ~256 GB/s bedeuten, dass die Token-Generierung bei dichten 70B-Modellen brauchbar ist, aber nicht schnell. Wenn Ihre Arbeitslast aus einem einzigen mittelgroßen Modell bei maximaler Geschwindigkeit besteht, gewinnt ein Desktop mit diskreter GPU.
- Der RAM ist verlötet. 128 GB für immer. In Ordnung, aber Sie sollten es vorher wissen.
- Reibung bei der ROCm-Software. AMDs KI-Stack hat sich dramatisch verbessert, doch rechnen Sie in llama.cpp/LM Studio gelegentlich mit der Suche nach den richtigen Flags, verglichen mit dem reibungsloseren CUDA-Pfad.
- NIMO ist eine junge Marke. Die Hardware ist Standard-Strix-Halo, und der Amazon-Kanal gibt Ihnen Rückgabeschutz, aber eine lange Support-Historie gibt es noch nicht.
Fazit
Der NIMO AI Mini PC liefert genau das, was die Strix-Halo-Plattform versprochen hat: eine leise 2-Liter-Windows-Box, die Modelle der 70B-Klasse und große MoE-Modelle lokal ausführt, ernsthafte Kreativarbeit bewältigt und keinen Hardware-Import auf gut Glück erfordert. Seine Grenzen (verlöteter RAM, bandbreitenbegrenzte Token-Raten) sind Plattformgrenzen, die jede KI-Box mit Unified Memory bis hin zum DGX Spark teilt, keine NIMO-spezifischen Schwächen. Wenn Sie Mitte 2026 den am einfachsten bei Amazon kaufbaren Weg in die Welt lokaler LLMs mit 128 GB suchen, ist dies ein Rechner, den wir ohne Weiteres empfehlen können.