
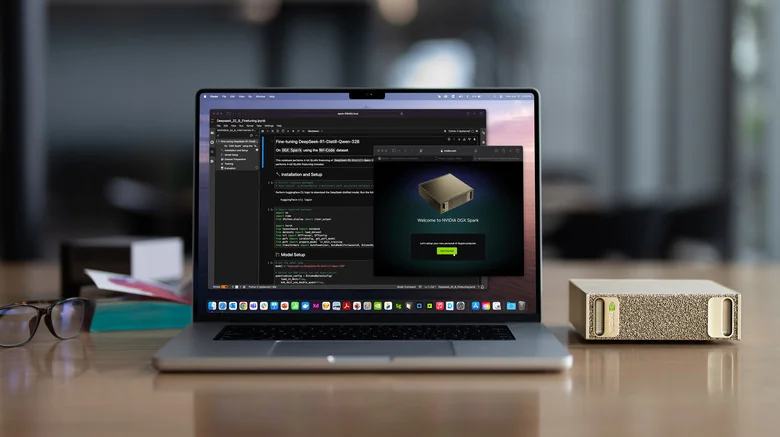
它是什么
NVIDIA DGX Spark 是一台只有厚平装书大小的个人 AI 超级计算机:一个 150 mm 的铝制立方体,核心是 NVIDIA 的 GB10 Grace Blackwell 超级芯片。它把 20 核 Arm CPU 和 Blackwell GPU 封装在同一颗芯片上,配备 128 GB 统一内存,并运行 NVIDIA 自家的 DGX OS,完整的 CUDA 软件栈开箱即用。售价 $3,999(受 2026 年初内存涨价影响,现已接近 $4,699),它在任何常规意义上都不算迷你主机。它是一台开发者工作站,让你在自己的桌面上运行和微调大语言模型,而不必租用云端 GPU。
这是 GB10 的参考机型,也就是 Founders Edition,其他厂商的版本都以它为衡量基准。如果你在对比 ASUS Ascent GX10 或其他任何 Grace Blackwell 桌面主机,这台就是基准线。它也是即将推出的消费级 ASUS ProArt RTX Spark 迷你主机 的已上市同门产品,后者将同级别的 GB10 芯片重新包装,面向不同的用户群体。
适合做什么:本地 AI 与 LLM 开发
DGX Spark 只为一件事而生,而且做得很好:在本地运行大模型,无需云端账号。
- 本地 LLM 推理。 128 GB 统一内存意味着你可以完全在本机加载最高约 200B 参数的(量化)模型。4-bit 的 70B 模型可以轻松放进内存,还能留出较长的上下文窗口。
- 微调与原型开发。 原本需要租用 A100 才能完成的 LoRA 和 QLoRA 微调任务,在这台机器上就能跑。它是真正的 CUDA 开发环境,而不是模拟层。
- 从第一天起原生支持 CUDA。 与 Apple Mac Studio 或 AMD Ryzen AI Max 主机不同,DGX Spark 运行的 CUDA、cuDNN、TensorRT 和 NIM 软件栈与你部署到生产环境的完全一致。在这里写的代码可以原封不动地迁移到 DGX 服务器。
- 轻度创作与办公。 DGX OS 是桌面版 Linux,可以运行浏览器、终端和创作工具,但这只是附加价值,并非重点。
Tom’s Hardware 的概括很到位:这是一个全能型 AI 沙盒,在开发者关心的负载上胜过 AMD 的 Ryzen AI Max+ 395。
GB10 超级芯片与统一内存
GB10 Grace Blackwell 超级芯片就是全部的看点。NVIDIA 通过 NVLink-C2C 将一颗 Grace 级 CPU(10× Cortex-X925 性能核 + 10× Cortex-A725 能效核)与 Blackwell GPU 连接在一起,这种一致性互连的带宽远超 PCIe。GPU 配备第五代 Tensor Core 和第四代 RT Core,可提供 1 PetaFLOP 的 FP4 算力(1,000 TOPS)。
由于 CPU 和 GPU 共享同一个 128 GB LPDDR5x 一致性内存池,无需通过 PCIe 总线来回复制张量,也不必把模型拆分到显存和系统内存中。GPU 可以直接访问全部 128 GB。正是这个统一内存池,让一台不到 2 升的小机器能够容纳 200B 参数的模型,而在其他平台上这需要多块独立显卡才能装下。
做工、连接性与集群
机身借鉴了大型 DGX Station 的金色”奶酪刨”前面板,缩小到 1.2 kg。它可以横放或竖放,由 240 W 外置电源供电(GB10 本身的额定 TDP 为 140 W)。
连接性最能体现它面向开发者的定位:
- ConnectX-7 网卡,配备 2× 200 Gbps QSFP 端口,这是最大的亮点。你可以将两台 DGX Spark 直接互联为 256 GB 集群,运行单台设备装不下的模型。
- 10 GbE RJ-45、Wi-Fi 7、蓝牙 5.4
- 4× USB-C、1× HDMI 2.1a,通过 USB-C 最多支持 3× DisplayPort
- 4 TB 自加密 NVMe:速度快、安全,但近乎焊死(不是用户可自行更换的硬盘位)
两台 DGX Spark 可以组成集群吗?
可以。ConnectX-7 双 200GbE 网络正是为此而设计的。两台设备互联后可获得 256 GB 统一内存,用于运行 400B 参数级别的模型。这是选择 NVIDIA 这台机器而非 Mac Studio 的最大理由:集群方案是原生支持的,而不是变通凑合。
内存带宽:实际使用中的天花板
接下来说点实话。DGX Spark 的内存带宽约为 273 GB/s,真正的瓶颈是它,而不是算力。
LLM 的 token 生成速度几乎与内存带宽成线性关系。Mac Studio 约 546 GB/s 的带宽接近 Spark 的两倍,这意味着在同一模型上每秒能生成更多 token。RTX 5090 的 GDDR7 更是完全不在一个级别。所以,尽管 DGX Spark 能装下 5090 装不下的 200B 模型,但对于任何能放进 5090 较小显存的模型,5090 的 token 生成速度都更快。
结论:DGX Spark 针对的是容量和 CUDA 一致性,而不是原始吞吐量。它解决的是”我到底能不能运行并迭代这个超大模型”的问题,而不是”我桌上最快的交互式聊天机器人是哪台”。Tom’s Hardware 和 ServeTheHome 的评测者得出了相同的结论:带宽是它的阿喀琉斯之踵,购买前要心里有数。
价格与购买渠道
DGX Spark 于 2025 年 10 月以 $3,999 的价格上市。全球内存短缺 推高了 2026 年初的市场售价,因此请根据供货情况预留 $3,999–$4,699 的预算。它通过 NVIDIA 合作伙伴销售,也在 Amazon 上架;联盟链接对应的是 Founders Edition。
以这个价格,你买到的是 NVIDIA 的芯片、NVIDIA 的操作系统和 NVIDIA 的集群网络,作为一个完整的受支持套装。ASUS Ascent GX10 等合作伙伴版本有时价格更低。如果你更看重散热和 SSD 代际,而不是 Founders 品牌,它们值得对比一下。相关阅读:我们的 GIGABYTE AI TOP ATOM 评测、MSI EdgeXpert MS-C931 评测,以及关于 DGX Spark 64GB 价格 的分析。
需要注意的问题
对一台出色但专精的机器做出公允评价:
- 273 GB/s 带宽限制了 token 速度。 对于单用户交互式推理,大显存独立显卡或 Mac Studio 在能装下的模型上可能感觉更快。
- DGX OS 是 Arm Linux,不是 Windows。 这是一个 CUDA 开发环境。如果你想要通用桌面电脑,这不是你要的产品。
- 内存和存储都无法由用户升级。 128 GB 和 4 TB 就是全部。请提前规划好配置。
- 价格波动。 上市后的加价意味着你可能要比 MSRP 多付几百美元。请留意商品报价。
NVIDIA DGX Spark 结论
如果你清楚它是什么,NVIDIA DGX Spark 是目前能买到的最完整的个人 AI 超级计算机。GB10 Grace Blackwell 超级芯片、128 GB 统一内存、原生 CUDA 和双 200GbE 集群,让它成为在本地运行和微调最高 200B 参数模型的真正归宿,并且可以顺畅地升级到云端 DGX 部署。
对 273 GB/s 的内存带宽要有清醒的认识:这是一台主打容量与兼容性的机器,而不是吞吐量冠军。对于常年使用 CUDA 的 AI 开发者、研究人员和机器学习工程师来说,这种取舍恰到好处,DGX Spark 值得我们放心推荐。如果你想要一台快速的通用桌面电脑,或者在单个聊天会话中追求最高的每秒 token 数,请另寻他选。如果你想要同样的芯片,下单前不妨对比一下 ASUS Ascent GX10。