
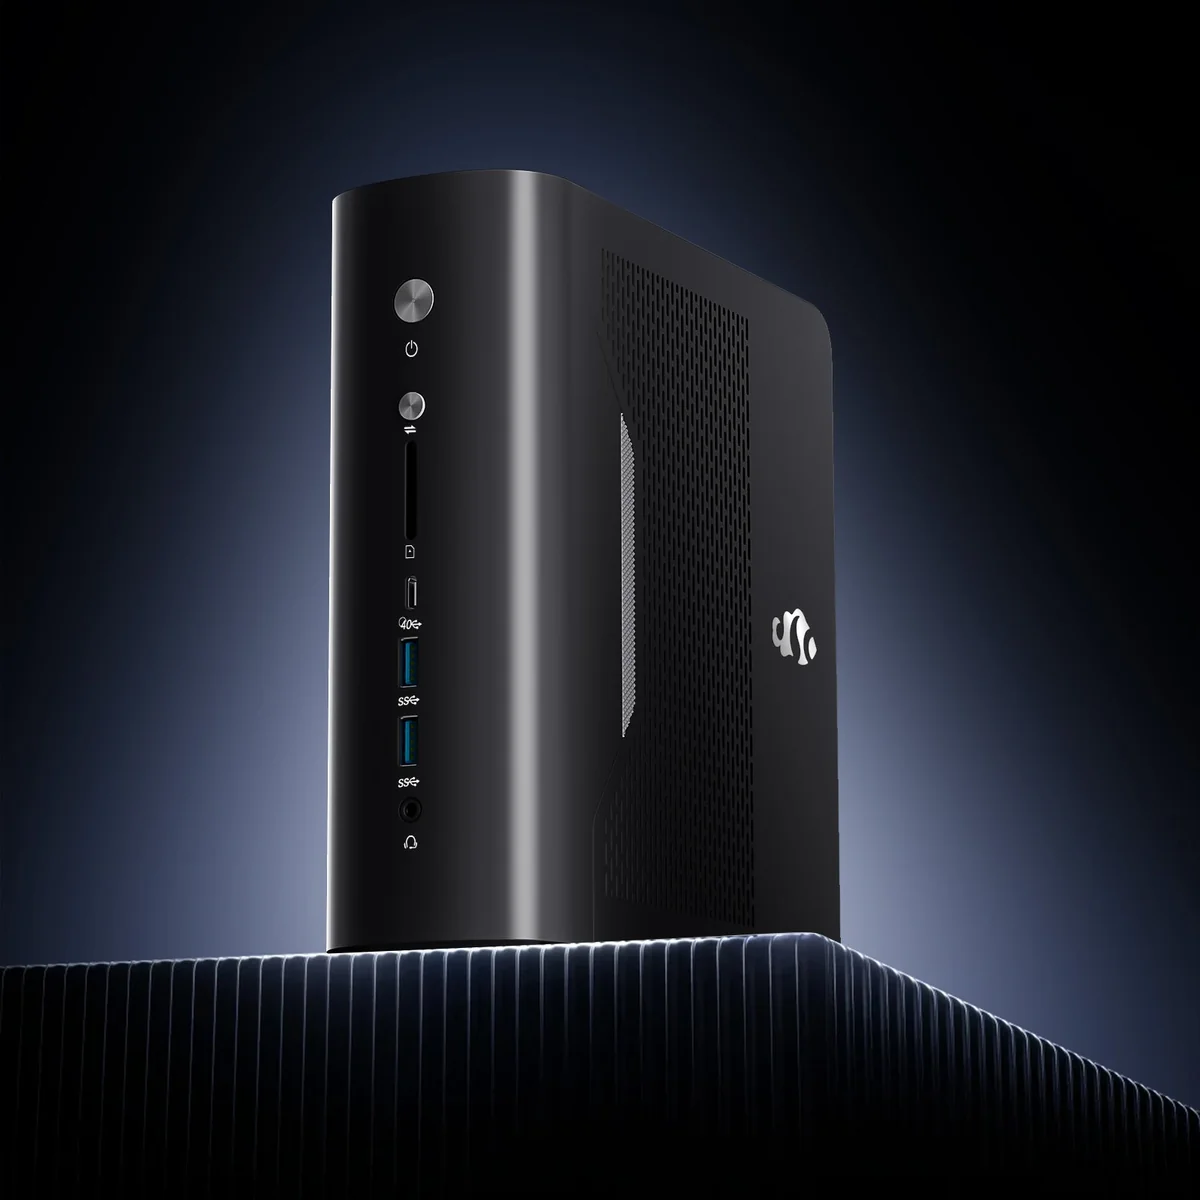
Qu’est-ce que le NIMO AI Mini PC ?
Le NIMO AI Mini PC est un ordinateur de bureau de 2 litres construit autour de l’APU Ryzen AI Max+ 395 « Strix Halo » d’AMD (16 cœurs Zen 5, 32 threads et la Radeon 8060S, actuellement le GPU intégré le plus rapide du marché), alimenté par 128 Go de mémoire unifiée LPDDR5X-8000 sur un bus 256 bits. Lancé au CES 2026, c’est l’un des rares boîtiers Strix Halo que l’on peut réellement commander aujourd’hui sur Amazon aux États-Unis, à $2,999.99, plutôt que de tenter sa chance sur une boutique en direct de Chine.
Ce cadrage compte. Il ne s’agit pas d’un mini PC généraliste qui se trouve arborer un autocollant NPU. C’est une station de travail d’IA locale qui joue dans la même catégorie que le NVIDIA DGX Spark, à ceci près qu’elle tourne sous un Windows 11 standard, fait tourner des jeux et coûte moins cher que la plupart des machines GB10.
Ses points forts : des LLM locaux dans 128 Go de mémoire unifiée
Tout l’intérêt de la plateforme Ryzen AI Halo d’AMD est que le GPU partage un grand réservoir de mémoire unique avec le CPU. Sur le NIMO, vous pouvez allouer jusqu’à 96 Go des 128 Go directement à la Radeon 8060S comme mémoire graphique dédiée (et davantage via l’allocation partagée sous Linux). En pratique :
- Les modèles denses de classe 70B (Llama 3.3 70B, Qwen 2.5 72B en Q4) tiennent entièrement en mémoire (impossible sur n’importe quel GPU dédié grand public, à moins d’empiler des RTX 5090).
- Les modèles MoE comme Llama 4 Scout et la classe gpt-oss-120B sont le point idéal : un nombre total de paramètres énorme, mais peu de paramètres actifs par token, ce qui leur permet de tourner à des vitesses réellement interactives.
- Les modèles de 7B à 32B filent, avec assez de marge pour en garder plusieurs chargés simultanément pour des pipelines d’agents, des embeddings RAG et une instance Stable Diffusion à côté.
Le NPU XDNA 2 apporte ~50 TOPS (environ 126 TOPS à l’échelle de la plateforme) pour Windows Studio Effects et les fonctions Copilot+, mais soyons lucides : sur cette machine, l’inférence LLM tourne sur le GPU via ROCm, Vulkan ou LM Studio. Le NPU est un bonus, pas le moteur (voir notre guide NPU vs iGPU vs CPU pour les LLM locaux).
Pour la création, les 40 CU RDNA 3.5 placent la 8060S dans le territoire d’une RTX 4060–4070 mobile : les timelines 4K sous DaVinci Resolve et Premiere sont confortables, et le jeu en 1440p est un réel avantage secondaire. En machine de bureautique, elle est franchement surqualifiée, mais le plafond de 120 W et l’encombrement réduit lui permettent de trouver facilement sa place sur n’importe quel bureau.
Bande passante mémoire : le vrai plafond de la génération de tokens
Voici la partie honnête que tout acheteur de Strix Halo doit entendre : la vitesse de génération de tokens est limitée par la bande passante mémoire, pas par la puissance de calcul. De la LPDDR5X-8000 sur un bus 256 bits donne environ 256 Go/s en théorie. C’est énorme pour un iGPU, mais une fraction des ~1,8 To/s dont profite une RTX 5090.
Chaque token généré exige de lire les poids actifs du modèle en mémoire, si bien que le débit évolue avec la bande passante. Attendez-vous à des ordres de grandeur comme quelques tokens par seconde (moins de dix) sur un modèle dense 70B en Q4, et beaucoup plus (souvent 30 à 70 tok/s) sur des modèles plus petits ou MoE. Un GPU dédié avec le même modèle entièrement en VRAM génère plusieurs fois plus vite ; l’avantage du NIMO est que les modèles de 70B et plus y tiennent tout simplement. À noter, le NVIDIA DGX Spark à $3,000–$4,000 vit avec quasiment la même contrainte (~273 Go/s). C’est tout simplement la nature des boîtiers IA à mémoire unifiée en 2026. À lire aussi : faire tourner des LLM locaux 70B sur Strix Halo.
Conception et connectique
Le châssis adopte un design épuré d’environ 2 litres (environ 19 × 20,5 × 7 cm, 1,4 kg) avec trois modes de performance qui font monter l’APU jusqu’à 120 W en continu, ce qui compte pour maintenir les fréquences du GPU lors de longues sessions d’inférence. Les testeurs rapportent que le refroidissement encaisse le mode 120 W complet avec un bruit de ventilateur perceptible mais pas envahissant.
Treize ports couvrent l’essentiel :
- USB4 (40 Gbit/s) : compatible eGPU et station d’accueil (voir notre guide des adaptateurs eGPU pour mini PC)
- HDMI 2.1 + DisplayPort 1.4 : sortie jusqu’en 8K@120Hz
- Ethernet 2,5 GbE, plus Wi-Fi 7 et Bluetooth 5.2
- Un bon assortiment de ports USB-A et USB-C pour les périphériques
Pas de 10 GbE ni de double port LAN : un léger manque sur une machine aussi tournée vers le réseau pour servir de l’IA en home lab, même si des adaptateurs USB4 comblent l’écart.
Mémoire, stockage et évolutivité
Les 128 Go de LPDDR5X sont soudés, non évolutifs, non négociables. C’est de la physique, pas de la radinerie : un bus 256 bits à 8000 MT/s impose une LPDDR5X placée à quelques millimètres du package. Achetez dès le premier jour la mémoire dont vous aurez besoin, c’est pourquoi nous éviterions toute configuration Strix Halo avec moins de RAM pour l’IA.
Le stockage est réellement accessible : deux emplacements M.2 PCIe 4.0, configurables de 1 To à 8 To. Les bibliothèques de modèles sont énormes (un seul 70B en Q4 pèse ~40 Go), si bien que le second emplacement est vraiment utile et pas une simple fioriture de fiche technique.
NIMO AI Mini PC vs GMKtec EVO-X2 : quel boîtier Strix Halo ?
Même puce, même plafond de 128 Go. Le GMKtec EVO-X2 pousse une limite de puissance légèrement plus élevée et se montre moins cher en promotion, tandis que le NIMO réplique avec une disponibilité simple sur Amazon US, le Wi-Fi 7 et une connectique mieux organisée. Le plus récent GMKtec EVO-X3 relève encore le plafond de puissance de la plateforme. Il mérite un coup d’œil si vous n’êtes pas pressé.
Prix et où l’acheter
La configuration 128 Go / 1 To est affichée à $2,999.99, avec des unités reconditionnées Amazon qui apparaissent autour de $2,299.99. Elle est vendue en direct sur nimopc.com (les stocks tournent ; elle était en rupture au moment du test) et sur Amazon, avec des variantes à SSD plus grand qui circulent également. Face à des concurrents vendus uniquement en import à partir de $2,700, le prix est correct pour une unité en stock et garantie aux États-Unis. Le récapitulatif de TechRadar, régulièrement mis à jour, des 37 machines Ryzen AI Max+ 395 constitue un bon point de repère sur le marché.
Ce que nous signalons
- La bande passante est le plafond. ~256 Go/s signifie que la génération de tokens sur un modèle dense 70B est utilisable, pas rapide. Si votre charge de travail consiste en un seul modèle de taille moyenne à vitesse maximale, une tour à GPU dédié l’emporte.
- La RAM est soudée. 128 Go pour toujours. Très bien, mais sachez-le avant d’acheter.
- Friction logicielle avec ROCm. La pile IA d’AMD s’est considérablement améliorée, mais attendez-vous à devoir chercher le bon paramètre de temps en temps dans llama.cpp/LM Studio, comparé au chemin plus fluide de CUDA.
- NIMO est une marque jeune. Le matériel est un Strix Halo standard et le canal Amazon vous offre une protection en cas de retour, mais il n’existe pas encore d’historique de support sur la durée.
Verdict
Le NIMO AI Mini PC tient exactement la promesse de la plateforme Strix Halo : un boîtier Windows silencieux de 2 litres qui fait tourner en local des modèles de classe 70B et de grands modèles MoE, encaisse un vrai travail de création et n’oblige pas à importer du matériel les yeux fermés. Ses limites (RAM soudée, débit de tokens borné par la bande passante) sont celles de la plateforme, partagées par tous les boîtiers IA à mémoire unifiée jusqu’au DGX Spark inclus, et non des défauts propres à NIMO. Si vous cherchez la voie la plus simple pour accéder, via Amazon, au territoire des LLM locaux sur 128 Go à la mi-2026, c’est une machine facile à recommander.