
Jeder seit der zweiten Hälfte 2024 angekündigte Mini-PC trägt eine Zahl im Datenblatt, die es im selben Regal zwei Jahre zuvor noch nicht gab: TOPS. Intel nennt “bis zu 36 TOPS” für Lunar Lake. AMD nennt “bis zu 50 TOPS” für die XDNA 2 NPU im Ryzen AI 300. Qualcomm nennt “45 TOPS” für die Hexagon-NPU des Snapdragon X Elite. Apple nennt “38 TOPS” für die Neural Engine des M4. All das sind INT8-Spitzenwerte, technisch alle vergleichbar und alle stark vom Marketing geprägt. Denn die eigentliche Frage, die sich ein Käufer eines “KI-Mini-PCs” stellen sollte, ist nicht, wie viele TOPS die NPU verspricht, sondern was diese TOPS heute tatsächlich beschleunigen. Stand April 2026 fällt die Antwort enger aus, als die Verpackung vermuten lässt.
Die Marketingebene: TOPS und die Copilot+-Hürde
Die TOPS-Zahl im Datenblatt eines Mini-PCs ist praktisch ausnahmslos ein reiner NPU-Wert. Microsofts Copilot+ PC-Programm legt die Untergrenze bei 40 NPU-TOPS fest. Davon hängt ab, ob ein Gerät mit lokalen Funktionen wie Recall, Cocreator, Live Captions mit Übersetzung und Windows Studio Effects ausgeliefert werden darf. AMDs Ryzen AI 300 Serie nimmt die Hürde mit 50 TOPS über XDNA 2; Qualcomms Snapdragon X Elite mit 45; Intels Lunar Lake erreicht sie mit 48 (AnandTech-Architekturanalyse). Die älteren Core Ultra 100 / 200 (“Meteor Lake” und “Arrow Lake”) verfehlen die Grenze und sind vom Copilot+-Branding ausgeschlossen, obwohl viele dieser Chips in Geräten stecken, die weiterhin als “KI-Mini-PCs” vermarktet werden.
Der seltsamste Fall ist Apple. Die Neural Engine des M4 ist mit 38 TOPS angegeben und liegt damit unter Microsofts Schwelle, doch in realen Workloads erreicht oder übertrifft der M4 regelmäßig nominell schnellere x86-NPUs (NotebookCheck-Test des Mac mini M4 Pro). Die “Hürde” belohnt eine Zahl, nicht ein Ergebnis.
Was NPUs heute tatsächlich beschleunigen
Im April 2026 ist die Liste der Workloads, die auf einem Windows- oder Mac-Mini-PC wirklich auf der NPU laufen, kurz:
- Windows Studio Effects: Hintergrundunschärfe der Kamera, Blickkontaktkorrektur, Sprachverbesserung, automatische Bildausschnitte.
- Live Captions / Übersetzung auf dem Gerät in Windows 11 24H2 und neuer.
- App-spezifische KI-Funktionen, etwa die lokalen Teile von Adobes Sensei-Stack und eine Handvoll Funktionen von Microsoft 365, bei denen der Hersteller ausdrücklich einen NPU-Codepfad ausgeliefert hat (DirectML, ONNX Runtime QNN, OpenVINO oder Core ML).
- Einige Whisper- bzw. kleine ASR-Implementierungen, bei denen das Modell klein genug ist, um bequem in den Kachelspeicher der NPU zu passen, und die Runtime einen quantisierten Graphen bereithält.
Das ist im Großen und Ganzen die vollständige Liste dessen, was ein durchschnittlicher Nutzer auf einem Standard-Mini-PC von 2026 als tatsächlich NPU-beschleunigt nachprüfen kann.
Was NPUs (meist) nicht beschleunigen
Der verbreitete Software-Stack für lokale LLMs (llama.cpp, Ollama, LM Studio, KoboldCpp, text-generation-webui) läuft 2026 über CPU- und iGPU-Pfade, nicht auf der NPU. Es gibt durchaus Bewegung: llama.cpp hat Ende 2024 ein QNN-Backend für Snapdragons Hexagon-NPU gemergt, und DirectML stellt unter Windows inzwischen einen NPU-Execution-Provider bereit. Speziell bei Intel- und AMD-Chips greifen gängige LLM-Tools aber weiterhin standardmäßig auf Vulkan/iGPU oder AVX2/AVX-512 auf der CPU zurück, weil die NPU-Software-Stacks (OpenVINO GenAI bei Intel, Ryzen AI Software / XDNA bei AMD) entweder nur wenige Modelle abdecken oder auf bestimmte Quantisierungsformate beschränkt sind.
Bei der Bildgenerierung zeigt sich dasselbe Bild. Stable Diffusion XL und Flux laufen auf einem Mini-PC von 2026 auf der iGPU (Intel Arc, Radeon 880M / 890M / 8060S) oder, zunehmend häufig, auf einer externen eGPU. NPU-beschleunigtes SDXL gibt es in Hersteller-Demos und in Olive-optimierten ONNX-Builds, aber das ist nicht das, was Nutzer tatsächlich ausführen, wenn sie Automatic1111, ComfyUI oder InvokeAI installieren.
Die Realität nach Plattform
Apple Silicon (Mac mini M4 / M4 Pro). Die Neural Engine, die Metal-GPU und die AMX-Matrixeinheiten werden über MLX und Core ML koordiniert. Für einen Käufer, der heute mit dem geringsten Aufwand ein 7B-13B-LLM ausführen will, ist ein Mac mini M4 Pro mit 48-64 GB Unified Memory nach unserer Einschätzung der beste Mainstream-Stack auf dem Markt: hohe Speicherbandbreite, ausgereifte Tools und eine einheitliche Runtime.
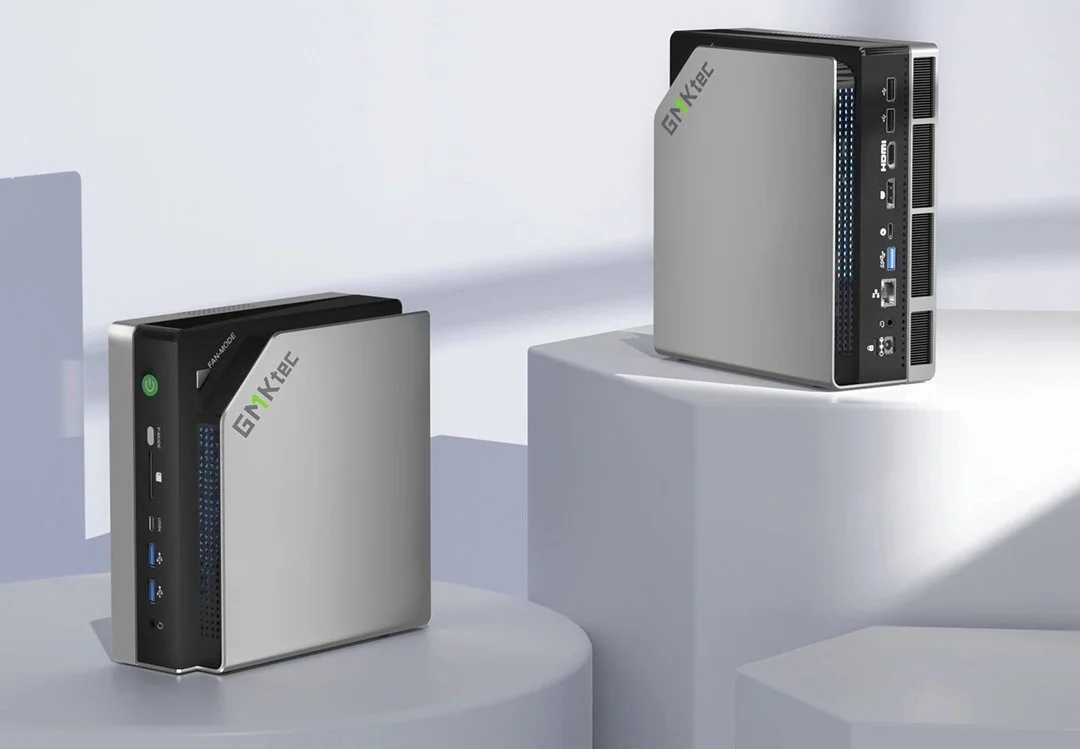
AMD Ryzen AI / Ryzen AI Max+ (“Strix Halo”). Das Arbeitspferd für LLMs auf diesen Chips ist die Radeon-iGPU (780M, 8060S) unter ROCm oder Vulkan, nicht die XDNA 2 NPU. Die NPU ist auf dem Papier beeindruckend und kommt bei Studio Effects und einigen Hersteller-Demos zum Einsatz, liegt beim allgemeinen Betrieb von LLMs im April 2026 aber meist brach. Wo Strix Halo gewinnt, ist der Unified Memory: Phoronix und ServeTheHome haben beide gezeigt, dass ein Strix-Halo-Rechner mit 128 GB (etwa der GMKtec EVO-X2) Modelle ausführt, die kein mit NPU-Werten beworbener Mittelklasse-Mini-PC überhaupt laden kann.
Intel Core Ultra (Lunar Lake / Arrow Lake-H). OpenVINO bietet echte LLM-Unterstützung, doch Ollama, LM Studio und llama.cpp bevorzugen allesamt die Arc-iGPU über SYCL/Vulkan oder die CPU. Auf einem ASUS ROG NUC 14 Performance trägt die NPU zu Studio Effects und einer Handvoll UWP-Funktionen bei; das LLM, das Sie tatsächlich laden, läuft auf der Arc-Grafikeinheit.
Snapdragon X Elite (Hexagon NPU). Dies ist die einzige Plattform mit einem glaubwürdigen, gemergten Pfad von einer gängigen LLM-Runtime zur NPU: dem QNN-Backend von llama.cpp. Der Haken ist der Marktanteil: Mini-PCs mit Snapdragon X machen nur einen kleinen Teil des Angebots 2026 aus, und Windows on ARM hat noch Einschränkungen bei der App-Kompatibilität, die Intel- und AMD-Geräte nicht haben.
Worauf es beim Kauf eines Mini-PCs 2026 wirklich ankommt
Geht es um lokale LLMs, lautet die ehrliche Rangfolge im April 2026: Speicherkapazität, dann Speicherbandbreite, dann iGPU-Klasse und erst danach NPU-TOPS. Einige konkrete Beispiele:
- Ein Apple Mac mini M4 Pro mit 64 GB übertrifft die meisten “50 TOPS Copilot+“-Mini-PCs bei den tatsächlichen LLM-Tokens pro Sekunde, trotz niedrigerer NPU-Angabe.
- Ein GMKtec EVO-X2 mit 128 GB Unified Memory lädt und betreibt Modelle, die in keinen mit NPU-Werten beworbenen Mittelklasse-Mini-PC passen, unabhängig vom TOPS-Marketing.
- Ein Beelink SER8 oder Geekom A8 Max mit 64 GB DDR5 und einer NPU mit ~16 TOPS ist für LLMs der 7B-Klasse wirklich ausreichend und liefert brauchbare Geschwindigkeiten: Die Arbeit erledigen die iGPU und der RAM.
Das wird sich ändern. AMDs XDNA-2-Software wird von Release zu Release besser, Microsoft bringt DirectML-NPU-Pfade in immer mehr Frameworks, und das Hexagon-Backend für llama.cpp ist inzwischen echter Code und keine Folie mehr. Bis 2027 wird das Bild für NPU-beschleunigte LLMs deutlich besser aussehen.
Aber das ist 2027. Im April 2026 ist die TOPS-Zahl auf der Verpackung nicht die Zahl, die darüber entscheidet, ob Ihr lokales LLM schnell läuft. Das Modell passt in Ihren RAM, oder eben nicht. Die iGPU hat einen funktionierenden Vulkan- oder ROCm-Pfad, oder eben nicht. Die NPU erledigt vor allem Videoanrufe und Untertitel. Wer das Datenblatt in dieser Reihenfolge liest (RAM, Bandbreite, iGPU, dann NPU), bekommt einen schnelleren Mini-PC für lokale KI als jemand, der der größten TOPS-Zahl im Regal hinterherjagt.