
2024年後半以降に発表されたミニPCには、2年前の同じ売り場には存在しなかった数値がスペックシートに載っています。TOPSです。IntelはLunar Lakeで「最大36 TOPS」とうたい、AMDはRyzen AI 300に内蔵されたXDNA 2 NPUで「最大50 TOPS」、QualcommはSnapdragon X EliteのHexagonで「45 TOPS」、AppleはM4のNeural Engineで「38 TOPS」とうたっています。どれもピーク時のINT8の数値で、技術的には比較可能ですが、いずれもマーケティングの色が濃いものです。「AIミニPC」の購入者が本当に問うべきなのは、NPUが何TOPSをうたっているかではなく、そのTOPSが今日実際に何を高速化しているかだからです。2026年4月時点で、その答えは箱の宣伝文句が示すよりも限られています。
マーケティングの層:TOPSとCopilot+の基準
ミニPCのデータシートに載っているTOPSの数値は、ほぼ例外なくNPU単体の数値です。MicrosoftのCopilot+ PCプログラムは下限を40 NPU TOPSに設定しており、これによってRecall、Cocreator、翻訳付きのライブキャプション、Windows Studio Effectsといったデバイス上の機能を搭載して出荷できるかどうかが決まります。AMDのRyzen AI 300シリーズはXDNA 2で50 TOPSを達成して基準を満たし、QualcommのSnapdragon X Eliteは45、IntelのLunar Lakeは48で基準に達しています(AnandTechのアーキテクチャ詳細解説)。それ以前のCore Ultra 100 / 200(「Meteor Lake」と「Arrow Lake」)は基準に届かず、Copilot+のブランドから外れています。ただし、これらのチップの多くは、今も「AIミニPC」として売られている製品に搭載されています。
最も扱いにくいのがAppleです。M4のNeural Engineの定格は38 TOPSで、Microsoftの基準を下回ります。それでも実際のワークロードでは、M4は名目上より高速なx86のNPUと同等か、それを上回ることがよくあります(NotebookCheckのMac mini M4 Proレビュー)。この「基準」が評価しているのは数値であって、結果ではありません。
NPUが今日実際に高速化しているもの
2026年4月時点で、WindowsやMacのミニPCで本当にNPU上で動いているワークロードは、ごく短いリストに収まります。
- Windows Studio Effects:カメラの背景ぼかし、アイコンタクト補正、音声のクリア化、フレーミング。
- Windows 11 24H2以降のライブキャプション / デバイス上での翻訳。
- アプリ固有のAI機能:AdobeのSenseiスタックのうちデバイス上で動く部分や、Microsoft 365の一部の機能など、ベンダーがNPU向けのコードパス(DirectML、ONNX Runtime QNN、OpenVINO、Core ML)を明示的に提供しているもの。
- 一部のWhisper / 小規模ASRの実装:モデルがNPUのタイルメモリに余裕を持って収まるほど小さく、ランタイムに量子化済みのグラフが用意されているもの。
一般的なユーザーが、2026年の標準構成のミニPCで実際にNPUが使われていると確認できるのは、おおむねこれですべてです。
NPUが(ほとんど)高速化していないもの
人気のローカルLLMスタック(llama.cpp、Ollama、LM Studio、KoboldCpp、text-generation-webui)は、2026年もNPUではなくCPUとiGPUの経路で動作しています。動きがないわけではありません。llama.cppは2024年後半にSnapdragonのHexagon NPUを対象とするQNNバックエンドをマージしており、DirectMLは現在WindowsでNPUの実行プロバイダーを公開しています。しかし、IntelとAMDのシリコンに限って言えば、主流のLLMツールは今もVulkan/iGPU、またはCPU上のAVX2/AVX-512を既定としています。NPUのソフトウェアスタック(IntelのOpenVINO GenAI、AMDのRyzen AI Software / XDNA)は、対応モデルの範囲が狭いか、特定の量子化形式に限られているためです。
画像生成も同じ状況です。2026年のミニPCでStable Diffusion XLやFluxを動かす場合、処理はiGPU(Intel Arc、Radeon 880M / 890M / 8060S)上で行われるか、ますます一般的になっている外付けのeGPU上で行われます。NPUで高速化したSDXLは、ベンダーのデモやOliveで最適化されたONNXビルドには存在しますが、ユーザーがAutomatic1111、ComfyUI、InvokeAIをインストールして実際に動かすものではありません。
プラットフォーム別の実情
Apple Silicon(Mac mini M4 / M4 Pro)。 Neural Engine、Metal GPU、AMX行列演算ユニットは、MLXとCore MLを通じて連携しています。7B-13BのLLMを今すぐ最も手間なく動かしたい購入者にとって、48-64 GBのユニファイドメモリを搭載したMac mini M4 Proは、私たちの見立てでは市場で最良の主流の構成です。メモリ帯域幅が高く、ツールが成熟しており、ランタイムが一本化されています。
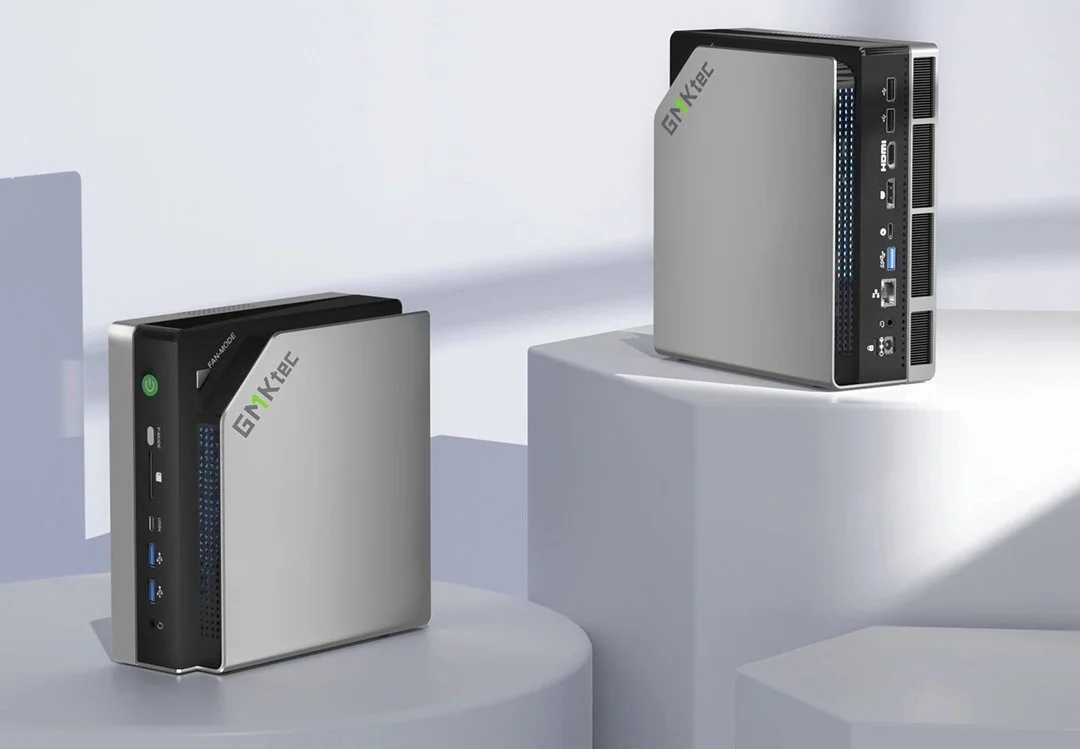
AMD Ryzen AI / Ryzen AI Max+(「Strix Halo」)。 これらのチップでLLMの主力となるのは、XDNA 2 NPUではなく、ROCmまたはVulkanで動くRadeonのiGPU(780M、8060S)です。NPUはスペック上は印象的で、Studio Effectsや一部のベンダーデモでは動作しますが、2026年4月時点の一般的なLLMの推論では、ほぼ遊んでいます。Strix Haloが勝るのはユニファイドメモリです。PhoronixとServeTheHomeはいずれも、128 GBのStrix Halo機(例:GMKtec EVO-X2)が、NPUを売りにした中級クラスのミニPCではまったく読み込めないモデルを動かせることを示しています。
Intel Core Ultra(Lunar Lake / Arrow Lake-H)。 OpenVINOは本格的にLLMに対応していますが、Ollama、LM Studio、llama.cppはいずれも、SYCL/Vulkan経由のArc iGPUかCPUを優先します。ASUS ROG NUC 14 Performanceでは、NPUはStudio Effectsと一部のUWP機能に使われており、実際に読み込むLLMはArcのグラフィックスタイル上で動作します。
Snapdragon X Elite(Hexagon NPU)。 主流のLLMランタイムからNPUへの、信頼できるマージ済みの経路があるのは、このプラットフォームだけです。それがllama.cppのQNNバックエンドです。問題は市場シェアです。Snapdragon XのミニPCは2026年のラインナップのごく一部にすぎず、Windows-on-ARMには、IntelやAMDのマシンにはないアプリ互換性の注意点が今も残っています。
2026年にミニPCを買う人にとって本当に重要なこと
用途がローカルLLMなら、2026年4月時点での正直な優先順位は、メモリ容量、次にメモリ帯域幅、次にiGPUのクラス、そしてNPU TOPSは最後です。具体例をいくつか挙げます。
- 64 GBのApple Mac mini M4 Proは、NPUの定格が低いにもかかわらず、実際のLLMのtokens-per-secondでほとんどの「50 TOPSのCopilot+」ミニPCを上回ります。
- 128 GBのユニファイドメモリを搭載したGMKtec EVO-X2は、TOPSの宣伝に関係なく、NPUを売りにした中級クラスのミニPCには収まらないモデルを読み込んで動かせます。
- 64 GBのDDR5と約16 TOPSのNPUを搭載したBeelink SER8やGeekom A8 Maxは、7BクラスのLLMを実用的な速度で動かすのに十分です。仕事をしているのはiGPUとRAMです。
この状況は変わっていくでしょう。AMDのXDNA 2ソフトウェアはリリースごとに改善しており、MicrosoftはDirectMLのNPU経路をより多くのフレームワークに広げようとしています。Hexagonのllama.cppバックエンドも、もはやスライド上の話ではなく実際のコードです。2027年には、NPUで高速化したLLMの状況は大きく改善しているはずです。
しかし、それは2027年の話です。2026年4月時点では、箱の前面に書かれたTOPSの数値は、ローカルLLMが速いかどうかを決める数値ではありません。 モデルがRAMに収まるか、収まらないか。iGPUに動作するVulkanやROCmの経路があるか、ないか。NPUが主にこなしているのはビデオ通話と字幕です。スペックシートをこの順番(RAM、帯域幅、iGPU、そしてNPU)で読む購入者は、売り場で最大のTOPSの数値を追いかける購入者よりも、ローカルAIにとって速いミニPCを手にすることになります。