
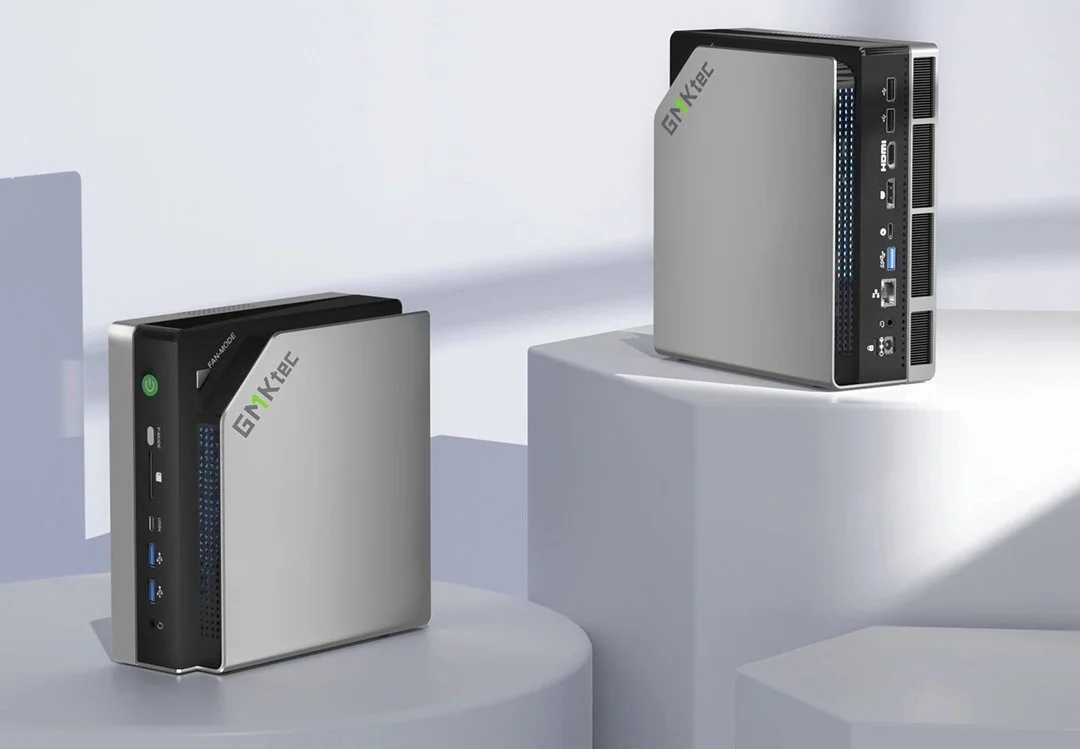
Todos los mini PCs anunciados desde la segunda mitad de 2024 incluyen en su ficha técnica una cifra que no existía en ese mismo estante hace dos años: TOPS. Intel dice “hasta 36 TOPS” en Lunar Lake. AMD dice “hasta 50 TOPS” en la NPU XDNA 2 de Ryzen AI 300. Qualcomm dice “45 TOPS” en el Hexagon de Snapdragon X Elite. Apple dice “38 TOPS” en el Neural Engine del M4. Todas son cifras pico en INT8, todas son técnicamente comparables y todas están muy moldeadas por el marketing, porque la pregunta que realmente debería hacerse quien compra un “mini PC con IA” no es cuántos TOPS promete la NPU, sino qué aceleran de verdad esos TOPS hoy. A abril de 2026, la respuesta es más limitada de lo que sugiere la caja.
La capa de marketing: los TOPS y el umbral de Copilot+
La cifra de TOPS en la ficha técnica de un mini PC es, casi sin excepción, una cifra exclusiva de la NPU. El programa de PCs Copilot+ de Microsoft fija el mínimo en 40 TOPS de NPU, y eso es lo que determina si un equipo puede venir con funciones en el dispositivo como Recall, Cocreator, Live Captions con traducción y Windows Studio Effects. La serie Ryzen AI 300 de AMD supera el umbral con 50 TOPS gracias a XDNA 2; el Snapdragon X Elite de Qualcomm lo supera con 45; Lunar Lake de Intel lo alcanza con 48 (análisis a fondo de la arquitectura en AnandTech). Los Core Ultra 100 / 200 anteriores (“Meteor Lake” y “Arrow Lake”) no llegan al corte y quedan excluidos de la marca Copilot+, aunque muchos de esos chips van dentro de equipos que se siguen vendiendo como “mini PCs con IA”.
El caso más incómodo es el de Apple. El Neural Engine del M4 está clasificado en 38 TOPS, por debajo del umbral de Microsoft, y aun así, en cargas de trabajo reales, el M4 suele igualar o superar a NPU x86 nominalmente más rápidas (reseña del Mac mini M4 Pro en NotebookCheck). El “umbral” premia una cifra, no un resultado.
Lo que las NPU aceleran realmente hoy
En abril de 2026, las cargas de trabajo que de verdad se ejecutan en una NPU en un mini PC con Windows o Mac son una lista corta:
- Windows Studio Effects: desenfoque del fondo de la cámara, corrección del contacto visual, claridad de voz y encuadre.
- Live Captions / traducción en el dispositivo en Windows 11 24H2 y posteriores.
- Funciones de IA de apps concretas, como las partes en el dispositivo del stack Sensei de Adobe y un puñado de funciones de Microsoft 365, en las que el fabricante incluyó explícitamente una ruta de código para la NPU (DirectML, ONNX Runtime QNN, OpenVINO o Core ML).
- Algunas implementaciones de Whisper / ASR pequeñas, en las que el modelo es lo bastante pequeño para caber con holgura en la memoria de tiles de la NPU y el runtime tiene listo un grafo cuantizado.
Esa es, a grandes rasgos, la lista completa de cosas que el usuario promedio puede comprobar que realmente usan la NPU en un mini PC de 2026 de fábrica.
Lo que las NPU (en su mayoría) no aceleran
El stack popular de LLM locales (llama.cpp, Ollama, LM Studio, KoboldCpp, text-generation-webui) funciona sobre la CPU y la iGPU en 2026, no sobre la NPU. Aquí sí hay avances reales: llama.cpp integró un backend QNN orientado a la NPU Hexagon de Snapdragon a finales de 2024, y DirectML ya ofrece un proveedor de ejecución para NPU en Windows. Pero en el silicio de Intel y AMD en particular, las herramientas de LLM más extendidas siguen usando por defecto Vulkan/iGPU o AVX2/AVX-512 en la CPU, porque las pilas de software de las NPU (OpenVINO GenAI en Intel, Ryzen AI Software / XDNA en AMD) tienen una cobertura de modelos limitada o se restringen a formatos de cuantización específicos.
La generación de imágenes cuenta la misma historia. Stable Diffusion XL y Flux se ejecutan en un mini PC de 2026 sobre la iGPU (Intel Arc, Radeon 880M / 890M / 8060S) o, cada vez con más frecuencia, sobre una eGPU dedicada. SDXL acelerado por NPU existe en demos de fabricantes y en builds ONNX optimizadas con Olive, pero no es lo que los usuarios ejecutan de verdad cuando instalan Automatic1111, ComfyUI o InvokeAI.
La realidad por plataforma
Apple Silicon (Mac mini M4 / M4 Pro). El Neural Engine, la GPU Metal y las unidades matriciales AMX se coordinan a través de MLX y Core ML. Para quien quiere ejecutar hoy un LLM de 7B-13B con la menor fricción, un Mac mini M4 Pro con 48-64 GB de memoria unificada es, según nuestro análisis, la mejor plataforma convencional del mercado: alto ancho de banda de memoria, herramientas maduras y un único runtime.
AMD Ryzen AI / Ryzen AI Max+ (“Strix Halo”). El caballo de batalla para LLM en estos chips es la iGPU Radeon (780M, 8060S) con ROCm o Vulkan, no la NPU XDNA 2. La NPU impresiona sobre el papel y se activa con Studio Effects y un pequeño conjunto de demos de fabricantes, pero para servir LLM de uso general en abril de 2026 está casi siempre inactiva. Donde Strix Halo gana es en la memoria unificada: tanto Phoronix como ServeTheHome han mostrado que un equipo Strix Halo con 128 GB (por ejemplo, el GMKtec EVO-X2) ejecuta modelos que ningún mini PC de gama media centrado en su NPU puede siquiera cargar.
Intel Core Ultra (Lunar Lake / Arrow Lake-H). OpenVINO tiene soporte real para LLM, pero Ollama, LM Studio y llama.cpp prefieren la iGPU Arc mediante SYCL/Vulkan o la CPU. En un ASUS ROG NUC 14 Performance, la NPU contribuye a Studio Effects y a un puñado de funciones UWP; el LLM que realmente cargas se ejecuta en el tile gráfico Arc.
Snapdragon X Elite (NPU Hexagon). Esta es la única plataforma con una ruta creíble e integrada desde un runtime de LLM popular hasta la NPU: el backend QNN de llama.cpp. El problema es la cuota de mercado: los mini PCs con Snapdragon X son una porción mínima de la oferta de 2026, y Windows en ARM todavía tiene salvedades de compatibilidad de aplicaciones que los equipos Intel y AMD no tienen.
Lo que realmente importa al comprar un mini PC en 2026
Si el caso de uso son los LLM locales, el orden de prioridad honesto en abril de 2026 es capacidad de memoria, luego ancho de banda de memoria, luego categoría de la iGPU y, solo al final, TOPS de la NPU. Algunos ejemplos concretos:
- Un Apple Mac mini M4 Pro con 64 GB supera a la mayoría de los mini PCs “Copilot+ de 50 TOPS” en tokens por segundo reales de LLM, a pesar de tener una NPU con menor clasificación.
- Un GMKtec EVO-X2 con 128 GB de memoria unificada carga y ejecuta modelos que no caben en ningún mini PC de gama media centrado en su NPU, sin importar el marketing de TOPS.
- Un Beelink SER8 o un Geekom A8 Max con 64 GB de DDR5 y una NPU de ~16 TOPS es realmente suficiente para LLM de clase 7B a velocidades utilizables: la iGPU y la RAM hacen el trabajo.
Esto va a cambiar. El software XDNA 2 de AMD mejora con cada versión, Microsoft está llevando las rutas de NPU de DirectML a más frameworks y el backend Hexagon de llama.cpp ya es código real, no una diapositiva. Para 2027, el panorama de los LLM acelerados por NPU será bastante mejor.
Pero eso será en 2027. En abril de 2026, la cifra de TOPS en el frente de la caja no es la que determina si tu LLM local es rápido. El modelo cabe en tu RAM o no cabe. La iGPU tiene una ruta funcional de Vulkan o ROCm o no la tiene. La NPU se dedica sobre todo a videollamadas y subtítulos. Quien lea la ficha técnica en ese orden (RAM, ancho de banda, iGPU y luego NPU) terminará con un mini PC más rápido para IA local que quien persiga la cifra de TOPS más alta del estante.