
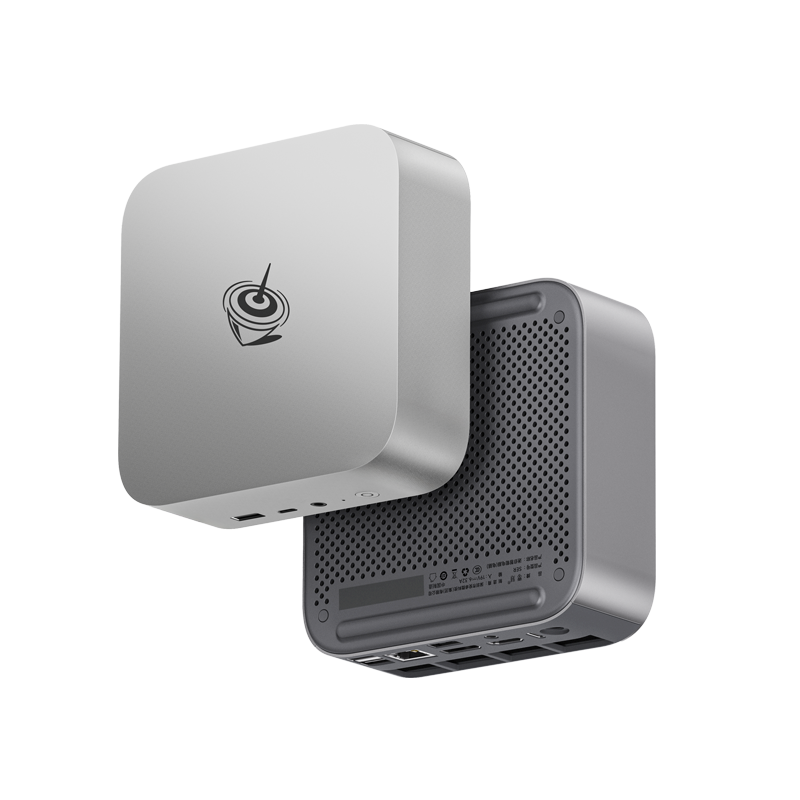
In der Diskussion um lokale KI gibt es eine leise Wahrheit, die von jeder Benchmark-Schlagzeile über ein Modell mit 70 Milliarden Parametern auf einer $4,000-Workstation übertönt wird: Die meisten Menschen brauchen dieses Modell nicht. Sie brauchen eines mit 7 Milliarden Parametern, das auf dem Desktop läuft, den sie bereits besitzen, in ein paar Sekunden antwortet und weder eine dedizierte GPU noch ein Stromkontingent wie im Serverraum oder eine zweite Hypothek erfordert. Stand April 2026 ist die Mini-PC-Klasse, die genau das liefert (Systeme mit AMD Ryzen 7 8845HS und Ryzen 9 8945HS sowie 32 bis 64 GB DDR5), die am wenigsten beachtete Hardware im Ökosystem lokaler LLMs.
Die Geräte tragen bekannte Namen: der Beelink SER8 für rund $649, der Geekom A8 Max für etwa $721 in der getesteten Konfiguration (Liliputing), der Minisforum UM890 Pro und der GMKtec K8 Plus, der im Angebot schon für $399 zu sehen war. Gemeinsam ist ihnen ein Gehäusevolumen von etwa 0,5 bis 0,7 Litern, eine 8-Kern-CPU mit Zen 4, eine integrierte Radeon 780M, zwei SO-DIMM-Steckplätze für bis zu DDR5-5600 und eine XDNA-1-Neural-Engine mit 16 TOPS. Laut AMDs eigenen Spezifikationen unterscheiden sich 8845HS und 8945HS vor allem beim CPU-Takt; iGPU und NPU sind identisches Silizium.
Die Grenze setzt die Speicherbandbreite, nicht die Kernzahl
Lokale LLM-Inferenz ist bei den Batch-Größen, die ein einzelner Mensch nutzt, fast ausnahmslos durch die Speicherbandbreite begrenzt. Eine Dual-Channel-Konfiguration mit DDR5-5600 erreicht theoretisch maximal rund 89,6 GB/s, in STREAM-artigen Benchmarks liegen die realen Werte bei 80 bis 86 GB/s. Das ist ein Bruchteil des Unified-Memory-Pools eines Apple-M-Chips oder einer AMD-Strix-Halo-Plattform, und diese eine Zahl erklärt jede andere Zahl in diesem Artikel. Entscheidend ist aber: Sie reicht aus.
Ein Modell mit 7 Milliarden Parametern in einer 5-Bit-Quantisierung (Q5_K_M, rund 5,5 GB auf der Festplatte) muss diese 5,5 GB für jedes erzeugte Token einmal durch den Speicher schieben. Bei 80 GB/s nutzbarer Bandbreite liegt die theoretische Obergrenze bei etwa 14 Tokens pro Sekunde, die praktische wegen des Overheads etwas darunter. Erfahrungsberichte auf r/LocalLLaMA und in den Benchmark-Diskussionen von llama.cpp sehen Llama 3.1 8B Q5_K_M durchweg bei 8 bis 14 Tokens pro Sekunde auf 8845HS-Systemen, die das llama.cpp-Vulkan-Backend auf der Radeon 780M nutzen; Mistral 7B Q5_K_M bewegt sich im selben Rahmen. Das ist schneller, als die meisten Menschen lesen, und es geschieht auf einer nahezu lüfterlosen Box, die im Leerlauf rund 8 Watt aufnimmt.
Was komfortabel läuft, was an Grenzen stößt, was stockt
Bei der Klasse mit 13 bis 14 Milliarden Parametern wird der günstige Mini-PC von der beiläufigen zur bewussten Wahl. Qwen 2.5 14B und Llama 3 13B in Q4_K_M-Quantisierungen sind rund 7 bis 8 GB groß und liefern in Community-Tests auf derselben Hardware 4 bis 8 Tokens pro Sekunde. Phi-3 medium 14B Q4 fällt in denselben Bereich. Brauchbar in dem Sinne, dass eine Antwort von einem Absatz in unter einer Minute eintrifft; nicht flott in dem Sinne, dass niemand sie mit einer gehosteten API verwechseln wird.
Abseits der Textgenerierung sieht es freundlicher aus. Die Whisper-Transkription mit dem Medium-Modell läuft in Echtzeit oder schneller. Sentence-Transformer-Embedding-Modelle, das Arbeitspferd jeder lokalen RAG-Pipeline, verarbeiten einen Absatz in Millisekunden. Nicht komfortabel laufen dagegen die Klasse mit 30 Milliarden Parametern, alles, was 32 GB Arbeitsspeicher sprengt, sobald Kontext und KV-Cache eingerechnet sind, sowie Bildgenerierung: Stable Diffusion XL bleibt auf der Radeon 780M langsam, und die Vulkan-Tests von Phoronix zeigen deutlich, dass die Stärke der 780M im Durchsatz bei kleinen Modellen liegt, nicht in der Parallelität bei Diffusionsgraphen.
Der Software-Stack, ehrlich betrachtet
Der reine CPU-Weg ist der langweilige und zugleich der zuverlässigste: llama.cpp ohne Beschleunigungsoptionen läuft auf jedem Mini-PC dieser Klasse ab Werk und erreicht 5 bis 10 tok/s mit einem 7B-Q5-Modell. Die interessante Entwicklung von 2025 und Anfang 2026 ist das Vulkan-Backend, das so weit gereift ist, dass die Radeon 780M ein glaubwürdiger Beschleuniger für quantisierte Inferenz ist: Im Vulkan-Diskussionsthread von llama.cpp berichten Community-Mitglieder von 12 bis 18 tok/s bei 7B-Modellen in Q4 bis Q5, ein spürbarer Fortschritt gegenüber der CPU.
ROCm auf der 780M bleibt der holprigere Weg. Es funktioniert, es ist schneller als die CPU, wenn es funktioniert, und es ist die Option, die am ehesten nach einem Kernel-Update kaputtgeht.
Die XDNA-NPU, die 16-TOPS-Neural-Engine, die AMD als Herzstück von „Ryzen AI“ vermarktet hat, ist der Teil dieser Geschichte, der die meiste Offenheit verlangt. Wie ServeTheHome und andere dokumentiert haben, ist der allgemeine LLM-Software-Stack für XDNA im April 2026 noch unausgereift. Die meisten Nutzer lokaler LLMs verwenden die NPU überhaupt nicht. Die Community hat sich pragmatisch auf Vulkan auf der iGPU als Weg des geringsten Widerstands geeinigt. Passend dazu: unser Ratgeber NPU vs. iGPU vs. CPU für lokale LLMs und der Test des Beelink SER8.
Das Fazit
Für die meisten Menschen ist ein Ryzen-8845HS-Mini-PC für $700 mit 32 GB DDR5-5600 mehr als genug lokale KI. Er führt einen Assistenten der Klasse Llama 3.1 8B in menschlicher Lesegeschwindigkeit aus, transkribiert Meetings in Echtzeit, erstellt Embeddings eines persönlichen Dokumentenbestands in Sekunden und erledigt all das in einer Schreibtischecke mit einem Strombedarf, der eher einer Glühbirne als einer Workstation entspricht. Die ehrliche Einschränkung: Die iGPU ist langsamer als eine dedizierte GPU in derselben Preisklasse, und die NPU leistet noch nicht, was ihre Spezifikationen nahelegen. Die ehrliche Neubewertung: Für die Modellklasse, die die meisten Nutzer tatsächlich brauchen, spielt nichts davon eine Rolle. Die Frage, die sich vor dem Kauf einer $2,000-GPU für lokale KI lohnt, lautet nicht „Wie groß darf mein Modell sein?“, sondern „Wie groß muss mein Modell tatsächlich sein?“. Für sehr viele Leser passt die Antwort in sieben Milliarden Parameter, und sie passt in einen Mini-PC, der schon weniger kostet als die GPU allein.