
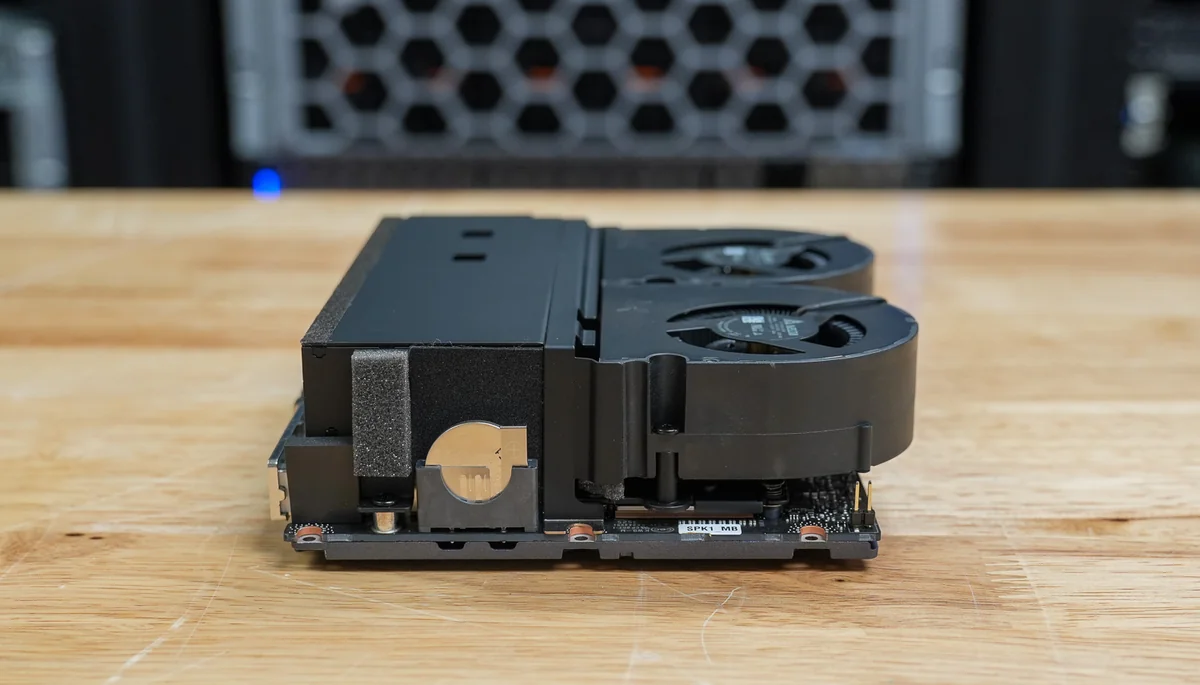
GIGABYTE AI TOP ATOMとは
GIGABYTE AI TOP ATOMは、NVIDIAのGB10 Grace Blackwell Superchipを中心に構築された約1リットルのデスクトップです。このGrace ArmとBlackwell GPUを組み合わせたシリコンは、NVIDIA自身のDGX SparkやASUS Ascent GX10にも使われています。汎用のミニPCではありません。SSD構成に応じて**$3,499〜$3,999**で販売されるパーソナルAIワークステーションであり、クラウドGPUを借りることなく、手元のデスクで大規模言語モデルをローカルに実行し、ファインチューニングするという1つの仕事を非常にうまくこなすために設計されています。
GIGABYTEが手がけているのは、チップを収める筐体の部分です。GB10プラットフォーム(20コアArm CPU、Blackwell GPU、128 GBのLPDDR5xユニファイドメモリ、NVIDIAのAIソフトウェアスタック)はNVIDIAが定めているため、GB10を搭載した「Sparkクラス」のマシンは、どれも事実上同じ演算性能で出荷されます。パートナー各社が差別化できるのは、冷却、SSDの世代、ネットワーク、価格、サポートです。こうしたマシンを複数テストしたServeTheHomeは、AI TOP ATOMを**「これまでで最速のSpark」**と評しました。メーカーが性能を動かせる余地がほとんどないことを考えると、意味のある評価です。
得意な用途(ローカルAI / LLM開発)
最大の数字は128 GBのユニファイドメモリです。Grace CPUとBlackwell GPUがNVLink-C2Cを介して1つのメモリプールを共有しているため、GPUは128 GB全体にアクセスできます。これは2,000億パラメータのモデルをメモリに載せられる容量で、ConnectX-7で接続した2台のATOMに分割すれば405Bのモデルも動かせます。これこそが売りのすべてです。本来ならデータセンター向けの単体GPUが複数必要になるモデルが、片腕で抱えて運べる箱に収まります。
具体的には、AI TOP ATOMは次の用途を想定して作られています。
- ローカルでのLLM推論とプロトタイピング:70Bクラスのモデルを余裕を持って動かせるほか、24〜32 GBのコンシューマー向けGPUではそもそも読み込めない100B〜200Bのモデルも実行できます。
- 中規模モデルのファインチューニングとLoRA作業を、クラウドからのデータ転送費用や時間単位の課金なしで行えます。
- 本物のCUDAスタックを使ったAI開発:DGXやクラウドのH100にデプロイするときと同じドライバー、コンテナ、ライブラリを使えるため、コードを書き直さずにそのまま上位の環境へ移行できます。
- クリエイター作業やオフィス作業は副次的な役割です。Arm Linuxのデスクトップアプリは問題なく動きますが、それが購入する理由にはなりません。
7B〜13Bのモデルを、より安価でWindowsが使いやすいマシンで動かしたいのであれば、GMKtec EVO-X2のようなStrix Halo機や、Mac mini M4 Proのほうが賢いお金の使い方です。ATOMがその価格に見合うのは、128 GBという上限が本当に必要な場合だけです。その境界線がどこにあるかは、NPU、iGPU、CPUの比較解説で取り上げています。
GB10スーパーチップとユニファイドメモリ
GB10は、20コアのArm CPU(Cortex-X925高性能コア × 10 + Cortex-A725高効率コア × 10)とBlackwell GPUを組み合わせ、両者をNVLink-C2Cで結んでいるため、その間にPCIeのボトルネックはありません。NVIDIAはこのプラットフォームの性能を**FP4で1 PetaFLOP(1,000 TOPS)**としています。FP4は、最新の推論エンジンが頼りにしているスパースな低精度演算フォーマットです。
このFP4の数値は本物ですが、正しく読み取る必要があります。これは行列演算のピークスループットを示すもので、トークンがどれだけ速く出てくるかを示すものではありません。推論において実際の制約となるのは、ほぼ常にメモリ帯域幅であり、それについては後のセクションで詳しく扱います。
筐体、接続性、クラスタリング
筐体は質素と言えるほどミニマルです。約1リットルの黒いブロック(約150 × 150 × 51 mm、約1.2 kg)で、前面にポートは一切なく(電源ボタンさえ背面にあります)、前から後ろへすっきりと空気が流れる構造です。レビュアーは一様に、ATOMは低温で静かに動作すると指摘しています。ServeTheHomeが「最速のSpark」と評した主な理由もそこにあり、冷却性能が高いほど、GB10は高負荷が続いてもクロックを長く維持できます。
背面の接続性は、ネットワークを最優先した構成です。
- 200GbE ConnectX-7 × 2(QSFP):目玉となる機能で、2台のATOMをつないで405Bパラメータの2台構成モードを実現するのに使います。
- 通常のLAN用の10GbE(銅線)に加え、Wi-Fi 7とBluetooth 5.3。
- 映像出力用にUSB-C × 4(USB 3.2 Gen2x2、20 Gbps、DisplayPort Altモード対応)とHDMI 2.1a。
知っておくべき注意点が1つあります。ServeTheHomeの指摘によると、ConnectX-7のNICは単一のx8ではなく、2本のPCIe x4リンクとしてGB10に接続されています。そのため、デュアルポートの200GbEは、1本の太い400Gの経路というより、分割されたインターフェースのように振る舞います。1台だけを購入するほとんどの人にとっては机上の話ですが、2ノードの密なクラスタリングを計画している人は、それを前提に構成を組む前に理解しておく価値があります。
メモリ帯域幅:実用上の上限
これが最も重要な数字であり、同時にマーケティングが埋もれさせている数字でもあります。128 GBのLPDDR5xの帯域幅は約273 GB/sです。1リットルのマシンとしては優秀ですが、単体GPUと比べるとほんの一部にすぎません。RTX 5090は1.7 TB/sを優に超えます。
トークン生成はメモリ帯域幅に左右されるため、大規模モデルでのATOMのスループットは、絶対値で見れば控えめです。5090では物理的に読み込めない120Bのモデルも読み込んで実行できますが、トークンの出力ペースは、FP4で1 PetaFLOPという宣伝文句から想像するよりも落ち着いたものになります。正しい考え方は、GB10は純粋な速度と引き換えに容量を得ている、というものです。このサイズと価格では他のどこにも収まらないモデルを動かすために買うものであり、32 GBに収まるモデルで1秒あたりのトークン数をゲーミングGPUと競うためのものではありません。この速度より容量を優先するトレードオフは、単体GPU搭載のミニPCが小型モデルでは依然として速い一方、大型モデルではすぐに頭打ちになるのと同じ理由です。
価格と購入先
GIGABYTEはAI TOP ATOMを3つの構成で販売しています。いずれも同じGB10と128 GBのメモリを搭載しており、異なるのはSSDだけです。
- $3,499:1 TB PCIe Gen4 NVMe
- $3,899:4 TB PCIe Gen4 NVMe
- $3,999:4 TB PCIe Gen5 NVMe
Amazonで販売されており(確認済みの出品は4 TB構成)、下のアフィリエイトリンクは米国の現行の出品につながっています。この価格であれば、ATOMは通常、NVIDIA自身のDGX Spark(DRAM価格の変動を受けて約$3,999〜$4,699まで上昇しています)より安く、GB10ラインナップの中でもコストパフォーマンスに優れた1台です。メーカー間の差別化はわずかなので、サポートが重要になります。GIGABYTEはAVADirectと提携し、米国で翌営業日のオンサイト修理を提供しています。関連記事:MSI EdgeXpert MS-C931とAcer Veriton GN100も、同じラインナップに属するGB10マシンです。
注意すべき点
- 制約となるのは演算性能ではなく帯域幅。 273 GB/sということは、大規模モデルでのトークン生成スループットは安定しているものの、爆速ではありません。それを踏まえて期待値を設定してください。
- DGX OSはデスクトップではなく開発者向け環境。 NVIDIAのスタックを備えたArm Linuxで、AI作業には最高ですが、Windowsマシンではなく、汎用の生産性PCでもありません。
- すべてがオンボード実装。 128 GBのメモリは固定で、購入時に選べるのはSSDの構成だけです。あとからアップグレードする手段はありません。
- 分割されたConnectX-7のレーン。 デュアル200GbEのNICはx4 × 2として動作するため、最もすっきりした2ノードのクラスタリング構成には制約があります。
- 設計からしてニッチ。 $3,499以上という価格では、128 GBのユニファイドメモリという上限が特に必要な場合にしか意味がありません。7B〜13Bのモデルなら、はるかに安いハードウェアのほうが有利です。
結論
GIGABYTE AI TOP ATOMは完成度の高いGB10マシンであり、現行のSparkクラスの中でおそらく最も冷却性能が高く、最も価格設定に優れた1台です。ServeTheHomeの「これまでで最速のSpark」という評価も、まさにそれを反映しています。存在意義である1つの仕事を誠実にこなします。つまり、2,000億パラメータのモデルを、4,000ドル未満で、静かにあなたのデスクに置いてくれます。
ただし、正しい理由で購入してください。どのコンシューマー向けGPUにも収まらない大規模なモデルを実行、ファインチューニング、反復改良する必要があるAI開発者や研究者で、互換レイヤーではなくNVIDIAの本物のCUDAスタックを使いたいのであれば、ATOMは自信を持っておすすめできる製品であり、GB10の兄弟機の中でもコストパフォーマンスに優れた選択肢です。主に小型モデルを動かす場合や、高速な汎用デスクトップが欲しかった場合には、このマシンは適していません。Strix Halo搭載のミニPCやFramework Desktopのほうが、より安く、より役に立つでしょう。