
Qué es el GIGABYTE AI TOP ATOM
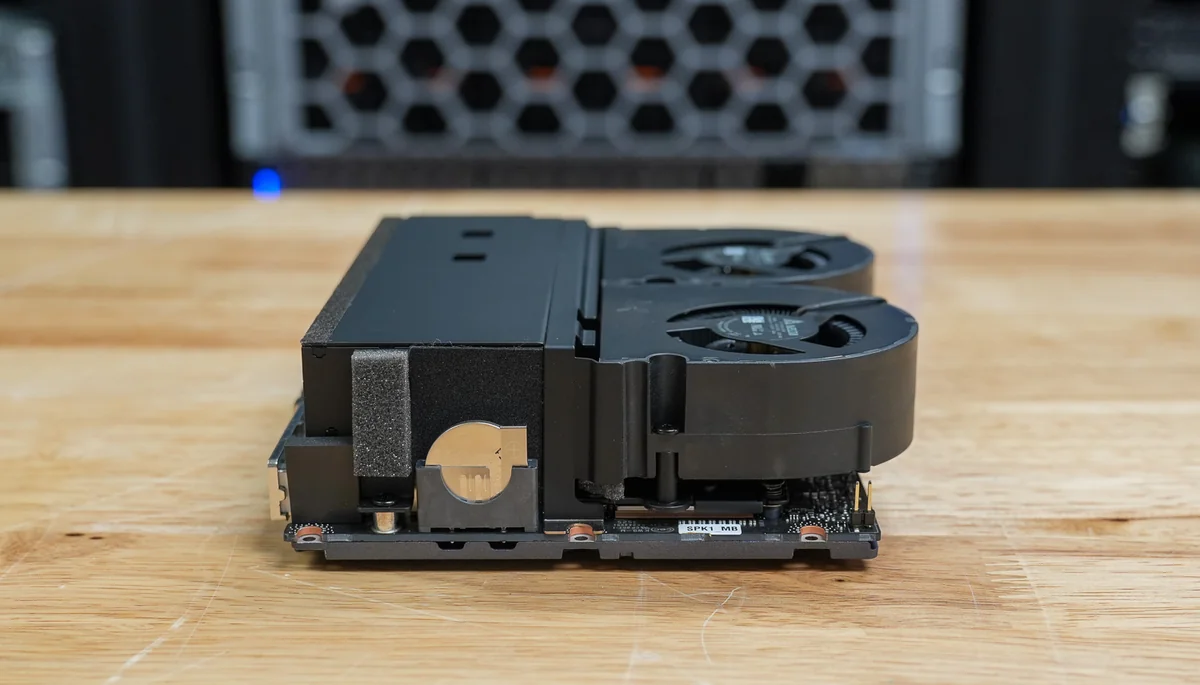
El GIGABYTE AI TOP ATOM es un equipo de escritorio de aproximadamente un litro construido alrededor del GB10 Grace Blackwell Superchip de NVIDIA, el mismo silicio Grace Arm más GPU Blackwell que impulsa el propio DGX Spark de NVIDIA y el ASUS Ascent GX10. No es un mini PC de uso general. Es una estación de trabajo de IA personal, que se vende entre $3,499 y $3,999 según la configuración de SSD, diseñada para hacer una sola cosa muy bien: ejecutar y ajustar modelos de lenguaje grandes en local, en tu escritorio, sin alquilar GPU en la nube.
El aporte de GIGABYTE es la caja que rodea al chip. NVIDIA define la plataforma GB10 (CPU Arm de 20 núcleos, GPU Blackwell, 128 GB de LPDDR5x unificada, el stack de software de IA de NVIDIA), así que todas las máquinas GB10 de “clase Spark” salen con una potencia de cómputo prácticamente idéntica. Lo que diferencia a los fabricantes es la refrigeración, la generación del SSD, la conectividad de red, el precio y el soporte. ServeTheHome, que probó varias de estas cajas, calificó al AI TOP ATOM como “el Spark más rápido hasta ahora”, un reconocimiento significativo dado el poco margen que tienen los fabricantes para marcar la diferencia.
Para qué sirve (IA local / desarrollo de LLM)
La cifra principal es 128 GB de memoria unificada. Como la CPU Grace y la GPU Blackwell comparten un único bloque de memoria a través de NVLink-C2C, la GPU puede direccionar los 128 GB completos, suficiente para alojar en memoria un modelo de 200 mil millones de parámetros, o un modelo de 405B repartido entre dos ATOM conectados por ConnectX-7. Esa es toda la propuesta: un modelo que necesitaría varias GPU dedicadas de centro de datos cabe en una caja que puedes llevar bajo el brazo.
En concreto, el AI TOP ATOM está pensado para:
- Inferencia y prototipado de LLM en local: ejecutar modelos de clase 70B con holgura, y modelos de 100B–200B que simplemente no cargan en una GPU de consumo de 24–32 GB.
- Ajuste fino y trabajo con LoRA en modelos medianos, sin costos de salida de datos de la nube ni facturación por hora.
- Desarrollo de IA sobre el stack CUDA real: los mismos drivers, contenedores y bibliotecas que desplegarías en un DGX o en una H100 en la nube, así que tu código escala sin reescribirlo.
- Tareas creativas y de oficina como función secundaria: ejecuta bien las aplicaciones de escritorio de Arm Linux, pero no es la razón para comprarlo.
Si lo que te interesa es ejecutar modelos de 7B–13B en una máquina más barata y compatible con Windows, una caja Strix Halo como el GMKtec EVO-X2 o incluso un Mac mini M4 Pro es una compra más sensata. El ATOM solo justifica su precio cuando de verdad necesitas el techo de 128 GB. Nuestro análisis de NPU vs iGPU vs CPU explica dónde está ese límite.
El superchip GB10 y la memoria unificada
El GB10 combina una CPU Arm de 20 núcleos (10× núcleos de rendimiento Cortex-X925 + 10× núcleos de eficiencia Cortex-A725) con una GPU Blackwell, unidas por NVLink-C2C para que no haya un cuello de botella PCIe entre ellas. NVIDIA clasifica la plataforma en 1 PetaFLOP (1,000 TOPS) de cómputo FP4, el formato matemático disperso de baja precisión en el que se apoyan los motores de inferencia modernos.
Esa cifra FP4 es real, pero hay que leerla bien: describe el rendimiento máximo en operaciones de matrices, no la velocidad a la que salen los tokens. Para la inferencia, la restricción determinante es casi siempre el ancho de banda de memoria, y ese es el tema de su propia sección más abajo.
Construcción, conectividad y clústeres
El chasis es minimalista hasta llegar a lo austero: un bloque negro de ~1 litro (aproximadamente 150 × 150 × 51 mm, unos 1.2 kg) sin ningún puerto frontal (incluso el botón de encendido está atrás) y un flujo de aire limpio de adelante hacia atrás. Las reseñas coinciden en que el ATOM funciona fresco y silencioso, que es la razón principal por la que ServeTheHome le dio el título de “Spark más rápido”: unas mejores temperaturas permiten que el GB10 mantenga sus frecuencias por más tiempo bajo carga sostenida.
La conectividad trasera prioriza la red:
- Doble 200GbE ConnectX-7 (QSFP): la función estrella, usada para enlazar dos ATOM en ese modo de dos sistemas para modelos de 405B parámetros.
- 10GbE de cobre para la LAN normal, además de Wi-Fi 7 y Bluetooth 5.3.
- 4× USB-C (USB 3.2 Gen2x2, 20 Gbps, con DisplayPort alt-mode) y HDMI 2.1a para salida de video.
Una advertencia que conviene conocer: ServeTheHome señaló que la NIC ConnectX-7 se conecta al GB10 mediante dos enlaces PCIe x4 en lugar de un solo x8, así que el 200GbE de doble puerto se comporta más como interfaces segmentadas que como un único canal amplio de 400G. Para la mayoría de los compradores de una sola unidad esto es académico; para quien planee un clúster de dos nodos muy ajustado, vale la pena entenderlo antes de diseñar la arquitectura en torno a ello.
Ancho de banda de memoria: el techo en el uso real
Esta es la cifra que más importa y la que el marketing esconde. Los 128 GB de LPDDR5x entregan aproximadamente 273 GB/s de ancho de banda. Es excelente para una máquina de un litro, pero es una fracción de lo que ofrece una GPU dedicada. Una RTX 5090 mueve bastante más de 1.7 TB/s.
Como la generación de tokens depende del ancho de banda, el rendimiento del ATOM con modelos grandes es modesto en términos absolutos. Cargará y ejecutará un modelo de 120B que una 5090 físicamente no puede, pero generará tokens a un ritmo más pausado de lo que la cifra de un PetaFLOP FP4 podría hacerte esperar. El modelo mental correcto: el GB10 cambia velocidad bruta por capacidad. Lo compras para ejecutar modelos que no caben en ningún otro lado con este tamaño y precio, no para superar a una GPU gamer en tokens por segundo con modelos que caben en 32 GB. Ese intercambio de capacidad por velocidad es la misma razón por la que los mini PC con GPU dedicada siguen siendo más rápidos con modelos pequeños, pero se quedan cortos pronto con los grandes.
Precio y dónde comprarlo
GIGABYTE vende el AI TOP ATOM en tres configuraciones, todas con el mismo GB10 y 128 GB de memoria; solo cambia el SSD:
- $3,499: NVMe PCIe Gen4 de 1 TB
- $3,899: NVMe PCIe Gen4 de 4 TB
- $3,999: NVMe PCIe Gen5 de 4 TB
Está listado en Amazon (la configuración de 4 TB es el listado verificado), así que el enlace de afiliado de abajo apunta a un listado activo en EE. UU. A estos precios, el ATOM suele quedar por debajo del propio DGX Spark de NVIDIA (que ha subido hacia ~$3,999–$4,699 en medio de las variaciones de precio de la DRAM), lo que convierte a la caja de GIGABYTE en una de las opciones con mejor relación calidad-precio de la línea GB10. La diferenciación entre fabricantes es mínima, así que el soporte importa: GIGABYTE se asocia con AVADirect para ofrecer reparación en sitio al siguiente día hábil en EE. UU. Relacionado: el MSI EdgeXpert MS-C931 y el Acer Veriton GN100 son otras máquinas GB10 de la misma línea.
Lo que señalaríamos
- El límite es el ancho de banda, no el cómputo. 273 GB/s significa que la generación de tokens con modelos grandes es constante, no vertiginosa. Ajusta tus expectativas en consecuencia.
- DGX OS es un entorno de desarrollo, no un escritorio. Es Arm Linux con el stack de NVIDIA, excelente para trabajo de IA, pero no es una máquina Windows ni un PC de productividad general.
- Todo va soldado. Los 128 GB de memoria son fijos; solo el SSD es una opción de configuración, que se elige al comprar. No hay forma de ampliarlo después.
- Carriles ConnectX-7 segmentados. La NIC de doble 200GbE funciona como 2× x4, lo que limita el escenario más limpio de clúster de dos nodos.
- De nicho por diseño. Desde $3,499, solo tiene sentido si necesitas específicamente el techo de 128 GB de memoria unificada. Para modelos de 7B–13B, un hardware mucho más barato gana.
Veredicto
El GIGABYTE AI TOP ATOM es una máquina GB10 bien ejecutada, posiblemente la mejor refrigerada y con mejor precio de las cajas de clase Spark actuales, que es justo lo que refleja el veredicto de “el Spark más rápido hasta ahora” de ServeTheHome. Cumple con honestidad la única tarea para la que existe: pone un modelo de 200 mil millones de parámetros en tu escritorio, en silencio, por menos de cuatro mil dólares.
Eso sí, cómpralo por la razón correcta. Si eres un desarrollador o investigador de IA que necesita ejecutar, ajustar e iterar sobre modelos demasiado grandes para cualquier GPU de consumo, y quieres el stack CUDA real de NVIDIA en lugar de una capa de compatibilidad, el ATOM es una recomendación segura, y la opción de mejor valor entre sus hermanos GB10. Si sobre todo ejecutas modelos pequeños, o querías un equipo de escritorio rápido de uso general, esta es la herramienta equivocada, y un mini PC Strix Halo o el Framework Desktop te servirán mejor por menos dinero.