
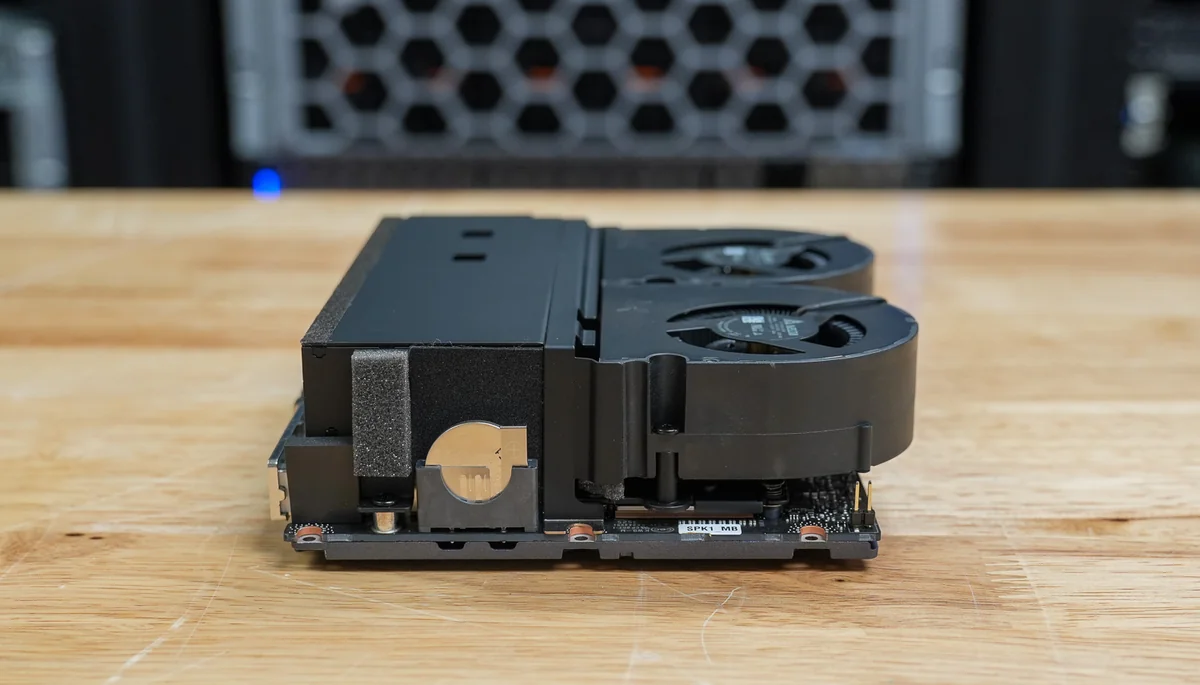
GIGABYTE AI TOP ATOM은 어떤 제품인가
GIGABYTE AI TOP ATOM은 NVIDIA의 GB10 Grace Blackwell Superchip을 중심으로 만든 약 1리터 크기의 데스크톱으로, NVIDIA 자체 DGX Spark와 ASUS Ascent GX10에 들어간 것과 같은 Grace Arm CPU + Blackwell GPU 실리콘을 사용합니다. 범용 미니 PC가 아닙니다. SSD 구성에 따라 $3,499에서 $3,999 사이에 판매되는 개인용 AI 워크스테이션으로, 한 가지 일을 아주 잘 해내도록 설계되었습니다. 클라우드 GPU를 빌리지 않고, 책상 위에서 대규모 언어 모델을 로컬로 실행하고 파인튜닝하는 일입니다.
GIGABYTE의 몫은 칩을 감싸는 본체입니다. NVIDIA가 GB10 플랫폼(20코어 Arm CPU, Blackwell GPU, 128 GB 통합 LPDDR5x, NVIDIA AI 소프트웨어 스택)을 정의하기 때문에, 모든 GB10 “Spark급” 기기는 사실상 동일한 연산 성능으로 출고됩니다. 파트너사들이 차별화하는 부분은 냉각, SSD 세대, 네트워킹, 가격, 지원입니다. 이런 기기를 여러 대 테스트한 ServeTheHome은 AI TOP ATOM을 **“지금까지 가장 빠른 Spark”**라고 평가했는데, 제조사가 성능을 끌어올릴 여지가 거의 없다는 점을 감안하면 의미 있는 평가입니다.
어디에 적합한가 (로컬 AI / LLM 개발)
핵심 수치는 128 GB 통합 메모리입니다. Grace CPU와 Blackwell GPU가 NVLink-C2C를 통해 하나의 메모리 풀을 공유하므로, GPU는 128 GB 전체에 접근할 수 있습니다. 200B 파라미터 모델을 메모리에 올리기에 충분하며, ConnectX-7로 연결한 ATOM 2대에 405B 모델을 나눠 올릴 수도 있습니다. 이것이 이 제품의 핵심입니다. 데이터센터용 개별 GPU가 여러 개 필요할 모델이 한 팔에 끼고 다닐 수 있는 상자에 들어갑니다.
구체적으로 AI TOP ATOM은 다음 용도로 만들어졌습니다.
- 로컬 LLM 추론 및 프로토타이핑: 70B급 모델을 여유 있게 실행하고, 24–32 GB 소비자용 GPU에는 아예 올라가지 않는 100B–200B 모델도 실행합니다.
- 클라우드 이그레스 비용이나 시간당 과금 없이 중형 모델을 다루는 파인튜닝 및 LoRA 작업.
- 실제 CUDA 스택 기반 AI 개발: DGX나 클라우드 H100에 배포할 때와 같은 드라이버, 컨테이너, 라이브러리를 쓰므로 코드를 다시 작성하지 않고 그대로 상위 환경으로 옮길 수 있습니다.
- 부차적인 역할로서의 크리에이터 및 사무 작업: Arm Linux 데스크톱 앱은 잘 돌아가지만, 그것 때문에 사는 제품은 아닙니다.
더 저렴하고 Windows 친화적인 기기에서 7B–13B 모델을 돌리는 것이 목적이라면, GMKtec EVO-X2 같은 Strix Halo 기기나 Mac mini M4 Pro가 더 합리적인 선택입니다. ATOM은 128 GB 상한이 정말로 필요할 때만 제값을 합니다. 그 경계가 어디인지는 NPU vs iGPU vs CPU 비교 분석에서 다룹니다.
GB10 슈퍼칩과 통합 메모리
GB10은 20코어 Arm CPU(10× Cortex-X925 성능 코어 + 10× Cortex-A725 효율 코어)와 Blackwell GPU를 NVLink-C2C로 연결해, 둘 사이에 PCIe 병목이 없습니다. NVIDIA는 이 플랫폼의 성능을 1 PetaFLOP(1,000 TOPS) FP4 연산으로 제시하는데, FP4는 최신 추론 엔진이 많이 활용하는 희소(sparse) 저정밀도 연산 형식입니다.
FP4 수치는 사실이지만, 올바르게 읽어야 합니다. 이 수치는 최대 행렬 처리량을 나타낼 뿐, 토큰이 얼마나 빨리 나오는지를 말해 주지 않습니다. 추론에서 결정적인 제약은 거의 언제나 메모리 대역폭이며, 이는 아래에서 별도 섹션으로 다룹니다.
만듦새, 연결성, 클러스터링
섀시는 미니멀을 넘어 투박할 정도입니다. 약 1리터 크기의 검은 블록(약 150 × 150 × 51 mm, 약 1.2 kg)으로, 전면 포트가 전혀 없고(전원 버튼조차 뒷면에 있습니다) 앞에서 뒤로 깔끔하게 이어지는 공기 흐름 경로를 갖췄습니다. 리뷰어들은 ATOM이 시원하고 조용하게 동작한다고 한결같이 언급하며, ServeTheHome이 “가장 빠른 Spark”라는 평가를 내린 주된 이유도 이것입니다. 냉각이 좋을수록 GB10이 지속 부하에서 클럭을 더 오래 유지하기 때문입니다.
후면 연결성은 네트워킹 중심입니다.
- 듀얼 200GbE ConnectX-7 (QSFP): 대표 기능으로, ATOM 2대를 묶어 앞서 말한 405B 파라미터 듀얼 시스템 모드를 구성하는 데 사용합니다.
- 일반 LAN용 10GbE 구리선 포트, 그리고 Wi-Fi 7과 Bluetooth 5.3.
- 디스플레이 출력용 4× USB-C (USB 3.2 Gen2x2, 20 Gbps, DisplayPort alt-mode 지원)와 HDMI 2.1a.
알아둘 만한 주의점이 하나 있습니다. ServeTheHome은 ConnectX-7 NIC가 단일 x8이 아닌 PCIe x4 링크 2개로 GB10에 연결되어 있어, 듀얼 포트 200GbE가 하나의 굵은 400G 파이프라기보다 분할된 인터페이스처럼 동작한다고 지적했습니다. 단일 기기 구매자 대부분에게는 이론적인 문제지만, 촘촘한 2노드 클러스터링을 계획하는 사람이라면 이를 전제로 설계하기 전에 이해해 둘 필요가 있습니다.
메모리 대역폭: 실사용의 한계
가장 중요하면서도 마케팅이 감추는 수치입니다. 128 GB LPDDR5x는 약 273 GB/s의 대역폭을 제공합니다. 1리터 기기로서는 훌륭하지만, 개별 GPU가 제공하는 대역폭의 일부에 불과합니다. RTX 5090은 1.7 TB/s를 훌쩍 넘습니다.
토큰 생성은 대역폭에 좌우되므로, 대형 모델에서 ATOM의 처리량은 절대적으로 보면 평범한 수준입니다. 5090에는 물리적으로 올라가지 않는 120B 모델을 로드해 실행할 수는 있지만, FP4 PetaFLOP이라는 대표 수치에서 기대할 법한 속도보다는 느긋한 속도로 토큰을 내놓습니다. 올바른 이해 방식은 이렇습니다. GB10은 순수 속도를 용량과 맞바꾼 제품입니다. 이 크기와 가격대에서 다른 어디에도 들어가지 않는 모델을 실행하려고 사는 것이지, 32 GB에 들어가는 모델로 초당 토큰 수에서 게이밍 GPU를 이기려고 사는 것이 아닙니다. 속도보다 용량을 택하는 이 트레이드오프는 개별 GPU 미니 PC가 소형 모델에서는 더 빠르지만 대형 모델에서는 일찍 한계에 부딪히는 이유와 같습니다.
가격 및 구매처
GIGABYTE는 AI TOP ATOM을 세 가지 구성으로 판매하며, 모두 같은 GB10과 128 GB 메모리를 공유하고 SSD만 다릅니다.
- $3,499: 1 TB PCIe Gen4 NVMe
- $3,899: 4 TB PCIe Gen4 NVMe
- $3,999: 4 TB PCIe Gen5 NVMe
Amazon에도 등록되어 있으므로(4 TB 구성이 확인된 판매 페이지입니다), 아래 제휴 링크는 실제 판매 중인 미국 페이지로 연결됩니다. 이 가격이면 ATOM은 보통 NVIDIA 자체 DGX Spark(DRAM 가격 변동 속에 ~$3,999–$4,699 수준으로 올랐습니다)보다 저렴해, GB10 라인업에서 가성비가 좋은 제품 중 하나입니다. 제조사 간 차별화가 적으므로 지원이 중요합니다. GIGABYTE는 AVADirect와 제휴해 미국에서 익영업일 방문 수리를 제공합니다. 관련 제품: MSI EdgeXpert MS-C931과 Acer Veriton GN100도 같은 라인업의 GB10 기기입니다.
주의할 점
- 한계는 연산이 아니라 대역폭입니다. 273 GB/s라는 것은 대형 모델의 토큰 생성 처리량이 꾸준하지만 빠르지는 않다는 뜻입니다. 기대치를 그에 맞게 조정하세요.
- DGX OS는 데스크톱이 아니라 개발 환경입니다. NVIDIA 스택을 갖춘 Arm Linux로 AI 작업에는 훌륭하지만, Windows 기기도 아니고 범용 생산성 PC도 아닙니다.
- 모든 것이 납땜되어 있습니다. 128 GB 메모리는 고정이며, 구매 시 구성을 고를 수 있는 것은 SSD뿐입니다. 나중에 업그레이드할 방법은 없습니다.
- 분할된 ConnectX-7 레인. 듀얼 200GbE NIC는 2× x4로 동작하므로, 가장 깔끔한 2노드 클러스터링 구성에 제약이 생깁니다.
- 애초에 틈새 제품입니다. $3,499 이상의 가격이므로, 128 GB 통합 메모리 상한이 특별히 필요한 경우에만 의미가 있습니다. 7B–13B 모델이라면 훨씬 저렴한 하드웨어가 낫습니다.
결론
GIGABYTE AI TOP ATOM은 잘 만든 GB10 기기로, 현재 Spark급 제품 중 냉각과 가격 면에서 가장 뛰어나다고 볼 수 있으며, ServeTheHome의 “지금까지 가장 빠른 Spark”라는 평가가 바로 이를 반영합니다. 이 제품은 존재 이유인 단 하나의 일을 정직하게 해냅니다. 200B 파라미터 모델을 4,000달러 미만의 비용으로, 조용하게, 여러분의 책상 위에 올려 줍니다.
다만 올바른 이유로 구매하세요. 어떤 소비자용 GPU에도 들어가지 않을 만큼 큰 모델을 실행하고, 파인튜닝하고, 반복 개선해야 하는 AI 개발자나 연구자이고, 호환성 레이어가 아닌 NVIDIA의 실제 CUDA 스택을 원한다면 ATOM은 자신 있게 추천할 수 있는 제품이며, GB10 형제 제품 중 가성비 선택지입니다. 주로 소형 모델을 돌리거나 빠른 범용 데스크톱을 원했다면 이 제품은 맞지 않는 도구이며, Strix Halo 미니 PC나 Framework Desktop이 더 적은 비용으로 더 잘 맞을 것입니다.