
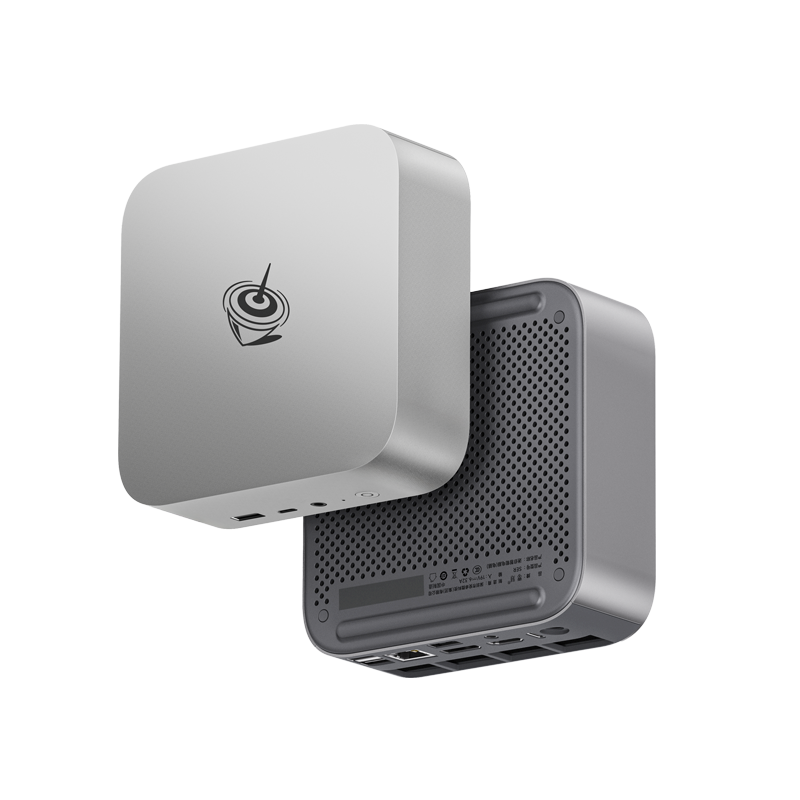
Hay una verdad discreta en la conversación sobre IA local que queda ahogada por cada titular de benchmark con un modelo de 70 mil millones de parámetros en una estación de trabajo de $4,000: la mayoría de la gente no necesita ese modelo. Necesita uno de 7 mil millones que corra en el equipo de escritorio que ya tiene, responda en un par de segundos y no exija una GPU dedicada, un presupuesto de energía de sala de servidores ni una segunda hipoteca. A abril de 2026, la clase de mini PC que ofrece justamente eso (equipos con AMD Ryzen 7 8845HS y Ryzen 9 8945HS con 32 a 64 GB de DDR5) es el hardware menos comentado del ecosistema de LLM locales.
Los equipos son nombres conocidos: el Beelink SER8 por unos $649, el Geekom A8 Max por cerca de $721 en su configuración de reseña (Liliputing), el Minisforum UM890 Pro y el GMKtec K8 Plus, que se ha visto en oferta desde $399. Comparten un perfil de chasis de alrededor de 0.5 a 0.7 litros, una CPU Zen 4 de 8 núcleos, una GPU integrada Radeon 780M, dos ranuras SO-DIMM de hasta DDR5-5600 y un motor neuronal XDNA 1 de 16 TOPS. Según las especificaciones de la propia AMD, el 8845HS y el 8945HS se diferencian sobre todo en la frecuencia de la CPU; la iGPU y la NPU son el mismo silicio.
El techo es el ancho de banda de memoria, no la cantidad de núcleos
La inferencia de LLM locales está, casi sin excepción, limitada por el ancho de banda de memoria con los tamaños de lote que usa una sola persona. Una configuración DDR5-5600 de doble canal llega como máximo a unos 89.6 GB/s de ancho de banda teórico, con cifras reales de 80 a 86 GB/s en benchmarks tipo STREAM. Eso es una fracción de la memoria unificada de un Apple serie M o de una plataforma AMD Strix Halo, y es la cifra que explica todas las demás de este artículo. También es, y esto es clave, suficiente.
Un modelo de 7 mil millones de parámetros en una cuantización de 5 bits (Q5_K_M, alrededor de 5.5 GB en disco) necesita pasar esos 5.5 GB por la memoria una vez por cada token generado. Con 80 GB/s de ancho de banda utilizable, el techo teórico es de unos 14 tokens por segundo, y el techo práctico queda un poco por debajo por la sobrecarga. Los reportes de campo en r/LocalLLaMA y en las discusiones de benchmarks de llama.cpp sitúan de forma constante Llama 3.1 8B Q5_K_M en 8 a 14 tokens por segundo en equipos con 8845HS que usan el backend Vulkan de llama.cpp con la Radeon 780M, y Mistral 7B Q5_K_M se mueve en el mismo margen. Eso es más rápido de lo que lee la mayoría de la gente, y ocurre en una caja casi sin ventilador que consume unos 8 vatios en reposo.
Lo que corre con soltura, lo que se esfuerza y lo que se atasca
Subir a la clase de 13 a 14 mil millones es donde el mini PC económico deja de ser una respuesta casual y se convierte en una decisión deliberada. Qwen 2.5 14B y Llama 3 13B en cuantizaciones Q4_K_M pesan unos 7 a 8 GB y generan de 4 a 8 tokens por segundo en el mismo hardware según las pruebas de la comunidad. Phi-3 medium 14B Q4 cae en la misma franja. Utilizable, en el sentido de que una respuesta de un párrafo llega en menos de un minuto; no ágil, en el sentido de que nadie lo confundirá con una API alojada.
Fuera de la generación de texto, el panorama es más amable. La transcripción con Whisper usando el modelo medium corre en tiempo real o más rápido. Los modelos de embeddings tipo sentence-transformer, el caballo de batalla de cualquier pipeline RAG local, procesan un párrafo en milisegundos. Lo que no corre con soltura es la clase de 30 mil millones de parámetros, todo lo que supere los 32 GB de RAM del sistema una vez que se cuentan el contexto y la caché KV, y la generación de imágenes: Stable Diffusion XL en la Radeon 780M sigue siendo lento, y las pruebas de Vulkan de Phoronix dejan claro que la fortaleza de la 780M es el rendimiento con modelos pequeños, no el paralelismo en grafos de difusión.
El software, contado con honestidad
La ruta solo con CPU es la aburrida y también la más confiable: llama.cpp sin indicadores de aceleración corre de inmediato en cualquier mini PC de esta clase y logra de 5 a 10 tok/s con un modelo 7B Q5. La historia interesante de 2025 y principios de 2026 es el backend Vulkan, que ha madurado hasta el punto de que la Radeon 780M es un acelerador creíble para inferencia cuantizada: el hilo de discusión sobre Vulkan de llama.cpp muestra a miembros de la comunidad que reportan de 12 a 18 tok/s con modelos 7B de Q4 a Q5, un salto importante frente a la CPU.
ROCm en la 780M sigue siendo la ruta más complicada. Funciona, es más rápido que la CPU cuando funciona, y es la opción con más probabilidades de romperse con una actualización del kernel.
La NPU XDNA, el motor neuronal de 16 TOPS que AMD ha promocionado como la pieza central de “Ryzen AI”, es la parte de esta historia que exige más franqueza. Como han documentado ServeTheHome y otros, el software de LLM de uso general para XDNA sigue inmaduro en abril de 2026. La mayoría de los usuarios de LLM locales no usa la NPU en absoluto. La comunidad se ha decidido, con pragmatismo, por Vulkan en la iGPU como la ruta de menor resistencia. Relacionado: nuestra guía de NPU vs iGPU vs CPU para LLM locales y la reseña del Beelink SER8.
La conclusión
Para la mayoría de la gente, un mini PC con Ryzen 8845HS de $700 y 32 GB de DDR5-5600 es IA local más que suficiente. Ejecuta un asistente de la clase Llama 3.1 8B a una velocidad que se puede leer con comodidad, transcribe reuniones en tiempo real, genera embeddings de una colección personal de documentos en segundos y hace todo eso en una esquina del escritorio con un consumo más cercano al de un foco que al de una estación de trabajo. La advertencia honesta es que la iGPU es más lenta que una GPU dedicada del mismo rango de precio, y que la NPU todavía no hace el trabajo que sus especificaciones sugieren. El replanteamiento honesto es que, para la clase de modelo que la mayoría de los usuarios realmente necesita, nada de eso importa. La pregunta que vale la pena hacerse antes de comprar una GPU de $2,000 para IA local no es “qué tan grande es el modelo que puedo ejecutar”, sino “qué tan grande es el modelo que realmente necesito”. Para muchísimos lectores, la respuesta cabe en siete mil millones de parámetros, y cabe en un mini PC que ya cuesta menos que la GPU sola.