
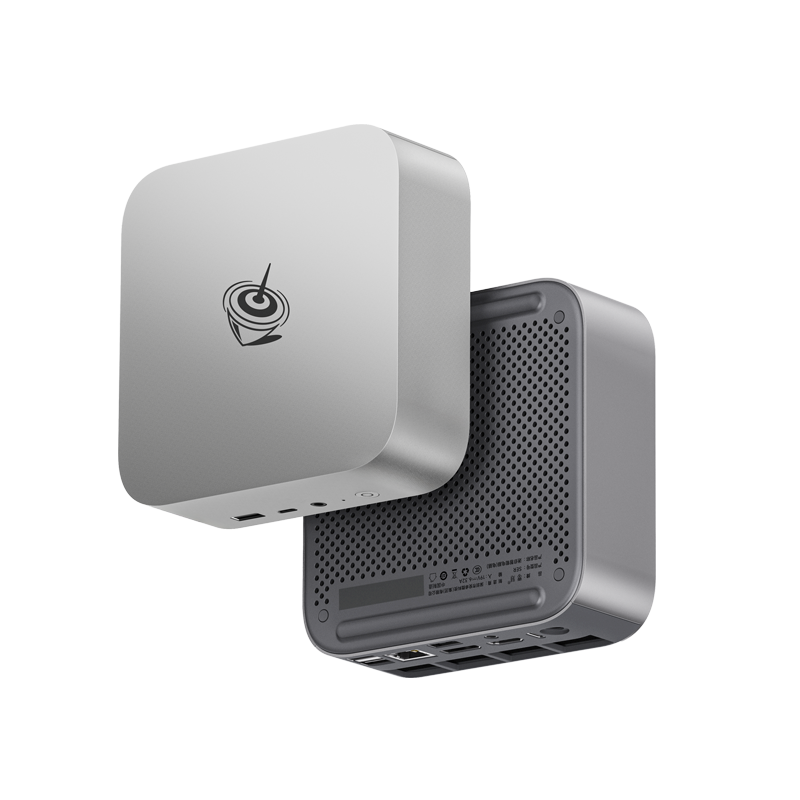
Il existe une vérité discrète dans le débat sur l’IA locale, noyée sous chaque gros titre de benchmark mettant en scène un modèle de 70 milliards de paramètres sur une station de travail à $4,000 : la plupart des gens n’ont pas besoin de ce modèle. Ils ont besoin d’un modèle de 7 milliards qui tourne sur l’ordinateur de bureau qu’ils possèdent déjà, répond en quelques secondes et n’exige ni GPU dédié, ni budget énergétique de salle serveur, ni second crédit immobilier. En avril 2026, la catégorie de mini PC qui offre exactement cela (les systèmes AMD Ryzen 7 8845HS et Ryzen 9 8945HS avec 32 à 64 Go de DDR5) est le matériel le moins commenté de l’écosystème des LLM locaux.
Les machines portent des noms familiers : le Beelink SER8 à environ $649, le Geekom A8 Max à environ $721 dans sa configuration de test (Liliputing), le Minisforum UM890 Pro et le GMKtec K8 Plus, aperçu jusqu’à $399 en promotion. Ils partagent un gabarit de boîtier d’environ 0,5 à 0,7 litre, un CPU Zen 4 à 8 cœurs, un GPU intégré Radeon 780M, deux emplacements SO-DIMM jusqu’à la DDR5-5600 et un moteur neuronal XDNA 1 annoncé à 16 TOPS. D’après les propres spécifications d’AMD, les 8845HS et 8945HS diffèrent surtout par la fréquence CPU ; l’iGPU et le NPU sont le même silicium.
La bande passante mémoire est le plafond, pas le nombre de cœurs
L’inférence de LLM en local est, presque sans exception, limitée par la bande passante mémoire aux tailles de lot qu’utilise une seule personne. Une configuration DDR5-5600 en double canal plafonne à environ 89,6 Go/s de bande passante théorique, avec des valeurs réelles de l’ordre de 80 à 86 Go/s dans les benchmarks de type STREAM. C’est une fraction de ce qu’offre la mémoire unifiée d’un Apple de la série M ou une plateforme AMD Strix Halo, et c’est le chiffre qui explique tous les autres chiffres de cet article. C’est aussi, point crucial, suffisant.
Un modèle de 7 milliards de paramètres en quantification 5 bits (Q5_K_M, environ 5,5 Go sur disque) doit faire transiter ces 5,5 Go par la mémoire une fois par token généré. Avec 80 Go/s de bande passante utilisable, le plafond théorique est d’environ 14 tokens par seconde, et le plafond pratique se situe un peu en dessous à cause du surcoût. Les retours de terrain sur r/LocalLLaMA et dans les discussions de benchmarks de llama.cpp situent de façon constante Llama 3.1 8B Q5_K_M entre 8 et 14 tokens par seconde sur les systèmes 8845HS utilisant le backend Vulkan de llama.cpp sur la Radeon 780M, Mistral 7B Q5_K_M restant dans la même enveloppe. C’est plus rapide que la vitesse de lecture de la plupart des gens, et cela se passe sur une machine presque passive qui consomme environ 8 watts au repos.
Ce qui tourne confortablement, ce qui peine, ce qui cale
C’est en passant à la classe des 13 à 14 milliards de paramètres que le mini PC abordable cesse d’être une réponse évidente pour devenir un choix réfléchi. Qwen 2.5 14B et Llama 3 13B en quantification Q4_K_M pèsent environ 7 à 8 Go et défilent à 4 à 8 tokens par seconde sur le même matériel dans les tests de la communauté. Phi-3 medium 14B Q4 tombe dans la même fourchette. Utilisable, au sens où une réponse d’un paragraphe arrive en moins d’une minute ; pas réactif, au sens où personne ne le confondra avec une API hébergée.
En dehors de la génération de texte, le tableau est plus favorable. La transcription Whisper avec le modèle medium tourne en temps réel ou mieux. Les modèles d’embedding sentence-transformer, la cheville ouvrière de tout pipeline RAG local, traitent un paragraphe en quelques millisecondes. Ce qui ne tourne pas confortablement, c’est la classe des 30 milliards de paramètres, tout ce qui déborde des 32 Go de RAM système une fois le contexte et le cache KV pris en compte, et la génération d’images : Stable Diffusion XL sur la Radeon 780M reste lent, et les tests Vulkan de Phoronix montrent clairement que le point fort de la 780M est le débit sur les petits modèles, pas le parallélisme sur les graphes de diffusion.
La pile logicielle, sans fard
La voie CPU seul est la plus ennuyeuse, et aussi la plus fiable : llama.cpp sans option d’accélération fonctionne d’emblée sur tous les mini PC de cette catégorie, avec 5 à 10 tok/s sur un modèle 7B Q5. L’histoire intéressante de 2025 et du début de 2026, c’est le backend Vulkan, qui a mûri au point de faire de la Radeon 780M un accélérateur crédible pour l’inférence quantifiée : le fil de discussion Vulkan de llama.cpp montre des membres de la communauté rapportant 12 à 18 tok/s sur des modèles 7B Q4 à Q5, un vrai progrès par rapport au CPU.
ROCm sur la 780M reste la voie la plus chaotique. Il fonctionne, il est plus rapide que le CPU quand il fonctionne, et c’est l’option la plus susceptible de casser lors d’une mise à jour du noyau.
Le NPU XDNA, le moteur neuronal de 16 TOPS qu’AMD a présenté comme la pièce maîtresse de « Ryzen AI », est la partie de cette histoire qui exige le plus de franchise. Comme ServeTheHome et d’autres l’ont documenté, la pile logicielle LLM généraliste pour XDNA reste immature en avril 2026. La plupart des utilisateurs de LLM locaux n’utilisent pas du tout le NPU. La communauté s’est rabattue, par pragmatisme, sur Vulkan sur l’iGPU, la voie de moindre résistance. À lire aussi : notre guide NPU vs iGPU vs CPU pour les LLM locaux et le test du Beelink SER8.
À retenir
Pour la plupart des gens, un mini PC Ryzen 8845HS à $700 avec 32 Go de DDR5-5600 offre largement assez d’IA locale. Il fera tourner un assistant de la classe Llama 3.1 8B à une vitesse lisible par un humain, transcrira des réunions en temps réel, indexera un corpus de documents personnels en quelques secondes, et fera tout cela dans un coin de bureau avec un budget énergétique plus proche d’une ampoule que d’une station de travail. La réserve honnête, c’est que l’iGPU est plus lent qu’un GPU dédié de même gamme de prix, et que le NPU ne fait pas encore le travail que ses spécifications laissent espérer. Le recadrage honnête, c’est que pour la classe de modèles dont la plupart des utilisateurs ont réellement besoin, rien de tout cela n’a d’importance. La question à se poser avant d’acheter un GPU à $2,000 pour l’IA locale n’est pas « quelle taille de modèle puis-je faire tourner ? », mais « de quelle taille de modèle ai-je réellement besoin ? ». Pour un très grand nombre de lecteurs, la réponse tient en sept milliards de paramètres, et elle tient dans un mini PC qui coûte déjà moins cher que le GPU seul.