
产品概览
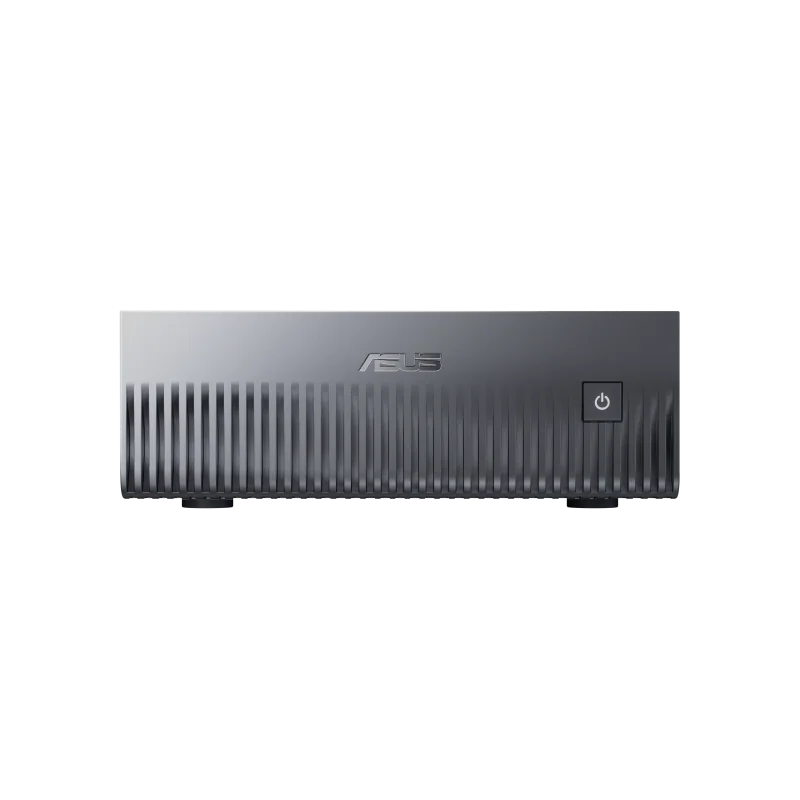
ASUS Ascent GX10 是一台个人 AI 超级计算机,核心是 NVIDIA 的 GB10 Grace Blackwell 超级芯片,与 NVIDIA 公版 DGX Spark 采用的是同一颗芯片。它在单一封装内集成了 20 核 Arm v9.2 Grace CPU 和 Blackwell GPU,两者通过 NVLink-C2C 连接,并共享一个 128 GB 的 LPDDR5x 统一内存池。在一本精装书大小的机身(150 × 150 × 51 mm)里,ASUS 塞进了约 1 PetaFLOP 的 FP4 算力,以及足以在本地加载 2000 亿参数模型的内存。
这不是一台通用迷你主机,也不应该按通用迷你主机的标准来挑选。它运行的是 NVIDIA DGX OS(Arm 版 Ubuntu Linux),而不是 Windows。它存在的意义就是本地 AI:微调、推理,以及为原本需要云端 GPU 实例的模型做原型开发。GX10 值得细看的原因在于价格。1 TB 版本售价 $2,999,是迄今 GB10 级别产品中定价最激进的入门选择,比公版 DGX Spark 更便宜,同时还加上了金属机身和更好的散热。
适合做什么:本地 AI 与 LLM 开发
GX10 最大的看点,是能把大模型装进一个统一的一致性内存空间。凭借 128 GB 统一 LPDDR5x,CPU 和 GPU 共享同一个内存池,因此你可以加载那些消费级显卡显存根本装不下的模型:
- 本地 LLM 推理: 无需借助云端,即可运行最高约 200B 参数的量化模型。在 StorageReview 的 vLLM 测试中,GPT-OSS-120B 视负载形态不同,输出速度约为 45–680 tokens/sec;Llama 3.1 8B FP4 在以预填充为主的测试中最高达到约 2,750 tokens/sec。
- 微调与 LoRA: 128 GB 内存池为微调中等规模模型留出了余量,而这些模型在 24 GB 甚至 32 GB 的独立显卡上都放不下。
- AI 开发环境: DGX OS 预装了 CUDA、PyTorch、TensorFlow、Jupyter、TensorRT、NVIDIA NIM 微服务和 Ollama。对于想要一台放在桌下、而不是挂在云账单上的 CUDA 主机的开发者来说,这套开箱即用的软件栈才是真正的卖点。
- 双机集群: 板载的 ConnectX-7 网卡可以通过一条 200 Gbps QSFP 线缆把两台 GX10 连在一起,在两台机器上运行最高 405B 参数的模型(Llama 3.1 405B)。
如果你的需求是一般创作或办公,GX10 也能胜任,但那等于花超算的钱去用一台 Arm Linux 桌面机。对这类用户而言,选择 Framework Desktop 这样的 x86 主机,或者一台能跑 70B 模型的 Strix Halo 机器要合理得多。
GB10 超级芯片与统一内存
GB10 是整个故事的核心。20 核 Grace CPU 负责调度和数据预处理;配备第五代 Tensor Core 并原生支持 FP4 的 Blackwell GPU 承担主要计算,算力最高可达 1,000 TOPS。由于两者通过 NVLink-C2C 连接(NVIDIA 称其带宽约为 PCIe 5.0 的五倍),在 CPU 和 GPU 内存之间搬运张量时不存在 PCIe 瓶颈。一切都在同一个一致性地址空间内完成。
正是这种架构,让这么小的机器敢宣称可以运行 200B 参数的模型,而配备 32 GB GDDR7 的桌面 RTX 5090 根本装不下这些模型。代价则是带宽,下文会详细说明。
做工、接口与集群
ASUS 显然仔细研究过公版设计,并加以改进。GX10 采用铝合金机身,而非 DGX Spark 的塑料外壳,在底部和背部增加了散热开孔,还把电源键移到了正面。这看似是小细节,等你管理一摞集群设备时就知道它的价值了。散热由三风扇和双均热板负责,支持七档调节,整机还通过了多项 MIL-STD 810H 测试,甚至凭借这一设计拿下了 2026 年台湾精品奖(Taiwan Excellence Award)。
接口配置面向的是 AI 工作站,而不是影音主机:
- NVIDIA ConnectX-7 网卡:双 200 Gbps QSFP 端口用于横向扩展集群,另有 10 GbE 网口
- 4× USB-C(20 Gbps,支持 DisplayPort 2.1 alt mode);其中一个兼作 180W EPR 供电输入
- HDMI 2.1b、Wi-Fi 7、Bluetooth 5.4、Kensington 锁孔
- 240W USB-C 电源适配器
内存带宽:真实世界的天花板
接下来说说实话。GX10 的内存带宽实测约为 273 GB/s(LPDDR5x,8533 MT/s)。与 CPU 相比这已经很高,但只是独立显卡的零头:RTX 5090 的带宽远超 1.7 TB/s。对于受内存带宽制约的 LLM token 生成来说,限制性能的正是这道天花板,而不是 Blackwell GPU 的算力。
这在实际使用中意味着:GX10 非常擅长装下超大模型,也擅长以预填充和吞吐量为主的推理服务;但在大模型上做交互式单流 token 生成时,与运行着能装进显存的小模型的高端独立显卡相比,它的速度只能算中规中矩。当模型大到在别处都放不下时,GX10 才占上风;在能装进 32 GB 的模型上比拼每秒 token 数,它赢不了 5090。StorageReview 发现,GX10 与其他所有 Spark 级系统的表现非常接近,因为它们的核心芯片完全相同;各厂商之间的差别在于机身、散热、SSD 和价格,而不是原始速度。
ASUS Ascent GX10 对比 NVIDIA DGX Spark
两者采用相同的 GB10 超级芯片、相同的 128 GB 统一内存和相同的 273 GB/s 带宽,因此 AI 性能实际上完全一致。GX10 的优势全在芯片之外:金属机身、更精细的三风扇加均热板散热、前置电源键,以及最重要的,更低的起售价。如果你在几款 Spark 级主机之间做选择,比的就是做工、存储档位和价格。相关阅读:我们对 MSI EdgeXpert MS-C931 和 GIGABYTE AI TOP ATOM 的评测。
价格与购买渠道
Ascent GX10 按存储容量分为三个档位:
- $2,999:1 TB PCIe Gen4 NVMe(性价比之选,入门款约 $333/TB)
- $3,499:2 TB PCIe Gen4 NVMe
- $3,999:4 TB PCIe Gen5 NVMe
三个版本都搭载相同的 GB10 超级芯片和 128 GB 内存;你多付的钱只买到了 SSD 容量,以及顶配版更快的 Gen5 硬盘。对大多数买家来说,$2,999 的 1 TB 版本是明智的入门之选:这是进入 GB10 生态最便宜的方式,而且模型从存储加载的速度足够快,Gen4 硬盘很少会成为推理瓶颈。只有当你需要在本地同时管理大量大型模型检查点时,4 TB Gen5 版本才值得考虑。
需要注意的问题
在它所针对的细分领域里,这是一款很强的产品,但也有几点需要如实说明:
- 它是 Linux 开发者设备,不是桌面电脑。 DGX OS 是 Arm 版 Ubuntu。如果你期待的是一台 Windows 机器,这台不是。
- 273 GB/s 就是瓶颈。 大模型的 token 生成受带宽限制,别指望有独立显卡那样的交互体验。买它是为了容量,而不是原始速度。
- 1 TB 版本配备的是 Gen4 SSD,写入速度相对较慢。用于推理没问题,但如果你需要频繁写入大型检查点,就不太理想了。
- 突发负载下温度偏高。 StorageReview 观察到,在以预填充为主的峰值负载中,CPU 最高达到 87.3°C,GPU 达到 82°C,不过在持续负载下会趋于稳定。三风扇散热压得住,但高压下这确实是个发热不小的小盒子。
- 这是一笔单一用途的投资。 售价 $3,000 以上,只有当本地 AI 确实是你的工作负载时才值得购买。如果你只是对本地 LLM 有些好奇,那么一台 Strix Halo 迷你主机、一台 Mac mini M4 Pro,甚至是我们介绍过的 NPU/核显方案,都是便宜得多的起点。
ASUS Ascent GX10 结论
ASUS Ascent GX10 是目前入手 NVIDIA GB10 Grace Blackwell 平台最明智的方式。它与 DGX Spark 采用相同的芯片,在一个书本大小的铝合金机身里装下了 128 GB 统一内存和完整的 CUDA 开发栈,还能与第二台组成集群处理 405B 参数的任务,而起售价仅为 $2,999,是同级别中最低的入门价。
只是要出于正确的理由购买它。它的价值在于能在本地装下超大模型并基于其进行开发,同时内置开箱即用的 NVIDIA 软件栈和集群能力。它不是交互式生成的速度怪兽(273 GB/s 的内存带宽决定了这一点),也不是一台通用电脑。但如果你是 AI 开发者、研究人员或创作者,想要一台无需租用云端 GPU 的个人 Grace Blackwell 工作站,那么 GX10 就是应当排在清单首位的 GB10 主机。