
어떤 제품인가
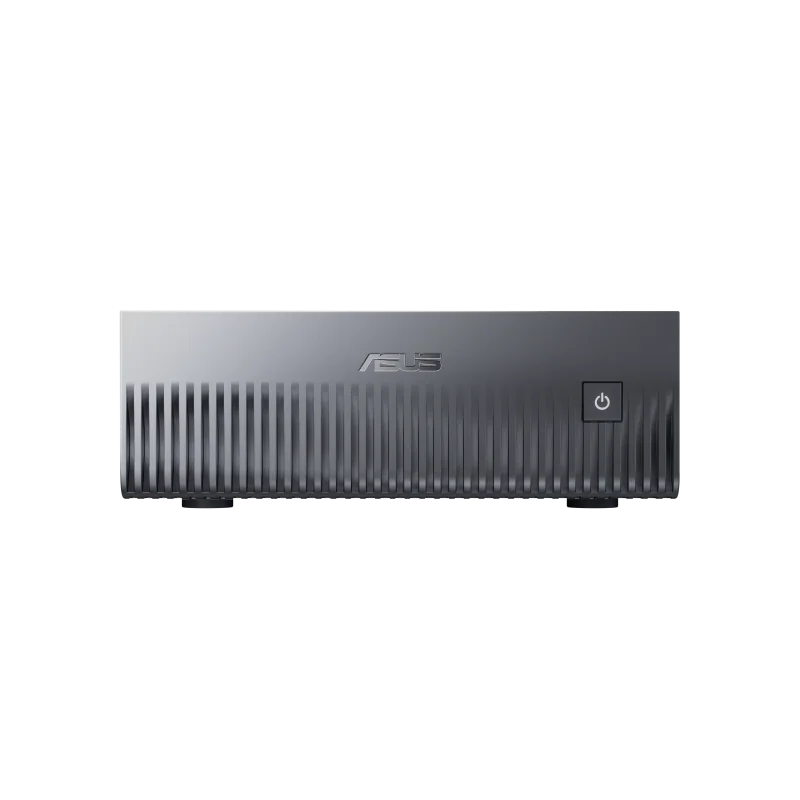
ASUS Ascent GX10은 NVIDIA의 GB10 Grace Blackwell 슈퍼칩을 중심으로 만든 개인용 AI 슈퍼컴퓨터입니다. NVIDIA 레퍼런스 제품인 DGX Spark와 같은 실리콘을 사용합니다. 20코어 Arm v9.2 Grace CPU와 Blackwell GPU를 하나의 패키지에 담아 NVLink-C2C로 연결하고, 두 프로세서가 128 GB LPDDR5x 통합 메모리 풀을 함께 사용합니다. ASUS는 양장본 책 크기(150 × 150 × 51 mm)의 섀시에 약 1 PetaFLOP의 FP4 연산 성능과 2,000억 파라미터 모델을 로컬에 올릴 수 있는 메모리를 담아냈습니다.
이 제품은 범용 미니 PC가 아니며, 그런 기준으로 비교해서도 안 됩니다. Windows가 아니라 NVIDIA DGX OS(Arm용 Ubuntu Linux)로 구동됩니다. 존재 이유는 로컬 AI입니다. 클라우드 GPU 인스턴스가 필요했을 모델의 파인튜닝, 추론, 프로토타이핑을 위한 기기입니다. GX10을 눈여겨볼 이유는 가격입니다. 1 TB 구성 $2,999로, 지금까지 나온 GB10 계열 중 가장 공격적인 시작 가격이며, 레퍼런스 DGX Spark보다 저렴하면서도 금속 섀시와 더 나은 냉각을 갖췄습니다.
어떤 용도에 적합한가: 로컬 AI 및 LLM 개발
GX10의 핵심 강점은 대형 모델을 하나의 코히어런트 메모리 공간에 올릴 수 있다는 점입니다. 128 GB LPDDR5x 통합 메모리를 CPU와 GPU가 하나의 풀로 공유하므로, 소비자용 GPU의 VRAM에는 절대 들어가지 않을 모델도 불러올 수 있습니다.
- 로컬 LLM 추론: 클라우드 없이 최대 약 200B 파라미터의 양자화 모델을 실행할 수 있습니다. StorageReview의 vLLM 테스트에서 GPT-OSS-120B는 워크로드 형태에 따라 약 45~680 토큰/초를 기록했고, Llama 3.1 8B FP4는 프리필 비중이 큰 실행에서 최대 약 2,750 토큰/초에 도달했습니다.
- 파인튜닝 및 LoRA 작업: 128 GB 메모리 풀 덕분에 24 GB는 물론 32 GB 외장 그래픽카드에도 들어가지 않는 중형 모델을 여유 있게 파인튜닝할 수 있습니다.
- AI 개발 환경: DGX OS에는 CUDA, PyTorch, TensorFlow, Jupyter, TensorRT, NVIDIA NIM 마이크로서비스, Ollama가 사전 설치되어 있습니다. 클라우드 요금 대신 책상 밑에 두는 CUDA 머신을 원하는 개발자에게는 이 즉시 사용 가능한 소프트웨어 스택이 진정한 강점입니다.
- 2노드 클러스터링: 내장 ConnectX-7 NIC를 통해 GX10 두 대를 단일 200 Gbps QSFP 링크로 연결하고, 최대 405B 파라미터 모델(Llama 3.1 405B)을 두 대에 나눠 실행할 수 있습니다.
일반적인 크리에이터 작업이나 사무 용도에도 GX10을 쓸 수는 있지만, 슈퍼컴퓨터 가격을 내고 Arm Linux 데스크톱을 쓰는 셈이 됩니다. 이런 사용자에게는 Framework Desktop 같은 x86 기기나 70B 모델을 구동하는 Strix Halo 머신이 훨씬 합리적입니다.
GB10 슈퍼칩과 통합 메모리
이야기의 핵심은 GB10입니다. 20코어 Grace CPU가 작업 조율과 데이터 준비를 맡고, 5세대 Tensor Core와 네이티브 FP4를 갖춘 Blackwell GPU가 최대 1,000 TOPS로 무거운 연산을 처리합니다. 두 프로세서는 NVLink-C2C로 연결되어 있어(NVIDIA는 PCIe 5.0 대비 약 5배의 대역폭이라고 밝힙니다), CPU와 GPU 메모리 사이에서 텐서를 옮길 때 PCIe 병목이 없습니다. 전체가 하나의 코히어런트 주소 공간입니다.
32 GB GDDR7을 탑재한 데스크톱 RTX 5090으로는 아예 올릴 수 없는 200B 파라미터 모델을 이렇게 작은 기기가 실행할 수 있다고 내세울 수 있는 것도 이 아키텍처 덕분입니다. 대신 대역폭이라는 트레이드오프가 있으며, 이는 아래에서 다룹니다.
빌드 품질, 연결성, 클러스터링
ASUS는 레퍼런스 디자인을 면밀히 연구하고 개선한 것이 분명합니다. GX10은 DGX Spark의 플라스틱 대신 알루미늄 섀시를 사용하고, 하단과 후면에 통풍구를 추가했으며, 전원 버튼을 전면으로 옮겼습니다. 사소해 보이지만 클러스터로 묶은 여러 대를 쌓아 관리할 때는 차이가 큽니다. 냉각은 7단계 제어가 가능한 팬 3개와 듀얼 베이퍼 챔버가 담당하며, 여러 MIL-STD 810H 테스트를 통과했습니다. 디자인으로 2026 Taiwan Excellence Award도 받았습니다.
연결성은 미디어 PC가 아닌 AI 워크스테이션에 맞춰져 있습니다.
- NVIDIA ConnectX-7 NIC: 스케일아웃 클러스터링을 위한 듀얼 200 Gbps QSFP 포트, 10 GbE LAN
- USB-C 4개 (20 Gbps, DisplayPort 2.1 Alt 모드): 그중 1개는 180W EPR 전원 입력 겸용
- HDMI 2.1b, Wi-Fi 7, Bluetooth 5.4, 켄싱턴 락 슬롯
- 240W USB-C 전원 어댑터
메모리 대역폭: 실사용의 한계
솔직하게 말씀드릴 부분입니다. GX10의 메모리 대역폭은 약 273 GB/s(LPDDR5x 8533 MT/s)입니다. CPU와 비교하면 엄청난 수치지만, 외장 GPU와 비교하면 일부에 불과합니다. RTX 5090은 1.7 TB/s를 훌쩍 넘습니다. 메모리 대역폭에 좌우되는 LLM 토큰 생성에서는 Blackwell GPU의 연산 성능이 아니라 바로 이 한계가 병목이 됩니다.
실제로 이것이 의미하는 바는 다음과 같습니다. GX10은 거대한 모델을 메모리에 올리는 일과 프리필/처리량 중심 서빙에서는 탁월하지만, 대형 모델의 대화형 단일 스트림 토큰 생성은 VRAM에 들어갈 만큼 작은 모델을 돌리는 고급 외장 GPU에 비해 평범하게 느껴질 것입니다. GX10은 다른 곳에 들어가지 않을 만큼 큰 모델에서 승리하며, 32 GB에 들어가는 모델로 5090과 초당 토큰 수 경쟁을 하면 이기지 못합니다. StorageReview에 따르면 GX10은 다른 모든 Spark급 시스템과 거의 같은 결과를 보였습니다. 모두 동일한 핵심 실리콘을 공유하기 때문이며, 제조사 간 차이는 순수 속도가 아니라 섀시, 냉각, SSD, 가격에서 나옵니다.
ASUS Ascent GX10 vs NVIDIA DGX Spark
두 제품은 같은 GB10 슈퍼칩, 같은 128 GB 통합 메모리, 같은 273 GB/s 대역폭을 사용하므로 AI 성능은 사실상 동일합니다. GX10의 강점은 칩 주변의 모든 것입니다. 금속 섀시, 더 정교한 팬 3개/베이퍼 챔버 쿨러, 전면 전원 버튼, 그리고 무엇보다 더 낮은 시작 가격입니다. Spark급 기기 중에서 고른다면 결국 빌드 품질, 스토리지 구성, 비용을 보고 선택하게 됩니다. 관련 리뷰: MSI EdgeXpert MS-C931, GIGABYTE AI TOP ATOM.
가격 및 구매처
Ascent GX10은 스토리지에 따라 세 가지 구성으로 판매됩니다.
- $2,999: 1 TB PCIe Gen4 NVMe (가성비 선택, 시작 모델 기준 TB당 약 $333)
- $3,499: 2 TB PCIe Gen4 NVMe
- $3,999: 4 TB PCIe Gen5 NVMe
세 구성 모두 같은 GB10 슈퍼칩과 128 GB 메모리를 탑재합니다. 추가 비용은 SSD 용량, 그리고 최상위 구성의 경우 더 빠른 Gen5 드라이브에 대한 것뿐입니다. 대부분의 구매자에게는 $2,999의 1 TB 모델이 현명한 시작점입니다. GB10 생태계에 들어가는 가장 저렴한 방법이며, 모델을 스토리지에서 불러오는 속도도 충분히 빨라 Gen4 드라이브가 추론의 병목이 되는 경우는 드뭅니다. 4 TB Gen5 구성은 대형 모델 체크포인트를 로컬에서 많이 다루는 경우에만 의미가 있습니다.
주의할 점
해당 분야에서는 강력한 제품이지만, 솔직하게 짚어야 할 몇 가지 단서가 있습니다.
- 데스크톱이 아니라 Linux 개발자용 어플라이언스입니다. DGX OS는 Arm Ubuntu입니다. Windows 머신을 기대한다면 이 제품은 맞지 않습니다.
- 273 GB/s가 병목입니다. 대형 모델의 토큰 생성은 대역폭에 묶여 있으므로, 외장 GPU 수준의 반응성을 기대하지 마세요. 순수 속도가 아니라 용량을 보고 구매해야 합니다.
- 1 TB 모델에는 Gen4 SSD가 탑재되며 쓰기 속도가 비교적 느립니다. 추론에는 문제없지만, 대형 체크포인트를 계속 저장하는 작업에는 그리 이상적이지 않습니다.
- 순간적으로 발열이 높아집니다. StorageReview는 프리필 비중이 큰 부하 급증 구간에서 CPU 최고 87.3°C, GPU 82°C를 확인했으며, 지속 부하에서는 안정화되었습니다. 팬 3개 쿨러가 감당은 하지만, 부하가 걸리면 뜨거워지는 작은 기기입니다.
- 단일 목적 투자입니다. $3,000 이상의 가격이므로, 로컬 AI가 실제 주 업무인 경우에만 의미가 있습니다. 로컬 LLM에 가볍게 관심이 있는 정도라면 Strix Halo 미니 PC, Mac mini M4 Pro, 또는 저희가 분석한 NPU/iGPU 옵션이 훨씬 저렴한 출발점입니다.
ASUS Ascent GX10 결론
ASUS Ascent GX10은 현재 NVIDIA GB10 Grace Blackwell 플랫폼에 진입하는 가장 합리적인 방법입니다. DGX Spark와 같은 실리콘을 사용하고, 128 GB 통합 메모리와 완전한 CUDA 개발 스택을 책 크기의 알루미늄 본체에 담았으며, 두 번째 기기와 클러스터를 구성해 405B 파라미터 작업도 할 수 있습니다. 이 모든 것이 동급 최저 시작 가격인 $2,999부터입니다.
다만 올바른 이유로 구매하셔야 합니다. 이 제품의 가치는 즉시 사용 가능한 NVIDIA 소프트웨어 스택과 내장 클러스터링을 바탕으로 매우 큰 모델을 로컬에 올리고 개발할 수 있다는 데 있습니다. 대화형 생성에서 속도가 빠른 기기는 아니며(273 GB/s 메모리 대역폭 때문입니다), 범용 PC도 아닙니다. 하지만 클라우드 GPU를 빌리지 않고 개인용 Grace Blackwell 워크스테이션을 원하는 AI 개발자, 연구자, 크리에이터라면 GX10은 목록 맨 위에 올려야 할 GB10 기기입니다.