
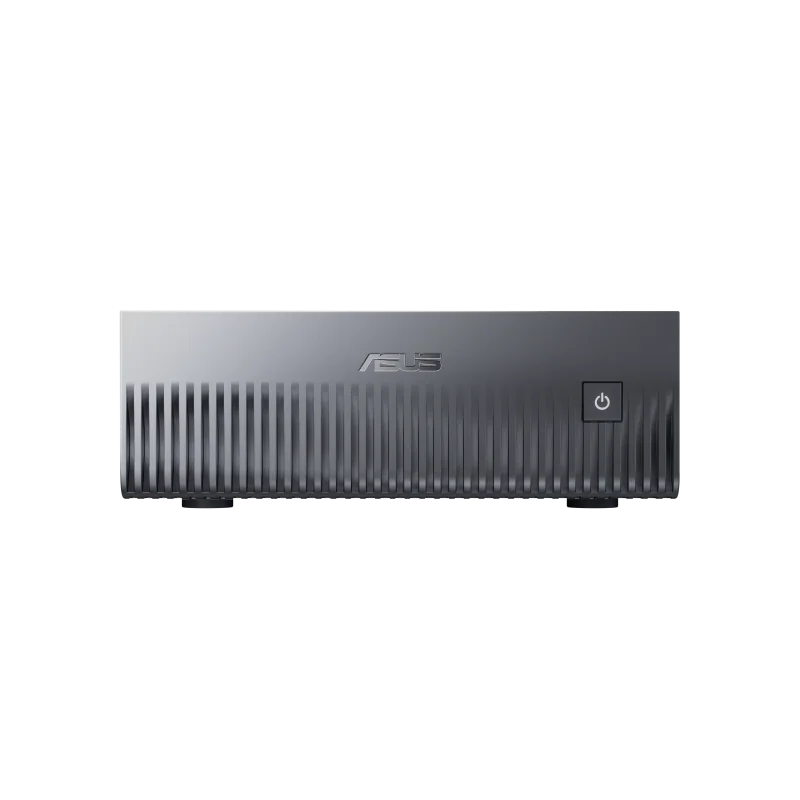
製品概要
ASUS Ascent GX10は、NVIDIAのGB10 Grace Blackwellスーパーチップを中核にしたパーソナルAIスーパーコンピューターです。NVIDIAのリファレンス機DGX Sparkと同じシリコンを搭載しています。20コアのArm v9.2 Grace CPUとBlackwell GPUを1つのパッケージに収めてNVLink-C2Cで接続し、両者に128 GBのLPDDR5xユニファイドメモリを共有プールとして供給します。ハードカバーの本ほどの大きさ(150 × 150 × 51 mm)の筐体に、ASUSはFP4で約1 PetaFLOPの演算性能と、2,000億パラメータのモデルをローカルに読み込めるだけのメモリを詰め込みました。
これは汎用のミニPCではなく、そのつもりで選ぶべきものでもありません。OSはWindowsではなくNVIDIA DGX OS(Arm版Ubuntu Linux)です。存在意義はローカルAIにあります。本来ならクラウドのGPUインスタンスが必要になるモデルのファインチューニング、推論、プロトタイピングです。GX10が注目に値するのは価格です。1 TB構成で$2,999という価格は、これまでのGB10クラスでもっとも攻めたエントリー価格で、リファレンスのDGX Sparkより安いうえに、金属筐体とより優れた冷却を備えています。
得意分野:ローカルAIとLLM開発
GX10の最大の売りは、大規模モデルを単一のコヒーレントなメモリ空間に収められることです。128 GBのLPDDR5xユニファイドメモリをCPUとGPUが共有するため、コンシューマー向けGPUのVRAMには到底収まらないモデルも読み込めます。
- ローカルLLM推論: 最大約200Bパラメータの量子化モデルを、クラウドに頼らず動かせます。StorageReviewのvLLMテストでは、GPT-OSS-120Bがワークロードの形態に応じて約45から680トークン/秒で応答し、Llama 3.1 8B FP4はプリフィル中心の実行で最大約2,750トークン/秒に達しました。
- ファインチューニングとLoRA: 128 GBのプールがあれば、24 GBどころか32 GBのディスクリートカードにも収まらない中規模モデルのファインチューニングにも余裕があります。
- AI開発環境: DGX OSにはCUDA、PyTorch、TensorFlow、Jupyter、TensorRT、NVIDIA NIMマイクロサービス、Ollamaがプリロードされています。クラウドの請求書ではなく机の下に置けるCUDAマシンが欲しい開発者にとって、この箱から出してすぐ使えるスタックこそが本当のセールスポイントです。
- 2ノードクラスタリング: 搭載のConnectX-7 NICにより、2台のGX10を1本の200 Gbps QSFPリンクで接続し、最大405Bパラメータのモデル(Llama 3.1 405B)を2台にまたがって動かせます。
一般的なクリエイター作業やオフィス作業が目的なら、GX10でもこなせますが、Arm Linuxデスクトップを動かすためにスーパーコンピューター並みのお金を払うことになります。そうした用途なら、Framework Desktopのようなx86マシンや、70Bモデルを動かせるStrix Haloマシンのほうがはるかに理にかなっています。
GB10スーパーチップとユニファイドメモリ
話の核心はGB10です。20コアのGrace CPUがオーケストレーションとデータの前処理を担い、第5世代TensorコアとネイティブFP4に対応したBlackwell GPUが最大1,000 TOPSで重い処理をこなします。両者はNVLink-C2Cで結ばれているため(NVIDIAによれば両者間の帯域幅はPCIe 5.0の約5倍)、CPUとGPUのメモリ間でテンソルをやり取りする際のPCIeボトルネックがありません。すべてが1つのコヒーレントなアドレス空間です。
32 GBのGDDR7を搭載したデスクトップのRTX 5090でさえ到底保持できない200Bパラメータのモデルを、これほど小さなマシンが動かせると言えるのは、このアーキテクチャのおかげです。トレードオフは帯域幅で、これについては後述します。
筐体、接続性、クラスタリング
ASUSは明らかにリファレンス設計を研究し、改良しています。GX10はDGX Sparkのプラスチックではなくアルミ筐体を採用し、底面と背面に通気口を追加し、電源ボタンを前面に移しました。クラスタ化した複数台を積み重ねて管理するようになると、この小さな違いが効いてきます。冷却は7段階制御の3基のファンとデュアルベイパーチャンバーが担い、本体は複数のMIL-STD 810Hテストに合格しています。デザインで2026年のTaiwan Excellence Awardも受賞しました。
接続性はメディアPCではなく、AIワークステーション向けに構成されています。
- NVIDIA ConnectX-7 NIC:スケールアウトのクラスタリング用のデュアル200 Gbps QSFPポートに加え、10 GbE LAN
- 4× USB-C(20 Gbps、DisplayPort 2.1 Altモード)。うち1基は180W EPRの給電入力を兼ねます
- HDMI 2.1b、Wi-Fi 7、Bluetooth 5.4、Kensingtonロックスロット
- 240W USB-C電源
メモリ帯域幅:実用上の上限
ここからが正直な話です。GX10のメモリ帯域幅は約273 GB/s(8533 MT/sのLPDDR5x)です。CPUと比べれば膨大ですが、ディスクリートGPUの数分の1にすぎません。RTX 5090は1.7 TB/sを大きく超えます。メモリ帯域幅に左右されるLLMのトークン生成では、Blackwell GPUの演算性能ではなく、この上限が制約になります。
実際には、GX10は巨大なモデルを保持することや、プリフィル/スループット中心の推論サーバー用途では非常に優れていますが、大規模モデルでの対話型の単一ストリームのトークン生成は、VRAMに収まる小さなモデルを動かすハイエンドのディスクリートGPUと比べると控えめに感じられます。GX10が勝つのは、モデルが大きすぎてほかに収まる場所がない場合です。32 GBに収まるモデルで5090とトークン/秒を競っても勝てません。StorageReviewによれば、GX10はほかのすべてのSparkクラスのシステムと非常に近い結果でした。どれもコアのシリコンが同一だからです。メーカー間の違いは、生の速度ではなく、筐体、冷却、SSD、価格に帰着します。
ASUS Ascent GX10とNVIDIA DGX Sparkの比較
同じGB10スーパーチップ、同じ128 GBのユニファイドメモリ、同じ273 GB/sの帯域幅を使っているため、AI性能は事実上同じです。GX10の強みは、チップの周辺のすべてにあります。金属筐体、より凝った3ファンとベイパーチャンバーのクーラー、前面の電源ボタン、そして何より低いエントリー価格です。Sparkクラスのマシンの中から選ぶなら、作りの品質、ストレージ容量、価格で選ぶことになります。関連記事:MSI EdgeXpert MS-C931とGIGABYTE AI TOP ATOMのレビュー。
価格と購入先
Ascent GX10はストレージ容量によって3つのモデルで販売されています。
- $2,999:1 TB PCIe Gen4 NVMe(コスパ重視の選択、エントリーで約$333/TB)
- $3,499:2 TB PCIe Gen4 NVMe
- $3,999:4 TB PCIe Gen5 NVMe
3モデルとも同じGB10スーパーチップと128 GBのメモリを搭載しており、差額はSSDの容量と、最上位モデルではより高速なGen5ドライブの分だけです。多くの購入者にとっては**$2,999の1 TBモデル**が賢い入り口です。GB10エコシステムにもっとも安く入る方法であり、モデルはストレージから十分な速さで読み込まれるため、Gen4ドライブが推論のボトルネックになることはまずありません。4 TBのGen5モデルが意味を持つのは、多数の大規模モデルのチェックポイントをローカルで扱う場合だけです。
注意点
このニッチ向けとしては優れた製品ですが、正直に指摘しておくべき点がいくつかあります。
- デスクトップではなく、Linuxの開発者向けアプライアンスです。 DGX OSはArm版Ubuntuです。Windowsマシンを期待しているなら、これは違います。
- 273 GB/sがボトルネックです。 大規模モデルのトークン生成は帯域幅に制限されるため、ディスクリートGPUのような応答性は期待できません。生の速度ではなく、容量のために買いましょう。
- 1 TBモデルはGen4 SSDを搭載しており、書き込み速度は比較的遅めです。推論には問題ありませんが、大きなチェックポイントを頻繁に書き込むなら理想的ではありません。
- 瞬間的に温度が上がります。 StorageReviewは、プリフィル中心の負荷のピーク時にCPUが87.3°C、GPUが82°Cに達するのを確認しましたが、持続負荷では安定しました。3ファンのクーラーで対処できていますが、高負荷時には熱くなる小さなマシンです。
- 単一目的の投資です。 $3,000以上という価格は、ローカルAIが本当に自分の仕事である場合にしか見合いません。ローカルLLMにもう少し気軽に興味がある程度なら、Strix HaloミニPC、Mac mini M4 Pro、あるいは当サイトで紹介したNPU/iGPUの選択肢のほうが、はるかに安く始められます。
ASUS Ascent GX10の結論
ASUS Ascent GX10は、現時点でNVIDIAのGB10 Grace Blackwellプラットフォームを手に入れるもっとも賢明な方法です。DGX Sparkと同じシリコンを搭載し、128 GBのユニファイドメモリと完全なCUDA開発スタックを本ほどの大きさのアルミ筐体に収め、2台目と連結すれば405Bパラメータの作業もこなせます。しかも価格はクラス最安の**$2,999**からです。
ただし、正しい理由で買ってください。このマシンの価値は、すぐに使えるNVIDIAのソフトウェアスタックとクラスタリング機能を備え、非常に大きなモデルをローカルで保持し、それを対象に開発できることにあります。対話型の生成で速さを誇るマシンではなく(273 GB/sのメモリ帯域幅がそれを許しません)、汎用PCでもありません。しかし、クラウドGPUを借りずに自分専用のGrace Blackwellワークステーションを持ちたいAI開発者、研究者、クリエイターにとって、GX10はリストの最上位に置くべきGB10マシンです。