
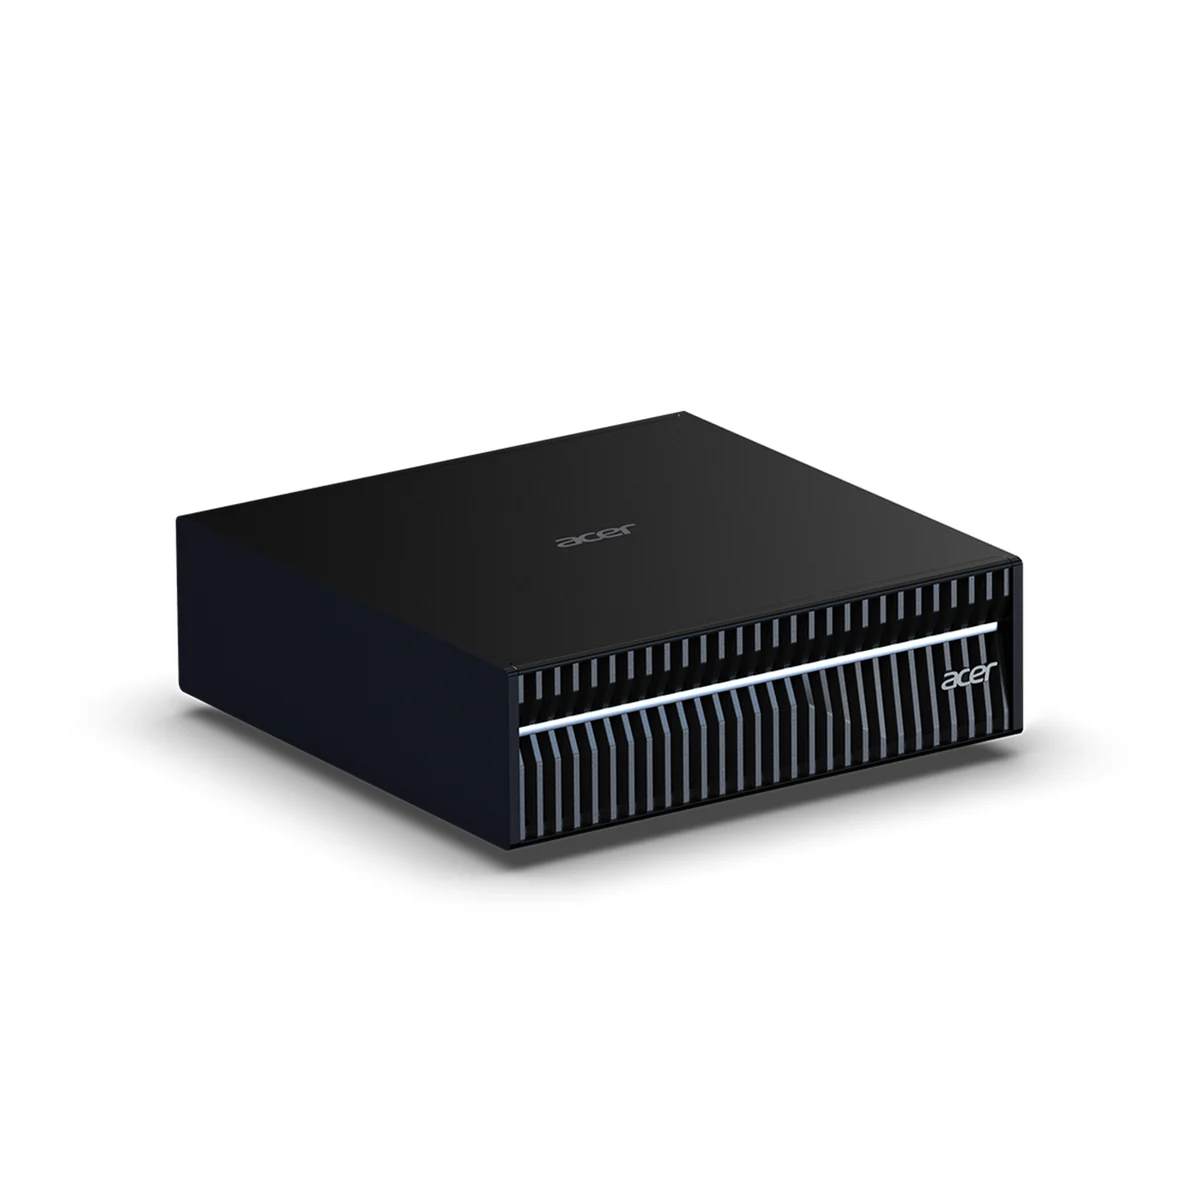
Acer Veriton GN100 是什么
Acer Veriton GN100 是一款售价 $3,999 的 AI 迷你工作站,基于 NVIDIA 的 GB10 Grace Blackwell 超级芯片,与 NVIDIA、Dell、ASUS 以及 GIGABYTE 推出的产品同属 “DGX Spark” 级平台。它并不是一台通用迷你主机,而是一台大小约等于一本厚平装书(150 × 150 × 50.5 mm,重量不足 1.5 kg)的个人 AI 超级计算机:20 核 Arm CPU 与 Blackwell GPU 通过 NVLink-C2C 连接,搭配 128 GB LPDDR5x 统一内存,出厂即预装 NVIDIA 完整的 DGX OS 软件栈。
在竞争激烈的 GB10 阵营中,Acer 主打的是开箱体验。竞品可能需要你自己动手搭建 CUDA 环境,而 GN100 开机即进入 DGX OS,预装 PyTorch、Jupyter 与 Ollama,堪称所有 Spark 生态机型中最干净利落的软件预装方案。对于希望到货当天下午就能微调或部署本地模型的用户来说,这一点比规格表上的任何一行都更重要。
它擅长什么:本地 LLM 开发
GN100 存在的意义,是承担消费级显卡装不下的本地大语言模型工作。128 GB 统一内存池可以从容加载约 70B 至 120B 级别的模型,NVIDIA 还标称两台通过 ConnectX-7 互联后可对最高 405B 参数的模型进行推理。在 StorageReview 的 vLLM 测试中,GPT-OSS-20B 随批大小不同,速度从约 92 tokens/s 提升至 1,565 tokens/s,结果与“更广泛的 Spark 生态紧密集中在一起”,这与共享 GB10 芯片的预期完全一致。
这是一台面向开发者和创作者的机器:微调、检索增强生成、智能体原型开发、批量推理,以及扩散模型图像生成。如果你只是想低成本地跑一个 7B 至 13B 模型来聊天,那完全用不着它:一台能跑 70B 模型的 Strix Halo 主机,甚至一台用于本地 LLM 的 Mac mini M4 Pro 都要便宜得多。GN100 面向的是模型规模、数据集或吞吐目标已经超出这些方案能力的用户。
GB10 超级芯片与统一内存
GB10 Grace Blackwell 超级芯片将 20 核 Arm CPU 与 Blackwell GPU 集成在同一封装内,二者通过 NVLink-C2C 相连,共同寻址同一个 128 GB LPDDR5x-8533 内存池,中间无需经过 PCIe 拷贝。NVIDIA 标称第五代 Tensor Core 可提供 1 PetaFLOP 的 FP4 AI 算力(1,000 TOPS),完整的 CUDA 软件栈也可原生运行。
最大的亮点是统一内存。在 24 GB 的 RTX 4090 上,你得花不少功夫对 70B 模型做切分;而在这里,模型直接就能加载。对于认真做本地 AI 的人来说,让 GB10 这一类机器值得关注的正是这份容量,而非纯粹的 FLOPS。如果想了解 CPU、NPU 与 GPU 三条路线在这类任务上为何差异如此之大,可以先看看我们的科普文章迷你主机跑 LLM:NPU、iGPU 与 CPU 对比。
做工、连接性与集群
从物理层面看,GN100 结构紧凑且运行安静。StorageReview 测得它拥有整个 Spark 横评中最低的温度表现(突发负载下 CPU 峰值 74.7 °C,GPU 峰值 69 °C),并将其归功于效率优先的调校,而非激进地拉高功耗。他们指出的代价只是外观上的:底部是一块未经表面处理的铸造金属底板,体现了“不同的设计与成本理念”,不过结构上依然扎实可靠。
接口配置专为 AI 打造,而非面向普通台式机用途:
- 2× 200 Gbps NVIDIA ConnectX-7(QSFP):高速互联通道,可将两台 GN100 组合为一个支持 405B 模型的节点
- 10GbE RJ-45,用于常规网络连接
- 4× USB 3.2 Type-C、HDMI 2.1b、Wi-Fi 7、Bluetooth 5.1
ConnectX-7 双机互联是最突出的亮点:两台集群后可作为一台更大的机器协同工作,这正是从约 200B 跨入 405B 参数级别的方式。
内存带宽:真实使用中的天花板
这是每一位 GB10 买家都应该清楚认识的真实限制。统一内存带宽约为 273 GB/s。相较 CPU 这已相当充裕,但与独立显卡相比就显得平平:RTX 5090 的带宽远超 1.7 TB/s。LLM 推理中的 token 生成速度受内存带宽制约,因此对于能够装进 32 GB 显存的模型,GN100 的单 token 速度会比大型独立显卡更慢。
GN100 的优势在于相反的场景:那些任何单张消费级显卡都装不下的模型。你是在用峰值 tokens/s 换取把 70B 至 120B 模型完整放进内存的能力。买它是为了容量和开箱即用的 CUDA 环境,而不是为了最快的聊天响应。
价格与购买渠道
在北美,Veriton GN100 起售价为 $3,999(欧洲、中东和非洲地区 €3,999;澳大利亚 AUD $6,499),在 Amazon 上的 ASIN 为 B0GJZY12GQ。这让它稳稳落在 DGX Spark 阵营之中,与售价 $2,999 的 ASUS Ascent GX10 相比贵了一些,但这种差距只停留在纸面上,因为 Acer 的价格包含了更大的 4 TB Gen5 SSD 配置,核心同样是 GB10。IT Pro 称其为“运行和试验 AI 工作负载的典范机器……但价格高昂”,这也是对整个品类的公允总结。
需要注意的问题
- 没有 USB Type-A,也没有 USB4。 TechRadar 直接指出了这一点:所有 USB 端口都是 Type-C 3.2,老式外设需要转接头。
- 基本没有升级空间。 内存按设计采用板载焊接的 LPDDR5x,TechRadar 还指出内置 NVMe 不便于用户自行拆装。请在购买时一步到位选好所需的存储容量。
- 273 GB/s 带宽限制了 token 生成吞吐量,相比独立显卡存在差距。上文已有说明,但购买前值得再强调一次。
- DGX OS 是 Arm Linux,不是 Windows。 这是一套开发者环境。如果你期待的是一台顺带能做 AI 的 Windows 台式机,那它并不适合你,不如等待面向消费者的 RTX Spark 改款。
- 欧洲售价偏高。 €3,999 / AUD $6,499 的地区定价明显高于美国售价。
结论
Acer Veriton GN100 是 GB10 Grace Blackwell 阵营中打磨最完善的产品之一。在 StorageReview 测试的 Spark 机型中它温度最低,配备高速 4 TB Gen5 SSD,而且(这也是它真正的差异化优势)开机即进入已配置好 PyTorch、Jupyter 与 Ollama 的 DGX OS 镜像,免去了竞品上令人头疼的环境搭建成本。双 200 Gbps ConnectX-7 互联让双节点、405B 参数级集群成为切实可行的方案,而不只是规格表上的一条脚注。
它的局限属于整个品类,而非 Acer 的失误:约 273 GB/s 的内存带宽让单 token 速度表现一般,几乎没有有意义的升级路径,DGX OS 也是开发者平台而非日常使用的桌面系统。对于需要在桌面上拥有 128 GB 统一内存和开箱即用 CUDA 栈的机器学习工程师、研究人员或创作者来说,GN100 是很容易推荐的选择,也是 Spark 产品线中软件体验最干净的一款。而如果你的模型完全能装进 32 GB 显卡,或者只是想和 13B 模型聊聊天,那么一台 Strix Halo 台式机或 Framework Desktop 能帮你省下数千美元。