
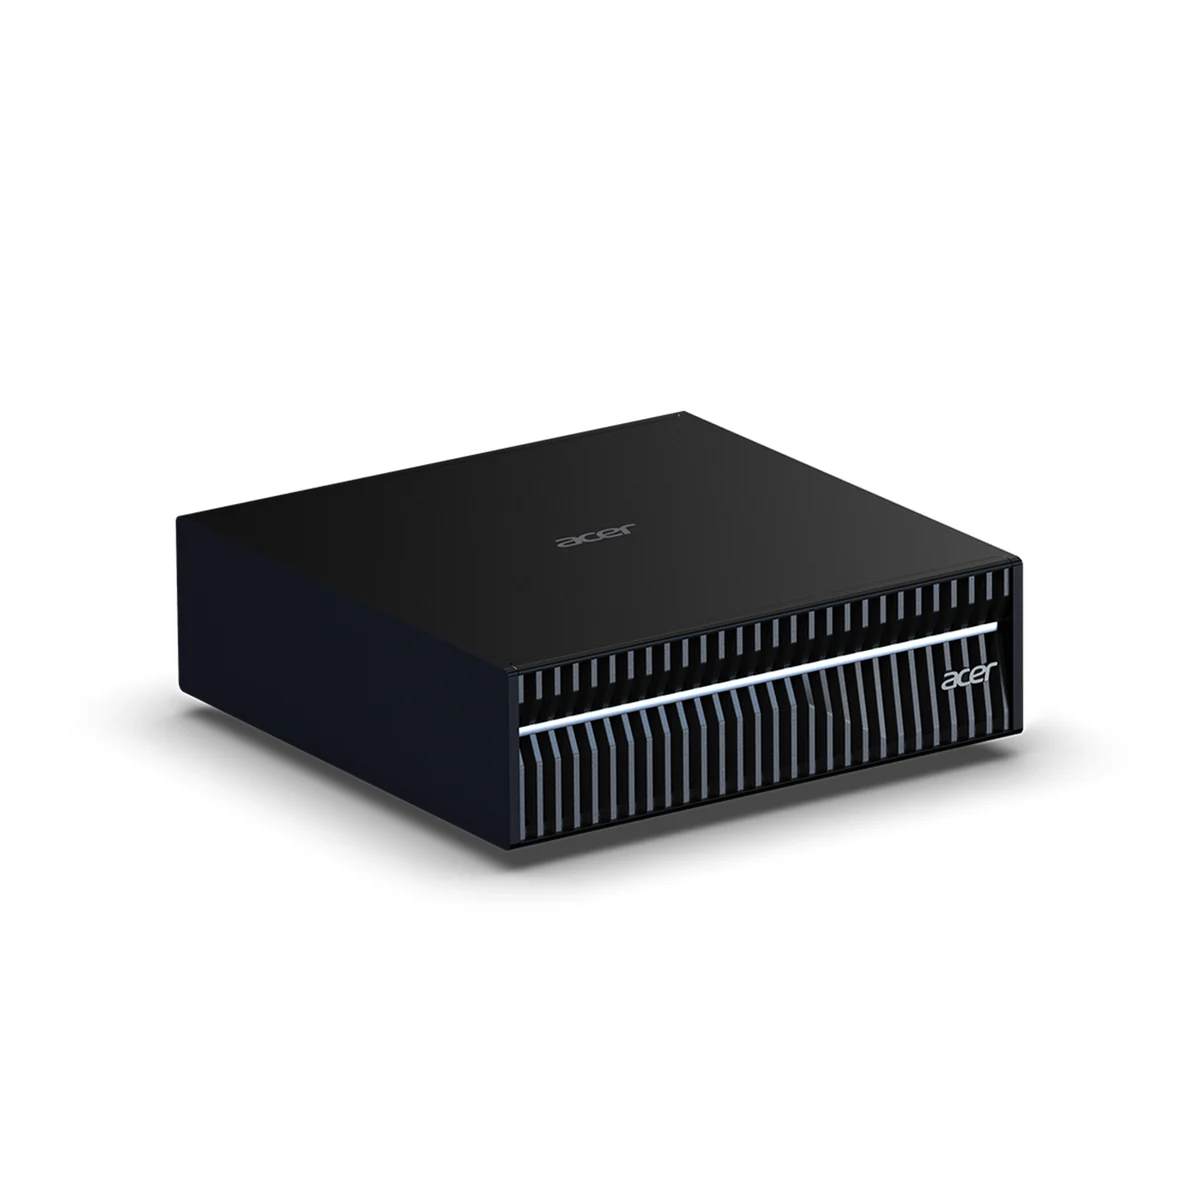
Qu’est-ce que l’Acer Veriton GN100
L’Acer Veriton GN100 est une mini station de travail IA à $3,999 bâtie sur la superpuce GB10 Grace Blackwell de NVIDIA, la même plateforme de classe « DGX Spark » que commercialisent NVIDIA, Dell, ASUS et GIGABYTE. Ce n’est pas un mini PC généraliste. C’est un superordinateur IA personnel à peu près de la taille d’un gros livre de poche (150 × 150 × 50.5 mm, moins de 1.5 kg) qui associe un CPU Arm 20 cœurs à un GPU Blackwell via NVLink-C2C, s’appuie sur 128 GB de mémoire LPDDR5x unifiée et est livré avec la pile logicielle DGX OS complète de NVIDIA déjà installée.
Dans un marché GB10 encombré, Acer mise sur l’expérience dès le déballage. Là où des machines concurrentes peuvent vous laisser assembler vous-même un environnement CUDA, la GN100 démarre sous DGX OS avec PyTorch, Jupyter et Ollama préchargés, sans doute la préinstallation logicielle la plus propre de toutes les machines de l’écosystème Spark. Pour un acheteur qui veut affiner ou servir un modèle local l’après-midi même de la livraison, cela compte davantage qu’une ligne de fiche technique.
À quoi elle sert : le développement de LLM en local
La raison d’être de la GN100, c’est le travail sur les grands modèles de langage en local qui ne tient pas sur un GPU grand public. Le pool unifié de 128 GB permet de charger confortablement des modèles dans la plage d’environ 70B à 120B, et NVIDIA annonce la plateforme pour l’inférence sur des modèles jusqu’à 405B paramètres lorsque deux unités sont reliées via ConnectX-7. Lors des tests vLLM de StorageReview, GPT-OSS-20B est passé d’environ 92 à 1,565 tokens/seconde selon la taille de lot, des résultats « étroitement groupés avec le reste de l’écosystème Spark », exactement ce qu’on attend d’un silicium GB10 commun.
C’est une machine pour développeurs et créateurs : fine-tuning, génération augmentée par récupération (RAG), prototypage agentique, inférence par lots et génération d’images par modèles de diffusion. Si votre objectif est de faire tourner un modèle 7B–13B pour discuter avec un budget serré, vous n’en avez pas besoin : une machine Strix Halo capable de faire tourner des modèles 70B, voire un Mac mini M4 Pro pour les LLM locaux, coûte bien moins cher. La GN100 s’adresse à ceux dont les modèles, les jeux de données ou les objectifs de débit ont dépassé ces options.
La superpuce GB10 et la mémoire unifiée
La superpuce GB10 Grace Blackwell réunit un CPU Arm 20 cœurs et un GPU Blackwell dans un même boîtier, reliés par NVLink-C2C pour que les deux côtés adressent le même pool de 128 GB de LPDDR5x-8533 sans copie PCIe intermédiaire. NVIDIA annonce 1 PetaFLOP de performances IA en FP4 (1,000 TOPS) grâce aux Tensor Cores de 5e génération, et toute la pile CUDA fonctionne nativement.
Le chiffre phare, c’est la mémoire unifiée. Sur une RTX 4090 de 24 GB, découper un modèle 70B demande de vrais efforts ; ici, il se charge tout simplement. C’est cette capacité, et non la puissance brute en FLOPS, qui rend la classe GB10 intéressante pour quiconque fait de l’IA locale sérieuse. Pour comprendre pourquoi les approches CPU, NPU et GPU diffèrent autant pour ce type de travail, notre article explicatif NPU vs iGPU vs CPU pour les LLM sur mini PC constitue une bonne introduction.
Conception, connectique et clustering
Physiquement, la GN100 est dense et silencieuse. StorageReview a mesuré le profil thermique le plus frais de tout son comparatif Spark (pic à 74.7 °C pour le CPU et 69 °C pour le GPU en charge ponctuelle), qu’il attribue à un réglage privilégiant l’efficacité plutôt qu’une course agressive à la puissance. Le compromis relevé est esthétique : une plaque inférieure en métal moulé non finie qui reflète « une philosophie de conception et de coûts différente », même si elle reste structurellement solide.
La connectique est pensée pour l’IA, pas pour un usage bureautique :
- 2× NVIDIA ConnectX-7 200 Gbps (QSFP) : l’interconnexion haut débit pour coupler deux GN100 en un seul nœud capable de gérer 405B paramètres
- 10GbE RJ-45 pour le réseau classique
- 4× USB 3.2 Type-C, HDMI 2.1b, Wi-Fi 7, Bluetooth 5.1
Ce couplage ConnectX-7 est le point fort : deux unités en cluster se comportent comme une seule machine plus grande, et c’est ainsi que l’on passe d’environ 200B au territoire des 405B paramètres.
Bande passante mémoire : le vrai plafond en usage réel
Voici la limite honnête que tout acheteur de GB10 doit bien intégrer. La bande passante de la mémoire unifiée est d’environ 273 GB/s. C’est généreux face à un CPU, mais modeste face à un GPU dédié : une RTX 5090 dépasse largement 1.7 TB/s. En inférence LLM, la vitesse de génération de tokens dépend de la bande passante mémoire, donc la GN100 paraîtra plus lente par token qu’une grosse carte dédiée sur les modèles qui tiennent dans 32 GB de VRAM.
L’avantage de la GN100 se situe dans le cas inverse : les modèles qui ne tiennent pas sur un GPU grand public. Vous sacrifiez le débit maximal en tokens/seconde pour pouvoir tout simplement garder en mémoire un modèle de 70B à 120B. Achetez-la pour sa capacité et un environnement CUDA clés en main, pas pour obtenir les réponses de chat les plus rapides possibles.
Prix et où l’acheter
En Amérique du Nord, la Veriton GN100 démarre à $3,999 (EMEA €3,999 ; AUD $6,499). Elle est référencée sur Amazon sous l’ASIN B0GJZY12GQ. Elle se place ainsi en plein dans la cohorte DGX Spark, au-dessus de l’ASUS Ascent GX10 à $2,999 seulement sur le papier, puisque le prix d’Acer inclut la configuration avec le SSD Gen5 de 4 TB plus généreux et le même cœur GB10. IT Pro l’a qualifiée de « machine exemplaire pour exécuter et expérimenter des charges de travail IA… mais avec un prix énorme », ce qui résume équitablement toute la catégorie.
Ce que nous signalons
- Ni USB Type-A ni USB4. TechRadar l’a souligné directement : tous les ports USB sont en Type-C 3.2, donc les périphériques plus anciens nécessitent des adaptateurs.
- Évolutivité pratiquement nulle. La mémoire LPDDR5x est soudée par conception, et TechRadar note que le NVMe interne n’est pas facilement accessible à l’utilisateur. Achetez d’emblée la capacité de stockage dont vous avez besoin.
- La bande passante de 273 GB/s plafonne le débit de génération de tokens face à un GPU dédié, comme évoqué plus haut, mais cela mérite d’être rappelé avant l’achat.
- DGX OS est un Linux Arm, pas Windows. C’est un environnement de développement. Si vous attendiez un PC de bureau Windows capable aussi de faire de l’IA, ce n’est pas la bonne machine. Attendez plutôt la déclinaison grand public RTX Spark.
- Chère en Europe. Les tarifs régionaux de €3,999 / AUD $6,499 sont nettement plus élevés que le prix américain.
Verdict
L’Acer Veriton GN100 est l’une des propositions les plus abouties du segment GB10 Grace Blackwell. C’est la plus fraîche des machines Spark testées par StorageReview, elle embarque un SSD Gen5 rapide de 4 TB et (son vrai facteur de différenciation) démarre directement sur une image DGX OS avec PyTorch, Jupyter et Ollama déjà configurés, ce qui vous épargne la corvée d’installation qui pénalise les modèles concurrents. L’interconnexion double ConnectX-7 200 Gbps fait du clustering à deux nœuds pour 405B paramètres une véritable option plutôt qu’une simple note de bas de page.
Ses limites sont celles de la catégorie, pas des erreurs d’Acer : une bande passante mémoire d’environ 273 GB/s rend la vitesse par token modeste, il n’existe aucune véritable possibilité d’évolution, et DGX OS est une plateforme de développement plutôt qu’un système de bureau pour le quotidien. Pour un ingénieur ML, un chercheur ou un créateur qui a besoin de 128 GB de mémoire unifiée et d’une pile CUDA clés en main sur son bureau, la GN100 se recommande facilement, et offre l’expérience logicielle la plus soignée de la gamme Spark. Pour quiconque dont les modèles tiennent confortablement dans un GPU de 32 GB, ou qui veut simplement discuter avec un modèle 13B, un PC de bureau Strix Halo ou le Framework Desktop permettra d’économiser des milliers de dollars.