
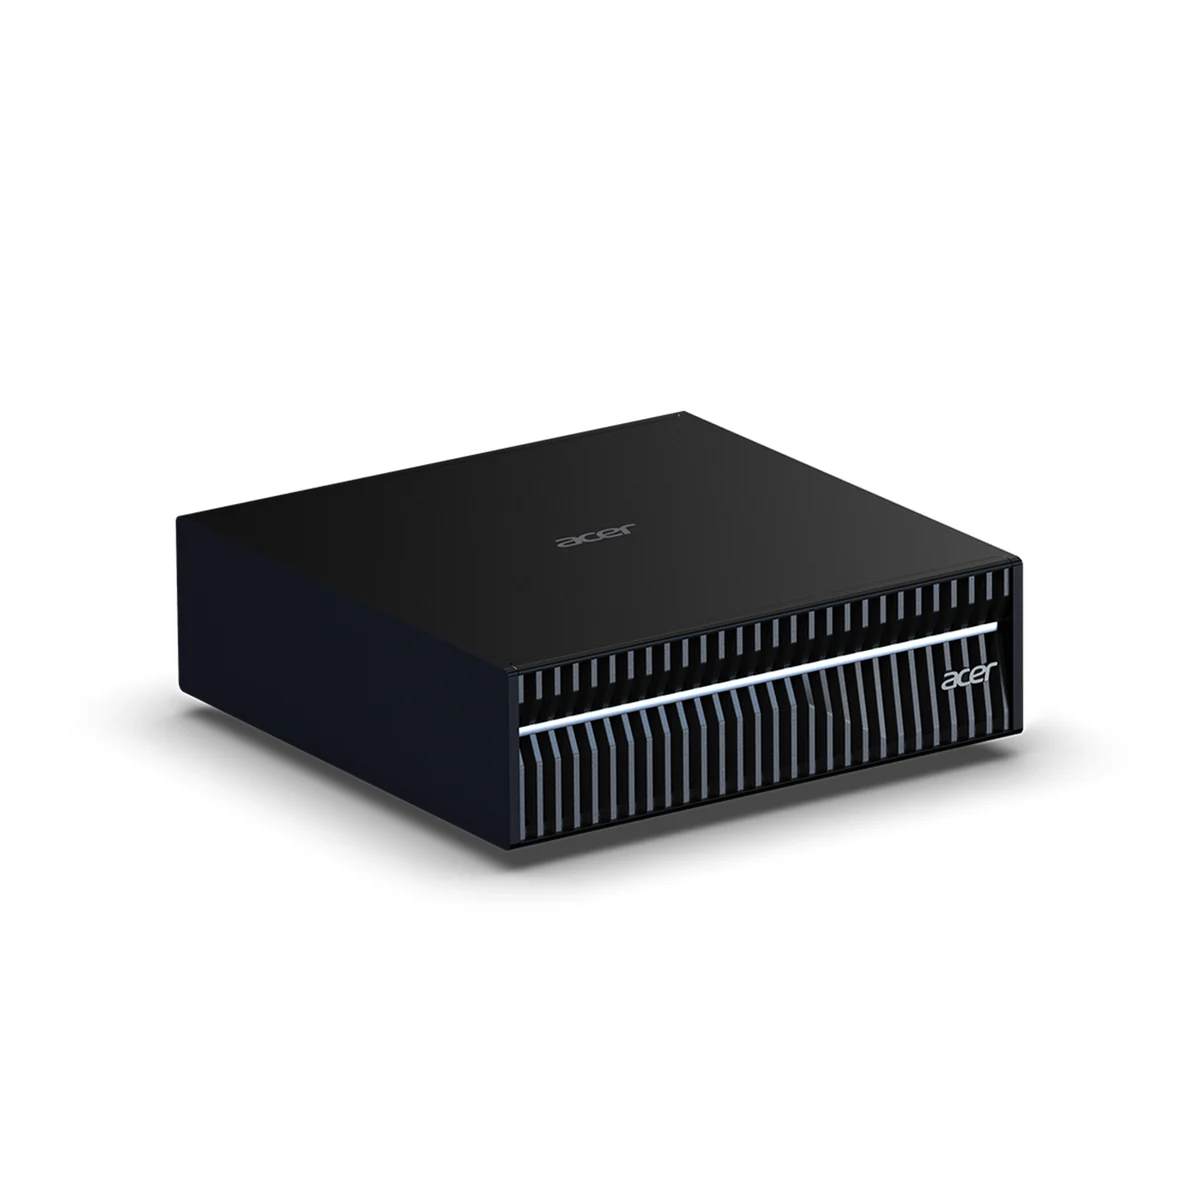
Was die Acer Veriton GN100 ist
Die Acer Veriton GN100 ist eine KI-Mini-Workstation für $3,999 auf Basis des NVIDIA GB10 Grace Blackwell Superchips, also derselben Plattform der „DGX Spark“-Klasse, die auch NVIDIA, Dell, ASUS und GIGABYTE ausliefern. Ein Mini-PC für alle Zwecke ist sie nicht. Sie ist ein persönlicher KI-Supercomputer etwa in der Größe eines dicken Taschenbuchs (150 × 150 × 50,5 mm, unter 1,5 kg), der eine Arm-CPU mit 20 Kernen über NVLink-C2C mit einer Blackwell-GPU koppelt, 128 GB LPDDR5x Unified Memory bereitstellt und mit dem kompletten DGX-OS-Softwarestack von NVIDIA vorinstalliert ausgeliefert wird.
Acers Ansatz in einem dicht besetzten GB10-Feld ist das Erlebnis direkt nach dem Auspacken. Während man bei Konkurrenzgeräten mitunter erst eine CUDA-Umgebung zusammenbauen muss, startet die GN100 in DGX OS mit vorinstalliertem PyTorch, Jupyter und Ollama, wohl die sauberste Softwareausstattung aller Geräte im Spark-Ökosystem. Wer ein lokales Modell noch am Liefertag feintunen oder bereitstellen will, für den zählt das mehr als ein Punkt im Datenblatt.
Wofür sie taugt: lokale LLM-Entwicklung
Die Daseinsberechtigung der GN100 ist Arbeit mit lokalen großen Sprachmodellen, die nicht auf eine Consumer-GPU passt. Der Unified-Memory-Pool mit 128 GB lädt Modelle im Bereich von etwa 70B bis 120B problemlos, und NVIDIA spezifiziert die Plattform für Inferenz mit Modellen bis 405B Parameter, wenn zwei Geräte über ConnectX-7 verbunden sind. In den vLLM-Tests von StorageReview skalierte GPT-OSS-20B je nach Batchgröße von etwa 92 auf 1.565 Token pro Sekunde, Ergebnisse, die „eng gruppiert mit dem übrigen Spark-Ökosystem“ lagen, genau wie man es bei identischem GB10-Silizium erwartet.
Das ist eine Maschine für Entwickler und Kreative: Feintuning, Retrieval-Augmented Generation, Prototypen für Agenten, Batch-Inferenz und Bildbearbeitung mit Diffusionsmodellen. Wer nur ein 7B- bis 13B-Modell günstig zum Chatten betreiben will, braucht sie nicht: Eine Strix-Halo-Box, die 70B-Modelle ausführt, oder sogar ein Mac mini M4 Pro für lokale LLMs ist deutlich günstiger. Die GN100 richtet sich an Menschen, deren Modelle, Datensätze oder Durchsatzziele diesen Optionen entwachsen sind.
Der GB10-Superchip und Unified Memory
Der GB10 Grace Blackwell Superchip vereint eine Arm-CPU mit 20 Kernen und eine Blackwell-GPU auf einem Package, verbunden über NVLink-C2C, sodass beide Seiten denselben 128-GB-Pool aus LPDDR5x-8533 ansprechen, ohne PCIe-Kopie dazwischen. NVIDIA nennt 1 PetaFLOP FP4-KI-Leistung (1.000 TOPS) aus den Tensor Cores der 5. Generation, und der vollständige CUDA-Stack läuft nativ.
Die entscheidende Zahl ist der Unified Memory. Auf einer RTX 4090 mit 24 GB muss man ein 70B-Modell mühsam aufteilen; hier wird es einfach geladen. Diese Kapazität, nicht die rohe FLOPS-Zahl, macht die GB10-Klasse für alle interessant, die ernsthaft lokale KI betreiben. Wer verstehen will, warum sich CPU-, NPU- und GPU-Pfade für diese Arbeit so stark unterscheiden, findet in unserem Erklärartikel zu NPU vs. iGPU vs. CPU für LLMs auf Mini-PCs eine nützliche Einführung.
Aufbau, Konnektivität und Clustering
Physisch ist die GN100 kompakt und leise. StorageReview maß das kühlste Temperaturprofil im gesamten Spark-Vergleich (CPU maximal 74,7 °C, GPU 69 °C unter Burst-Last) und führt das auf eine auf Effizienz ausgelegte Abstimmung statt auf aggressives Ausreizen der Leistungsaufnahme zurück. Der festgestellte Kompromiss ist optischer Natur: eine unbehandelte Bodenplatte aus Metallguss, die „eine andere Design- und Kostenphilosophie“ widerspiegelt, strukturell aber solide bleibt.
Die Konnektivität ist auf KI zugeschnitten, nicht auf den Desktop-Einsatz:
- 2× 200 Gbps NVIDIA ConnectX-7 (QSFP): die Hochgeschwindigkeitsverbindung, um zwei GN100 zu einem 405B-fähigen Knoten zu koppeln
- 10GbE RJ-45 für herkömmliche Netzwerke
- 4× USB 3.2 Type-C, HDMI 2.1b, Wi-Fi 7, Bluetooth 5.1
Die ConnectX-7-Kopplung ist das herausragende Merkmal: Zwei geclusterte Geräte verhalten sich wie eine einzige größere Maschine, und genau so gelangt man von etwa 200B in den Bereich von 405B Parametern.
Speicherbandbreite: die Grenze in der Praxis
Hier liegt die ehrliche Grenze, die jeder GB10-Käufer verinnerlichen sollte. Die Bandbreite des Unified Memory beträgt rund 273 GB/s. Im Vergleich zu einer CPU ist das großzügig, im Vergleich zu einer dedizierten GPU bescheiden: Eine RTX 5090 schafft deutlich über 1,7 TB/s. Die Generierungsgeschwindigkeit von Token bei der LLM-Inferenz hängt an der Speicherbandbreite, daher wirkt die GN100 pro Token langsamer als eine große dedizierte Karte bei Modellen, die sehr wohl in 32 GB VRAM passen.
Ihr Vorteil liegt im umgekehrten Fall: bei Modellen, die auf keine einzelne Consumer-GPU passen. Man tauscht maximale Token pro Sekunde gegen die Möglichkeit, ein Modell mit 70B bis 120B Parametern überhaupt im Speicher zu halten. Kaufen sollte man sie für Kapazität und eine schlüsselfertige CUDA-Umgebung, nicht für die schnellstmögliche Chat-Antwort.
Preise und Bezugsquellen
In Nordamerika startet die Veriton GN100 bei $3,999 (EMEA €3,999; AUD $6,499). Bei Amazon ist sie unter der ASIN B0GJZY12GQ gelistet. Damit liegt sie mitten in der DGX-Spark-Gruppe, nur auf dem Papier etwas über der ASUS Ascent GX10 für $2,999, denn Acers Preis umfasst die größere Konfiguration mit 4-TB-Gen5-SSD und denselben GB10-Kern. IT Pro nannte sie „eine vorbildliche Maschine zum Ausführen und Experimentieren mit KI-Workloads… aber mit einem enormen Preisschild“, was die gesamte Kategorie treffend zusammenfasst.
Was wir anmerken
- Kein USB Type-A und kein USB4. TechRadar hat das direkt bemängelt: Alle USB-Ports sind Type-C 3.2, ältere Peripherie braucht also Adapter.
- Praktisch keine Aufrüstbarkeit. Der Speicher ist konstruktionsbedingt verlöteter LPDDR5x, und laut TechRadar ist die interne NVMe für Nutzer nicht leicht zugänglich. Die benötigte Speicherstufe sollte man von vornherein kaufen.
- 273 GB/s Bandbreite begrenzen den Token-Durchsatz gegenüber einer dedizierten GPU. Oben bereits behandelt, vor dem Kauf aber eine Wiederholung wert.
- DGX OS ist Arm-Linux, nicht Windows. Das ist eine Entwicklungsumgebung. Wer einen Windows-Desktop erwartet, der nebenbei KI kann, ist hier falsch. Besser auf die RTX-Spark-Neuauflage für Endkunden warten.
- Teuer in Europa. Die regionalen Preise von €3,999 bzw. AUD $6,499 liegen spürbar über dem US-Preis.
Fazit
Die Acer Veriton GN100 gehört zu den ausgereiftesten Geräten im GB10-Grace-Blackwell-Feld. Sie läuft am kühlsten unter den von StorageReview getesteten Spark-Boxen, bringt eine schnelle 4-TB-Gen5-SSD mit und startet (ihr eigentliches Alleinstellungsmerkmal) direkt in ein DGX-OS-Image mit bereits konfiguriertem PyTorch, Jupyter und Ollama, was den Einrichtungsaufwand erspart, der bei Konkurrenzgeräten anfällt. Die doppelte ConnectX-7-Verbindung mit 200 Gbps macht Clustering mit zwei Knoten und 405B Parametern zu einem echten Weg statt zu einer Fußnote.
Ihre Grenzen sind die der Kategorie, keine Fehltritte von Acer: Rund 273 GB/s Speicherbandbreite machen die Geschwindigkeit pro Token bescheiden, einen nennenswerten Aufrüstpfad gibt es nicht, und DGX OS ist eine Entwicklungsplattform statt eines Alltags-Desktops. Für ML-Engineers, Forschende oder Kreative, die 128 GB Unified Memory und einen schlüsselfertigen CUDA-Stack auf dem Schreibtisch brauchen, ist die GN100 eine klare Empfehlung und bietet das sauberste Softwareerlebnis im Spark-Aufgebot. Wessen Modelle bequem auf eine 32-GB-GPU passen oder wer nur mit einem 13B-Modell chatten möchte, spart mit einem Strix-Halo-Desktop oder dem Framework Desktop Tausende.