
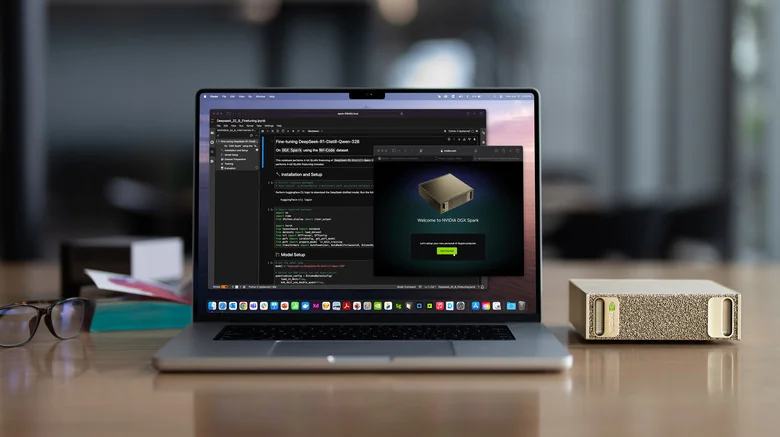
製品概要
NVIDIA DGX Sparkは、分厚いペーパーバックほどの大きさのパーソナルAIスーパーコンピューターです。NVIDIAのGB10 Grace Blackwellスーパーチップを中核にした150 mmのアルミ製キューブで、20コアのArm CPUとBlackwell GPUを1つのパッケージに収め、128 GBのユニファイドメモリを接続し、NVIDIA独自のDGX OSを搭載しているため、CUDAスタック一式が箱から出してすぐに動きます。価格は$3,999(2026年初頭のメモリ価格高騰を受けて、現在は$4,699近く)で、一般的な意味でのミニPCではありません。クラウドのGPUを借りる代わりに、大規模言語モデルを手元のデスクで実行し、ファインチューニングするための開発者向けワークステーションです。
これはGB10のリファレンス機であり、他社のあらゆるバリエーションの比較基準となるFounders Editionです。ASUS Ascent GX10やほかのGrace Blackwellデスクトップと比較検討しているなら、これが基準になります。また、同じGB10クラスのシリコンを別の層に向けて作り直した、今後登場するコンシューマー向けASUS ProArt RTX Spark ミニPCの、すでに販売中の兄弟機でもあります。
得意分野:ローカルAIとLLM開発
DGX Sparkはただ1つの仕事のために存在し、その仕事をうまくこなします。クラウドアカウントなしで、大規模モデルをローカルで実行することです。
- ローカルLLM推論: 128 GBのユニファイドメモリにより、最大約200Bパラメータのモデル(量子化済み)を丸ごとデバイス上に読み込めます。4-bitの70Bモデルなら、長いコンテキストウィンドウの余裕を残してメモリに快適に収まります。
- ファインチューニングとプロトタイピング: 本来ならレンタルのA100が必要になるLoRAやQLoRAのファインチューニングが、この1台に収まります。エミュレーション層ではなく、本物のCUDA開発環境です。
- 初日からCUDAネイティブ: Apple Mac StudioやAMD Ryzen AI Max搭載機とは異なり、DGX Sparkは本番環境にデプロイするのとまったく同じCUDA、cuDNN、TensorRT、NIMスタックで動作します。ここで書いたコードは、そのままDGXサーバーに移行できます。
- 軽いクリエイター作業やオフィス用途: DGX OSはデスクトップLinuxなので、ブラウザー、ターミナル、クリエイティブツールも扱えます。ただし、それはおまけであって本題ではありません。
Tom’s Hardwareはうまくまとめています。開発者にとって重要なワークロードでAMDのRyzen AI Max+ 395を上回る、何でもこなせるAIサンドボックスだ、と。
GB10スーパーチップとユニファイドメモリ
すべてはGB10 Grace Blackwellスーパーチップにかかっています。NVIDIAはGraceクラスのCPU(10× Cortex-X925パフォーマンスコア + 10× Cortex-A725効率コア)とBlackwell GPUを、PCIeよりはるかに広帯域なコヒーレント・インターコネクトであるNVLink-C2Cで結合しました。GPUは第5世代Tensorコアと第4世代RTコアを備え、**FP4で1 PetaFLOP(1,000 TOPS)**の演算性能を発揮します。
CPUとGPUが1つの128 GB LPDDR5xコヒーレントメモリプールを共有するため、PCIeバス越しにテンソルをコピーする必要も、モデルをVRAMとシステムRAMに分割する必要もありません。GPUは128 GBすべてに直接アクセスします。このユニファイドプールこそが、ほかの環境では複数のディスクリートGPUが必要になる200Bパラメータのモデルを、2リットル未満の筐体に収められる理由です。
筐体、接続性、クラスタリング
筐体は大型のDGX Stationのゴールドの「チーズおろし器」風フロントを受け継ぎ、1.2 kgまで小型化したものです。横置きでも縦置きでも使え、240 Wの外部電源から給電します(GB10自体のTDPは140 W)。
開発者向けという意図がはっきり表れているのが接続性です。
- ConnectX-7 NICと2× 200 Gbps QSFPポートが目玉機能です。2台のDGX Sparkを直接連結して256 GBのクラスタを構成し、1台には収まらないモデルを実行できます。
- 10 GbE RJ-45、Wi-Fi 7、Bluetooth 5.4
- 4× USB-C、1× HDMI 2.1a、USB-C経由で最大3× DisplayPort
- 4 TBの自己暗号化NVMe:高速で安全ですが、実質的に固定式です(ユーザーが交換できるベイではありません)
DGX Sparkを2台クラスタ化できますか?
できます。ConnectX-7のデュアル200GbEファブリックは、まさにそのために作られています。2台を連結すれば256 GBのユニファイドメモリが得られ、400Bパラメータ級のモデルを扱えます。これこそ、Mac StudioではなくNVIDIAの製品を買う最大の理由です。クラスタリングの手段がハックではなくネイティブに用意されています。
メモリ帯域幅:実用上の上限
ここからが正直な話です。DGX Sparkのメモリ帯域幅は約273 GB/sで、制約になるのは演算性能ではなくこの帯域幅です。
LLMのトークン生成速度は、メモリ帯域幅にほぼ比例します。Mac Studioの約546 GB/sはSparkのほぼ2倍で、同じモデルでもトークン/秒が高くなります。RTX 5090のGDDR7はまったく別次元です。つまり、DGX Sparkは5090には載らない200Bモデルを保持できますが、5090の小さなVRAMに収まるモデルであれば、5090のほうがトークン生成は速くなります。
要するに、DGX Sparkは生のスループットではなく、容量とCUDAとの互換性に最適化されています。「そもそもこの巨大なモデルを動かして試行錯誤できるか」のためのマシンであり、「デスクでもっとも速い対話型チャットボットはどれか」のためのマシンではありません。Tom’s HardwareとServeTheHomeのレビュアーも同じ結論に達しています。帯域幅がアキレス腱であり、それを承知のうえで買うべきだということです。
価格と購入先
DGX Sparkは2025年10月に**$3,999で発売されました。世界的なメモリ不足により2026年初頭にかけて実売価格が上昇したため、在庫状況に応じて$3,999–$4,699**の範囲で予算を見込んでおきましょう。NVIDIAのパートナー経由で販売され、Amazonにも掲載されています。アフィリエイトのリストはFounders Editionです。
この価格で手に入るのは、NVIDIAのシリコン、NVIDIAのOS、NVIDIAのクラスタリング・ファブリックを1つにまとめたサポート付きのパッケージです。ASUS Ascent GX10のようなパートナー製バリエーションのほうが安いこともあります。Foundersブランドよりも冷却やSSDの世代を重視するなら、比較する価値があります。関連記事:GIGABYTE AI TOP ATOMレビュー、MSI EdgeXpert MS-C931レビュー、DGX Spark 64GBの価格に関する記事。
注意点
優れているものの用途が特化したマシンについて、公平に指摘しておきます。
- 273 GB/sの帯域幅がトークン速度を制限します。 単一ユーザーの対話型推論では、大容量VRAMのディスクリートGPUやMac Studioのほうが、それらに収まるモデルでは速く感じられるかもしれません。
- DGX OSはWindowsではなくArm Linuxです。 これはCUDA開発環境です。汎用デスクトップが欲しいなら、この製品は選ぶべきではありません。
- メモリとストレージはユーザーによるアップグレード不可です。 128 GBと4 TBがすべてです。構成は購入前に決めておきましょう。
- 価格の変動: 発売後の値上がりにより、希望小売価格より数百ドル多く支払うことになるかもしれません。販売ページをこまめに確認しましょう。
NVIDIA DGX Sparkの結論
NVIDIA DGX Sparkは、その性格を理解したうえでなら、現在購入できるもっとも完成度の高いパーソナルAIスーパーコンピューターです。GB10 Grace Blackwellスーパーチップ、128 GBのユニファイドメモリ、ネイティブのCUDA、デュアル200GbEのクラスタリングにより、最大200Bパラメータのモデルを実行しファインチューニングするための本格的なローカル環境となり、クラウドのDGX環境へもスムーズに移行できます。
273 GB/sのメモリ帯域幅については冷静に理解しておきましょう。これは容量と互換性のマシンであり、スループットの王者ではありません。CUDAを日常的に使うAI開発者、研究者、MLエンジニアにとっては、そのトレードオフはまさに適切で、DGX Sparkは自信を持っておすすめできます。高速な汎用デスクトップや、単一チャットセッションでの最大のトークン/秒を求める人は、ほかを当たってください。また、同じシリコンが欲しいなら、決める前にASUS Ascent GX10と比較してみてください。