
它是什么
MSI EdgeXpert MS-C931 是 MSI 对 NVIDIA DGX Spark 方案的诠释:一台约 1.2 升的桌面机,核心是 GB10 Grace Blackwell 超级芯片,配备 128 GB 统一内存,标称 FP4 算力达 1 PetaFLOP。它不是一台通用迷你主机,而是一台面向开发者和研究人员的个人 AI 超级计算机,供他们在本地微调和运行大语言模型,而不必租用云端 GPU。它与 NVIDIA DGX Spark 和 ASUS Ascent GX10 属于同一类机器,4 TB 配置售价约 $3,999。
从纸面上看,MSI 这台机器的不同之处在于散热设计。参考版 DGX Spark 采用常规散热器,而 EdgeXpert MS-C931 采用均热板加三热管阵列,MSI 宣传其持续推理速度比参考设计快约 10%。请把这个数字当作厂商宣传:MSI 没有公布经独立复现的基准测试,我们也没有验证过。
它适合做什么(本地 AI / LLM 开发)
MS-C931 只为一项工作而生:在你的桌面上离线运行和调优 AI 模型。 128 GB 统一内存是最大卖点:由于 20 核 Arm CPU 和 Blackwell GPU 共享同一个内存池,全部容量都可以用来存放模型权重。这足以在本地加载最高约 2000 亿参数的模型(量化后),或在不溢出到较慢存储的情况下微调中等规模的模型。
具体来说,它适合:
- 本地 LLM 推理:以可用的速度运行 70B–120B 级别的模型,或尝试那些根本装不进 24–32 GB 消费级 GPU 的 200B 级别模型。
- 模型微调与原型开发:LoRA/QLoRA 训练、RAG 流水线,以及基于完整 CUDA 软件栈的智能体开发,无需承担云端数据传出费用或按 token 计费。
- 依赖 NVIDIA 软件生态的创作与研究负载:扩散模型、本地语音转写,以及以推理为主的创作工具。
- 轻度桌面/办公使用算是附带的好处,不过 DGX OS 是 Arm Linux 开发环境,而不是 Windows 桌面。如果你想要一台日常主力电脑,这台不是。
GB10 超级芯片与统一内存
GB10 Grace Blackwell 超级芯片将一颗 20 核 Arm CPU(10× Cortex-X925 性能核 + 10× Cortex-A725 能效核)与一颗 Blackwell GPU 结合在一起,后者拥有 6,144 个 CUDA 核心和第五代 Tensor Core。CPU 与 GPU 通过 NVLink-C2C 连接,这是一条一致性高带宽链路,让两颗处理器都能直接寻址同一块 128 GB LPDDR5X,无需来回复制数据。
这种统一设计正是关键所在。在传统 PC 上,一个 120B 模型必须拆分到系统内存和独立 GPU 有限的显存中,PCIe 成为瓶颈。而在这里,模型位于 GPU 可以直接访问的同一地址空间中。标称数据(1 PetaFLOP FP4 / 1,000 AI TOPS)描述的是 Blackwell GPU 在最低精度下的峰值吞吐量,对于一台桌面小机器而言,这确实是数据中心级别的数字。
做工、连接与集群
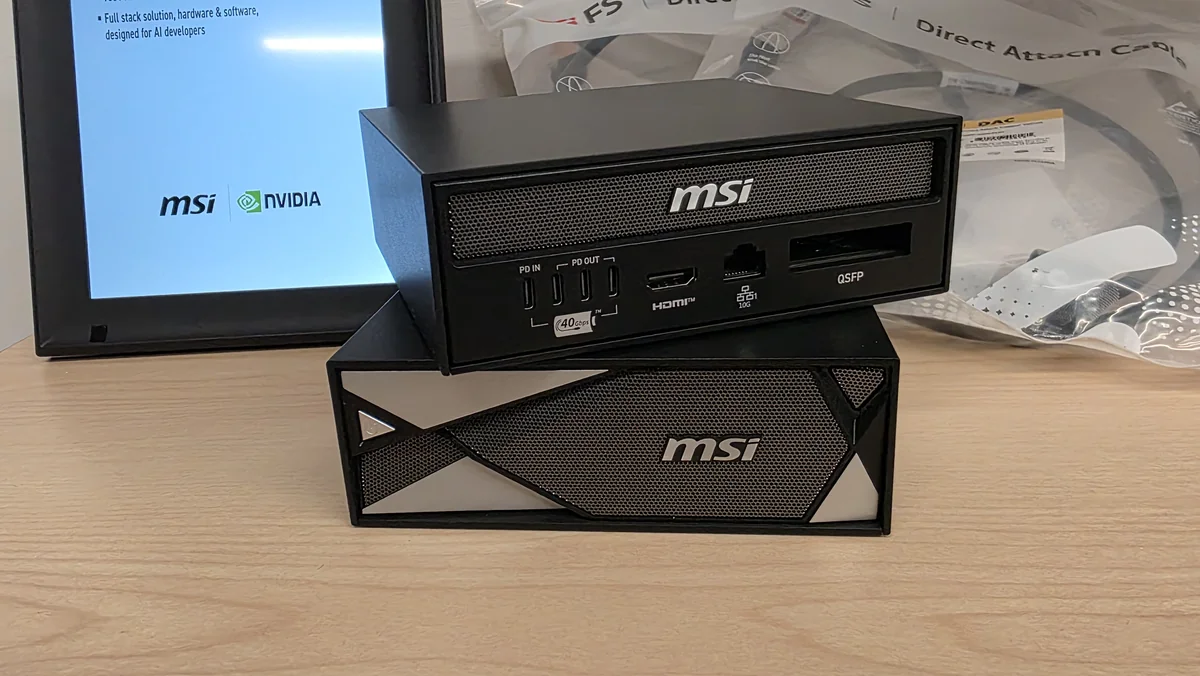
外观上,MS-C931 是一个紧凑的黑色盒子(约 151 × 151 × 52 mm,约 1.2 kg),前面板带有开孔,印有 MSI/NVIDIA 标识。前置接口包括 USB4 Type-C、HDMI 和 SD 卡槽;后部还有更多 USB-C 和显示输出接口。
网络能力正是这些 GB10 机器配得上“超级计算机”名号的地方:
- ConnectX-7 双 QSFP 网络,最高支持 200GbE。这是集群互联架构。两台 EdgeXpert 可以连接在一起汇聚内存,跨两台设备运行单个超过 200B 参数的模型。
- 双 10 GbE 标准以太网,用于常规连接。
- Wi-Fi 7 与 Bluetooth 5.3。
散热是 MSI 的差异化所在。均热板连接三根热管是比参考版 Spark 更激进的散热方案,其逻辑很直接:GB10 的持续推理吞吐量在一定程度上受散热限制,因此更好的散热应能让频率更长时间保持在更高水平。这说得通。但还是那句话,MSI 所说的约 10% 优势是营销数字,并未经过验证。
内存带宽:真实世界的上限
这是每位 GB10 买家都需要知道的坦诚提醒。限制 token 生成速度的不是 1 PetaFLOP 的算力,而是约 273 GB/s 的内存带宽。 大语言模型的解码受内存带宽限制:每生成一个 token,都需要让模型权重流经一遍内存系统。像 RTX 5090 这样的独立显卡带宽远超 1.7 TB/s,因此对于能装进 32 GB 显存的模型,5090 生成 token 的速度要快得多。
EdgeXpert 为你买到的是容量,而不是原始速度:它能运行 5090 在物理上无法加载的模型。所以在 120B 级别模型上,token 吞吐量会显得比较一般:用于开发和批处理工作是够用的,但不会像在旗舰游戏 GPU 上运行小模型那样瞬间刷出大段文字。如果你的负载能轻松装进 24–32 GB,一台配备 5090 的台式机既更便宜也更快。如果装不进,这就是少数能运行它们的桌面机之一。请据此调整预期。
价格与购买渠道
4 TB 版 EdgeXpert MS-C931 在 Amazon 上的标价约为 $3,999,高于售价 $2,999–$3,000 的参考版 DGX Spark,与其他高端 GB10 机器大致相当。MSI 销售多个版本(Gen4 与 Gen5 NVMe、4 TB 与 8 TB 存储,以及 2026 年更新款 SKU),因此购买前请确认具体的存储代际和容量,因为价格会随之变化。产品附带 3 年保修,相比这一品类中的部分竞品,这是一项实实在在的优势。
对大多数买家而言,只有当你特别看重更强的散热、更大/更快的存储选项或 MSI 的保修渠道时,相对参考版 Spark 的溢价才说得过去。相关阅读:我们评测过的其他 GB10 桌面机包括 GIGABYTE AI TOP ATOM 和 Acer Veriton GN100。
需要注意的地方
- 内存带宽限制了 token 生成速度。 273 GB/s 才是真正的上限。在大模型上不要指望 5090 级别的输出速度。
- “比 Spark 快约 10%”的说法未经验证。 这是 MSI 与散热挂钩的营销数字;我们没有找到任何独立复现。
- DGX OS 是 Arm Linux,而不是 Windows。 这是一台 CUDA 开发专用设备。请按 Linux 工作流做好准备。
- 它比参考版 Spark 贵约 $1,000。 你付的钱买的是散热、存储和保修。请确认这些对你确实重要。
MSI EdgeXpert MS-C931 结论
MSI EdgeXpert MS-C931 是 GB10 Grace Blackwell 品类中一款可信、做工扎实的产品。128 GB 统一内存使它成为少数能在本地容纳并调优约 200B 参数模型的桌面机之一,ConnectX-7 互联架构让两台设备可以组成更大的集群,而均热板散热相比参考设计是一项确实用心的升级,尽管 MSI 给出的具体性能数字仍未经验证。
如果你是一名需要大内存本地推理的 AI 开发者,并且足够看重更强的散热、更快的存储和 3 年保修,愿意为此支付高于 NVIDIA DGX Spark 或 ASUS Ascent GX10 的溢价,那就买它。只是要清醒认识到 273 GB/s 的带宽上限:这台机器的意义在于容量,而不是独立旗舰 GPU 那样的原始每秒 token 速度。对合适的买家来说,这种取舍恰恰就是重点。